大数据测试,试试这个工具处理复杂实时数据流
在大数据驱动的时代,实时大数据数据处理需求日益增长,Apache Flink 是一个在流处理领域备受关注的开源框架。本文将全面介绍 Apache Flink,包括其架构、特性和多流拼接中的应用方式,帮助你了解 Flink 如何在实时数据处理中发挥重要作用。

一、什么是 Apache Flink ?
Apache Flink 是一个分布式流处理框架,支持对有界和无界数据流的快速处理。Flink 具备高吞吐量、低延迟的特点,并为开发者提供丰富的 API,以支持多种数据处理场景。
二、Flink 的核心概念
在深入 Flink 之前,我们需要了解一些核心概念:
1. 流(Stream):
数据在 Flink 中以流的形式存在,包括无界流(如传感器数据)和有界流(如历史日志文件)。
2. 数据流API(DataStream API):
Flink 的核心 API,用于处理实时数据流,用户可以通过该 API 创建和操作流。
3. 批处理(Batch):
Flink 也支持批处理,尽管它主要面向流处理。未处理的数据批会被视为有界流。
4. 状态管理:
Flink 提供强大的状态管理功能,支持在事件处理中保留状态,适用于复杂的事件处理场景。
5. 事件时间与处理时间:
Flink 支持基于事件时间的处理,能够在时间线上的任意位置处理事件,这对于处理延迟数据和乱序事件至关重要。
三、Flink 的架构
Flink 的架构主要由以下几个组件组成:
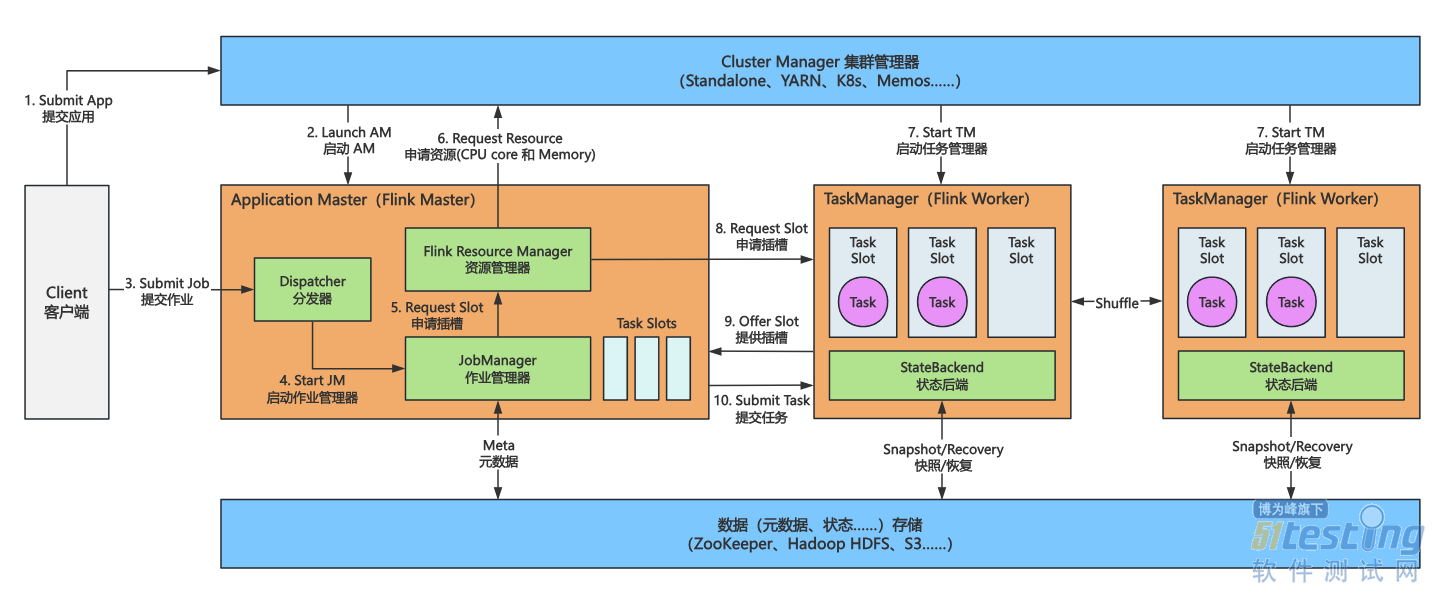
1. 任务管理器(Task Manager):
负责执行数据处理任务的工作节点。每个任务管理器可以并行处理多个任务。
2. 作业管理器(Job Manager):
负责协调和管理作业,包括任务的调度、资源管理等。
3. 分布式快照(Checkpointing):
Flink 提供的容错机制,通过定期创建分布式快照来保持数据处理状态。
4. 任务槽(Task Slot):
每个任务管理器中的执行资源单位,代表一个可以并行执行任务的容器。
四、Flink 的特性
1. 高吞吐量与低延迟
Flink 的设计目标之一是保证高吞吐量和低延迟,使之非常适合对实时数据流的处理,尤其是在金融服务、物联网等领域。
2. 精确一次语义
Flink 提供 "精确一次" 的数据处理语义,可以确保数据在处理过程中的一致性,避免重复处理或数据丢失。
3. 灵活的时间语义
Flink 的事件时间和处理时间功能,使得用户能够处理延迟和乱序的数据。用户可以基于事件生成时间戳,从而实现复杂的时间窗口操作。
可以到我的个人号:atstudy-js,可以免费领取一份10G软件测试工程师面试宝典文档资料。同时我邀请你进入我们的软件测试学习交流平台,大家可以一起探讨交流软件测试,共同学习软件测试技术、面试等软件测试方方面面,了解测试行业的最新趋势,助你快速进阶Python自动化测试/测试开发,稳住当前职位同时走向高薪之路。
4. 丰富的 API
Flink 提供了多种 API,包括 DataStream API、DataSet API 以及
SQL API,使得用户可以选择最适合的工具来进行数据处理。
5. 与大数据生态系统的无缝集成
Flink 可以与 Apache Kafka、Hadoop、Cassandra、Elasticsearch 等常见大数据技术无缝集成,为用户提供灵活的数据管道解决方案。
五、Flink 的应用场景
Apache Flink 适用于多种实时数据处理场景,包括但不限于:
1. 实时数据流分析:
例如,监控传感器数据流并实时生成可视化报告。
2. 事件驱动的应用程序:
处理来自不同来源的事件(如用户点击、设备状态变化等),并根据事件流驱动业务逻辑。
3. 实时机器学习:
可以在数据流中应用机器学习模型,实时预测和决策。
4. 复杂事件处理(CEP):
对数据流中的复杂事件模式进行检测和响应,例如金融欺诈检测。
六、结语
Apache Flink 是一种强大的流处理解决方案,因其高效、灵活和丰富的特性而受到广泛欢迎。随着实时数据处理需求的增加,Flink 的重要性将持续上升。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70034708/viewspace-3058789/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
物联网测试干货!一文入门物联网平台测试

请登录后发表评论
登录
全部评论
