有的时候,优化器显得很“白痴”,非得走一个性能很差劲的计划,这就是代价预估偏差导致的。
这次举例的case,就是优化器假设数据均匀分布,再加limit算子线性计算cost导致的预估偏差。
现象
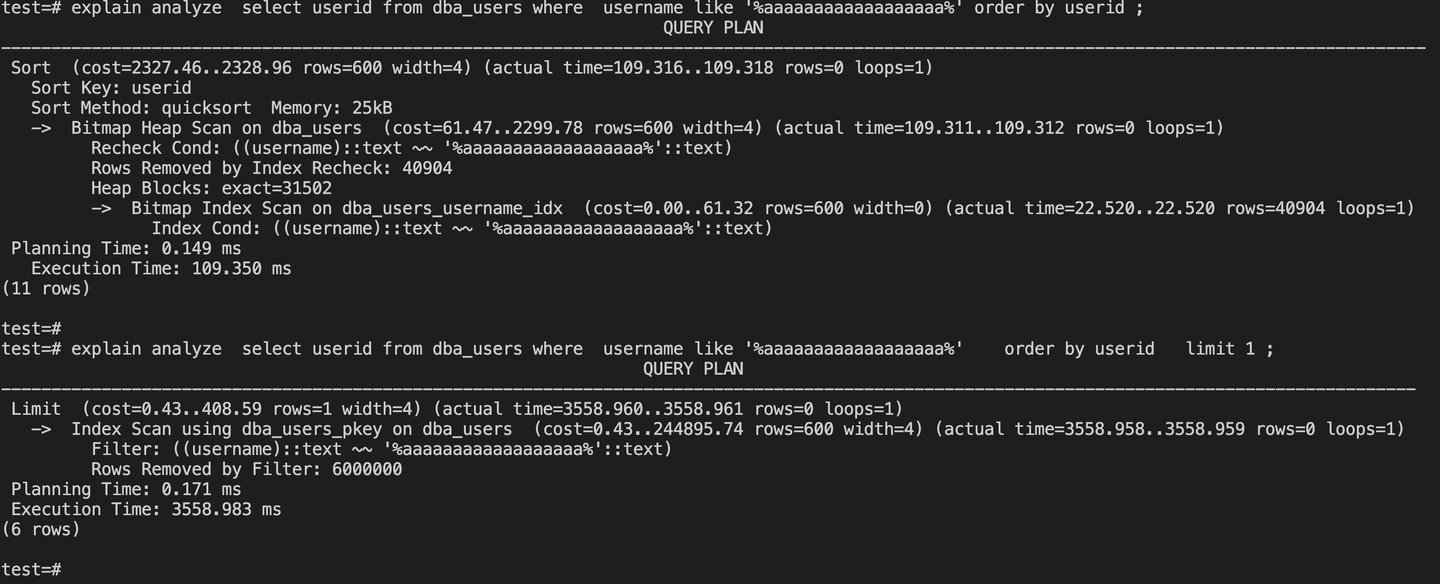
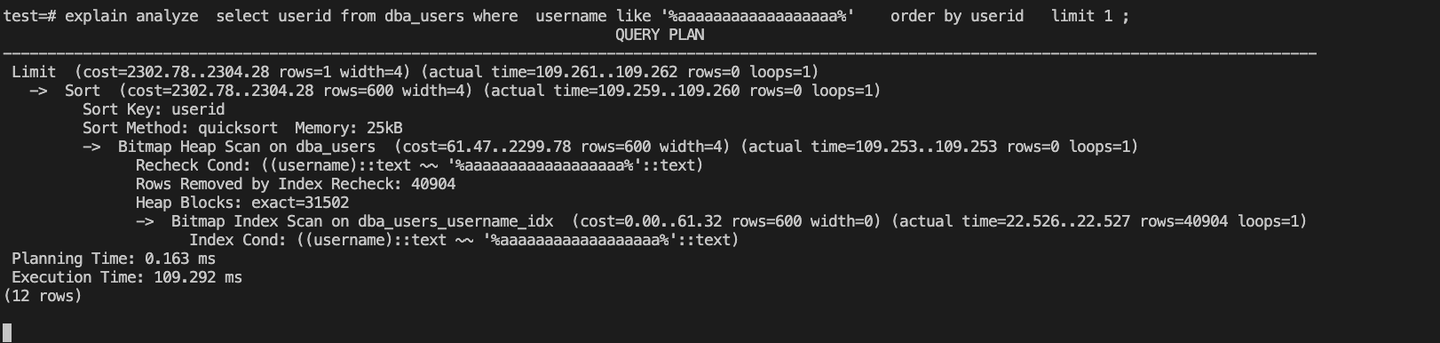
dba_users有600w条数据,username符合检索条件的0行, order by userid limit 1 耗时3558.983 ms,order by userid 耗时109.350 ms。
limit 1是匹配到第一条数据后就返回,这里却更慢了? 看起来不符合预期。
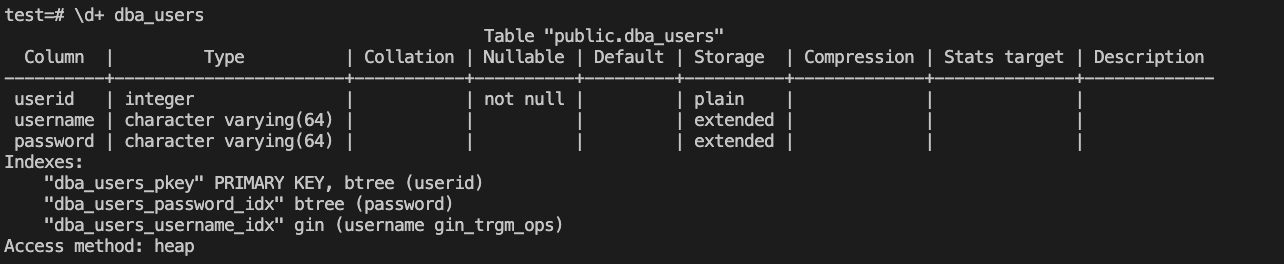
表结构如下:
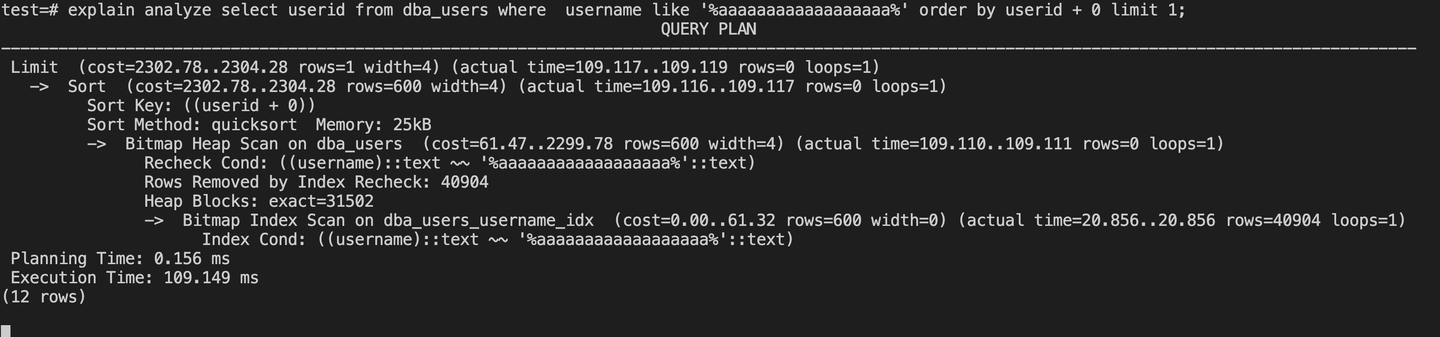
通常我们可以给order by字段做运算或者类型转换来矫正优化器走实际更优的执行计划。
或者order by字段和where字段建个组合索引? 多列统计信息?这些都是一些规避的方法,优化器自身为什么选择了不优的计划?
分析
这个问题一直被诟病,不少文章分析过很多场景,统计信息不准?索引损坏?数据分布问题?我们一起深入探索其中的奥秘。
PostgreSQL的优化器是自底向上生成执行计划,当查询小于12个表,使用的是动态规划算法,在每个计划节点执行各种可能的path和检索方法,然后计算出最小代价path作为最优解,也就是最终的执行计划。
DEBUG跟踪这个过程。
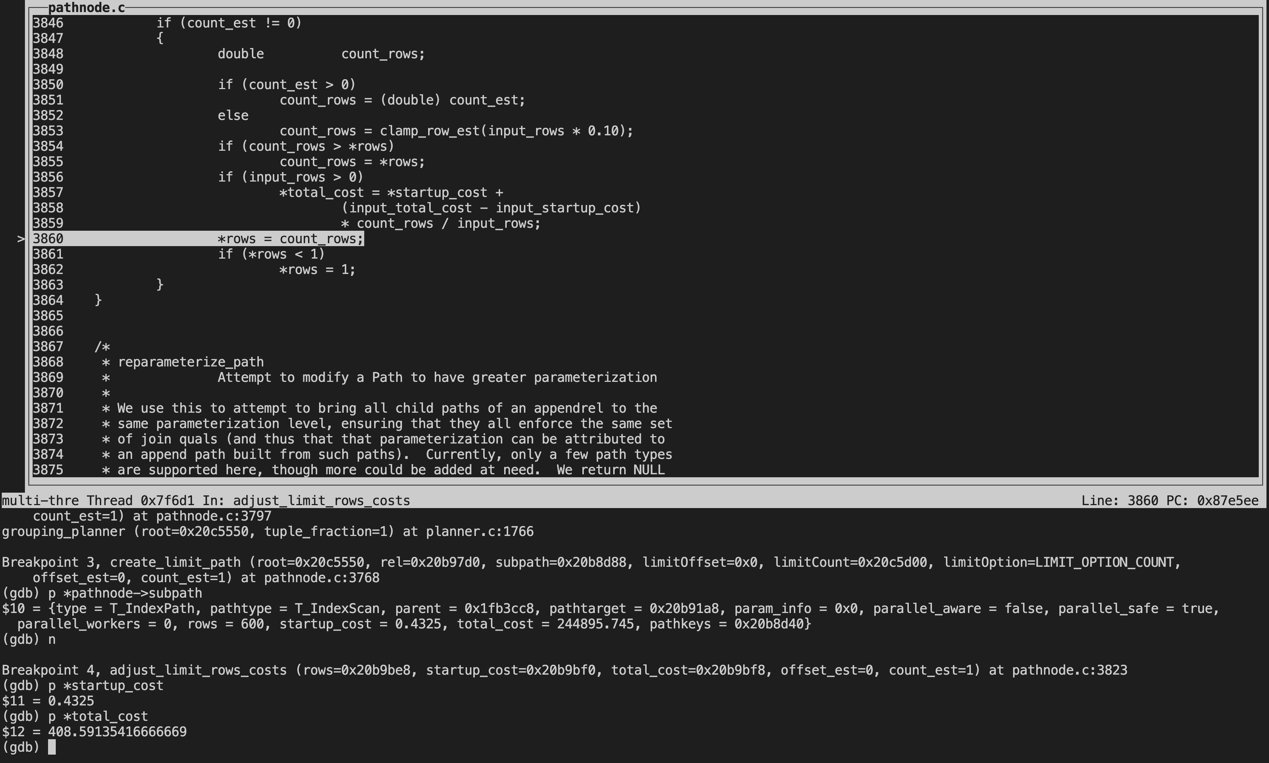
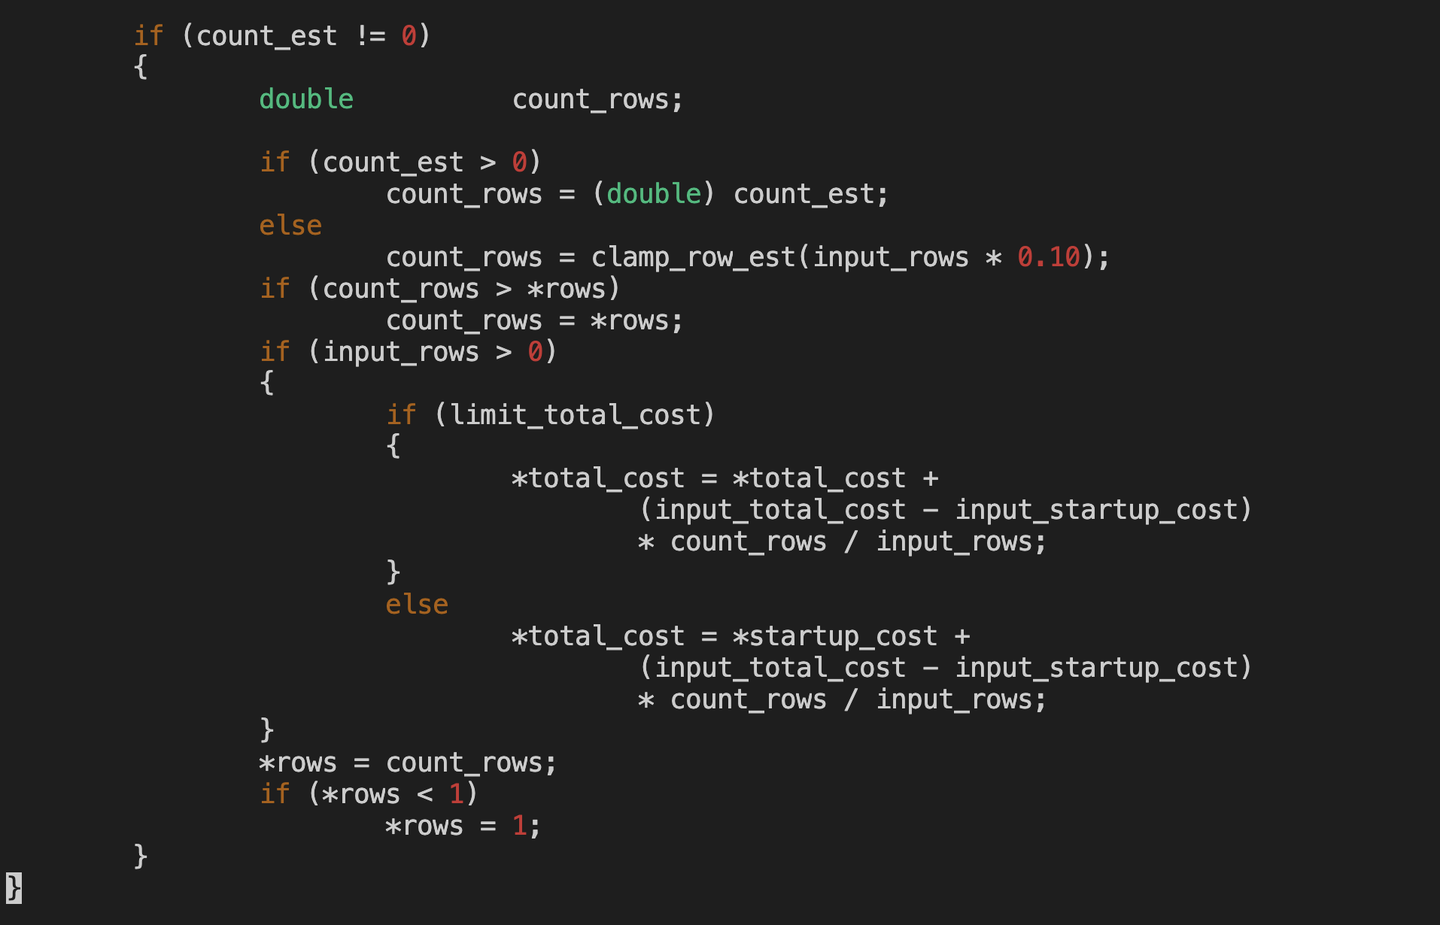
limit 的cost计算是在adjust_limit_rows_costs函数里进行的,根据上一节点subpath的startup_cost和total_cost计算出limit count后对应的cost
图片为例subpath是T_IndexPath, startup_cost=0.4325 total_cost=244895.745
limit 1对应的startup_cost=0.4325 total_cost= *startup_cost + (input_total_cost - input_startup_cost)* count_rows / input_rows;
= 0.4325 + (244895.745 - 0.4325 ) * 1/600
= 408.5913541666666667
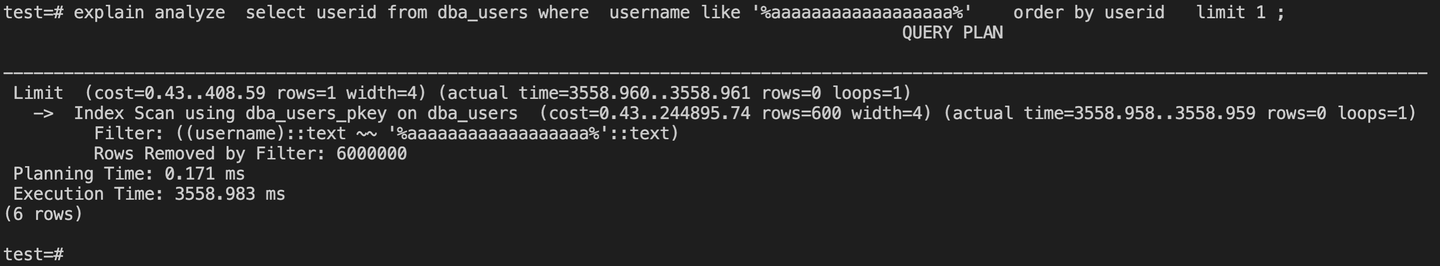
这个对应的是order by userid limit 1执行计划的cost:Limit (cost=0.43..408.59 rows=1 width=4)
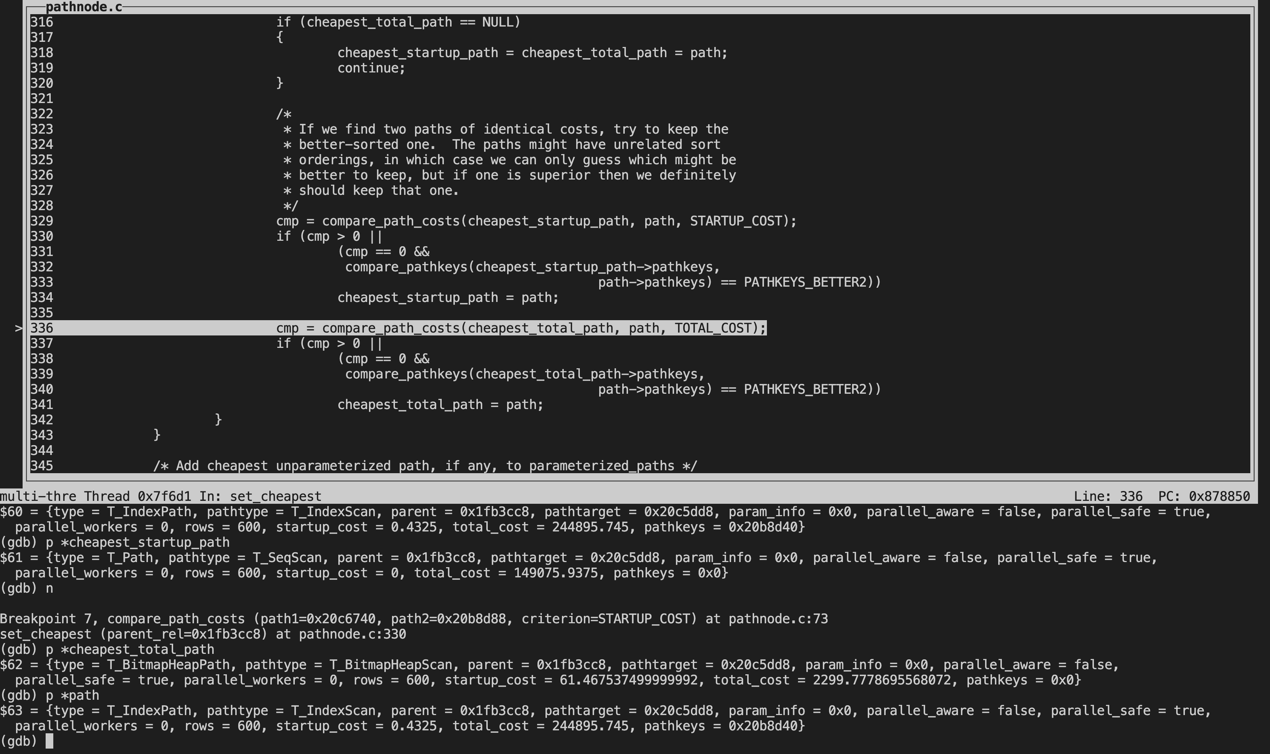
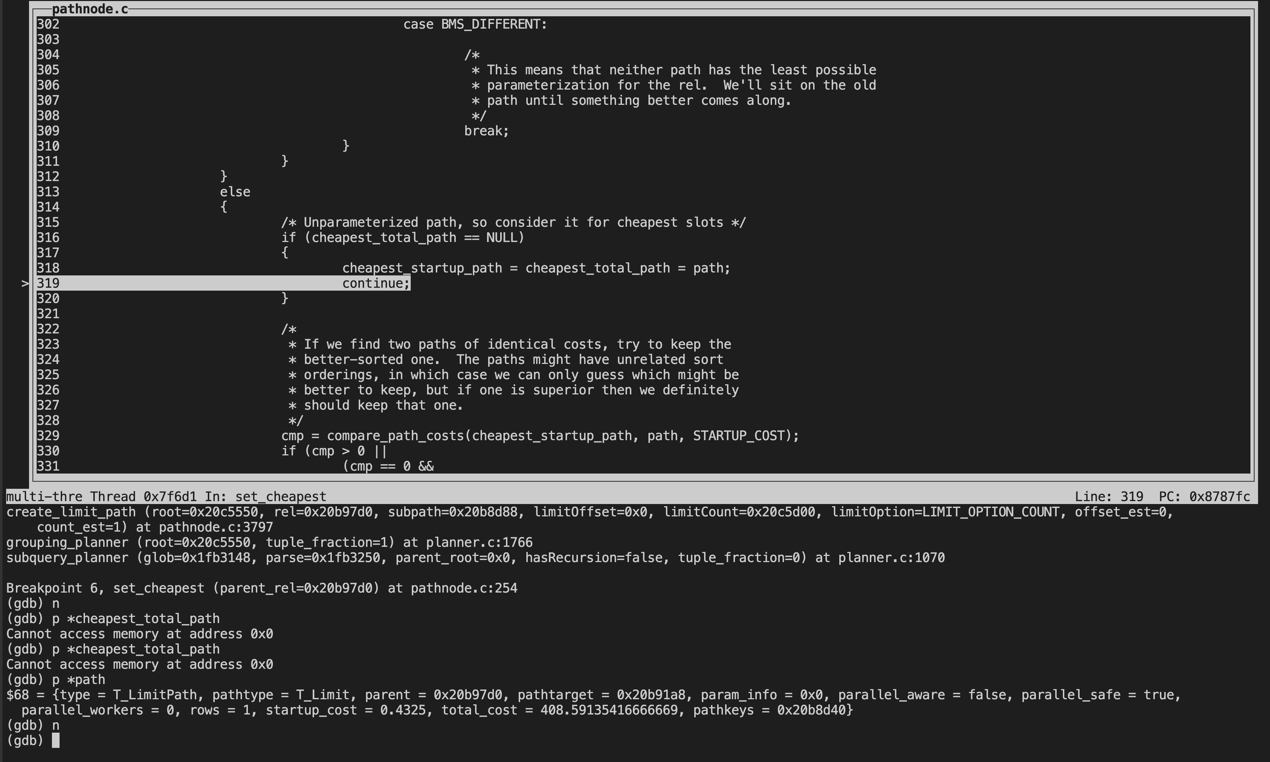
在set_cheapest里比较表扫描的最优方式,循环比较pathlist的每个节点的startup_cost和total_cost,
以下最优total_cost是T_BitmapHeapPath,最优startup_cost是T_seqScan
最终set_cheapest函数里一直角逐出Limit节点最优的startup_cost是0.4325,total_cost是408.59135416666669,这个对应到了order by userid Limit 1 这个plan的total_cost:Limit (cost=0.43..408.59 rows=1 width=4)
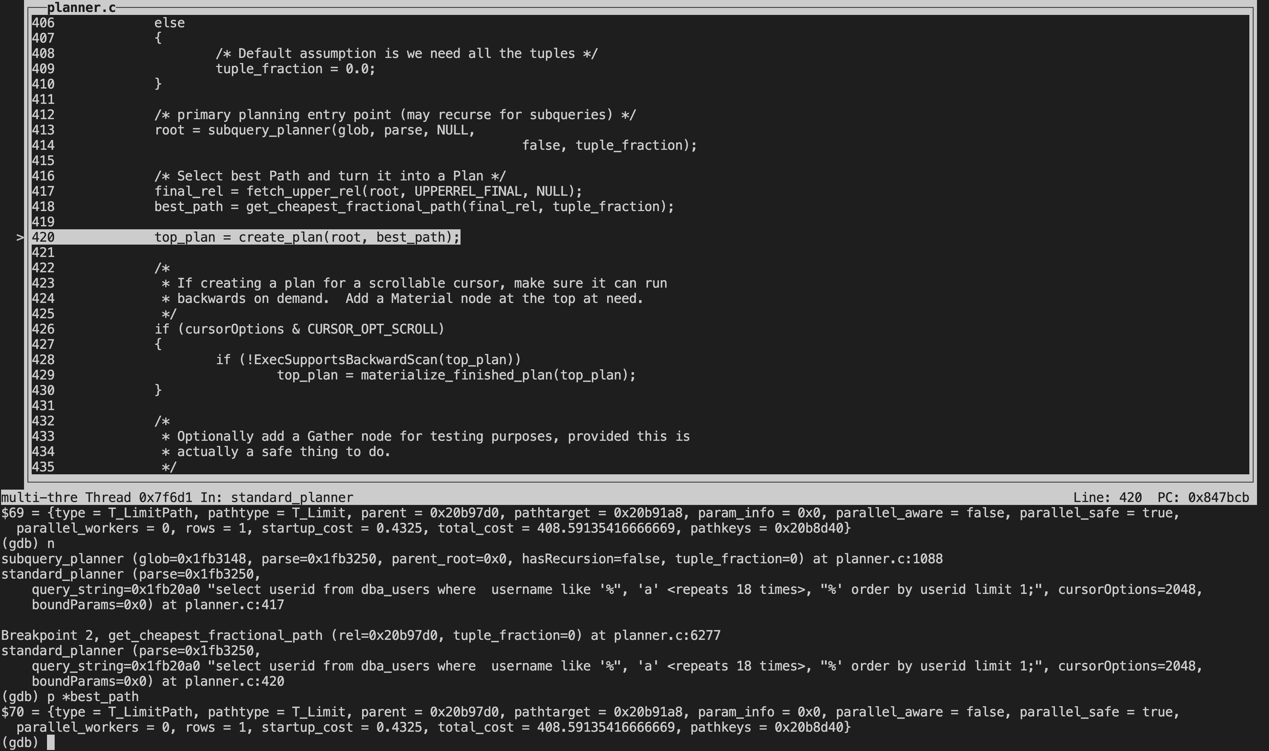
在get_cheapest_fractional_path函数里返回best_path 也就是以上total_cost=408.59135416666669的path,即order by userid Limit 1的plan。
那么从整个过程来看,我们需要关注的是整个计划节点的startup_cost和total_cost,优化器会选择最优total_cost的path作为best_path。
代价预估order by userid limit 1时,total_cost为:408.59(实际执行的total_time为:3558.961 ms)
预估order by userid + 0 limit 1时,total_cost为:2304.28(实际执行的total_time为:109.119 ms)
显而易见优化器选择了total_cost更小的408.59所在的path作为执行计划。
很明显代价预估有问题,我们开始就跟踪了order by userid limit 1的cost计算,计算的数值本身没有问题。
是优化器的缺陷?再把执行计划拉出来遛遛。
cost我们之前已经计算过了,但是从actual time来看,代价预估偏差还是比较大的,
cost
:Index Scan startup_cost=0.43 total_cost=244895.74 , limit startup_cost=0.43 total_cost=408.59
从预估来看因为没有offset 所以startup_cost都是0.43,根据公式计算的 limit 的total_cost=408.59,比244895.74小了很多。
actual: Index Scan startup_time=3558.958 total_time=3558.959,limit startup_time=3558.960 total_time=3558.961
从实际执行来看Index startup_time=3558.958 total_time=3558.959,索引扫描startup_time启动代价3558.958ms?
startup_time可以理解为扫描到第一条数据的时间,这里可以虽然走了userid的pkey索引,但是根据username like '%aaaaaaaaaaaaaaaaaa%' filter了600w行,就是说回表匹配了一遍所有行,因此耗时主要是在这里。
再看下limit 节点total_cost计算代价公式
*total_cost=*
startup_cost + (input_total_cost - input_startup_cost)* count_rows / input_rows
总代价 = 父节点启动代价 + (总代价 - 启动代价)即父节点运行代价 * limit 行数/ 预估输出的总行数
这里在where 条件不含排序字段走排序字段索引情况下,
有可能通过索引匹配到第一条符合条件的数据会比较久,
就是说要考虑索引扫描的整体代价作为limit的启动代价(当前默认逻辑是通过索引很快找到第一条数据,然后输出limit n行,因此整体cost在这个场景下是偏小的),最极端的场景很可能是先扫描了整个索引并且回表去匹配数据,这个cost要预估进去。因此这里的startup_cost 需要替换为total_cost, 计算公式可以调整为:
*total_cost=*
total_cost + (input_total_cost - input_startup_cost)* count_rows / input_rows
方案
当where 条件不含order by字段走order by字段索引不进行sort的情况下,flag(limit_total_cost)会置为true,这个时候就走新的计算逻辑。
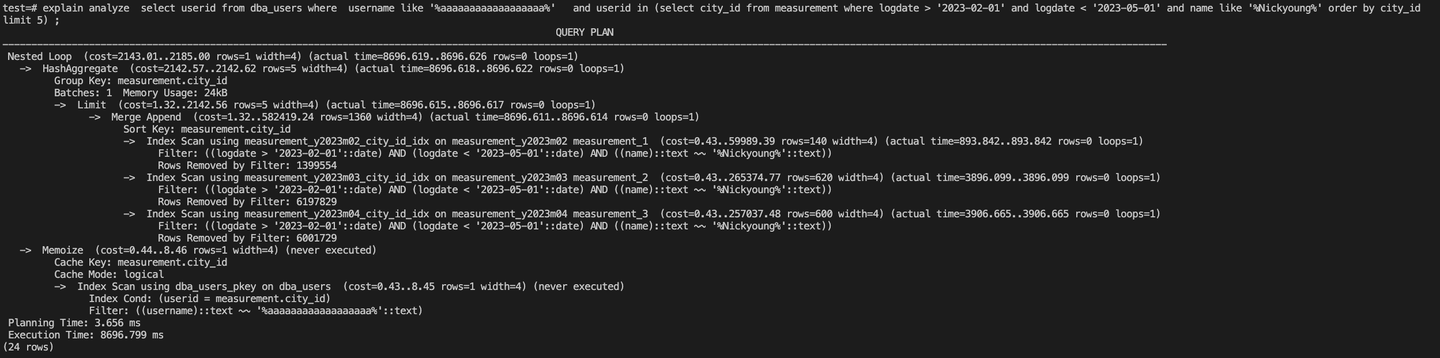
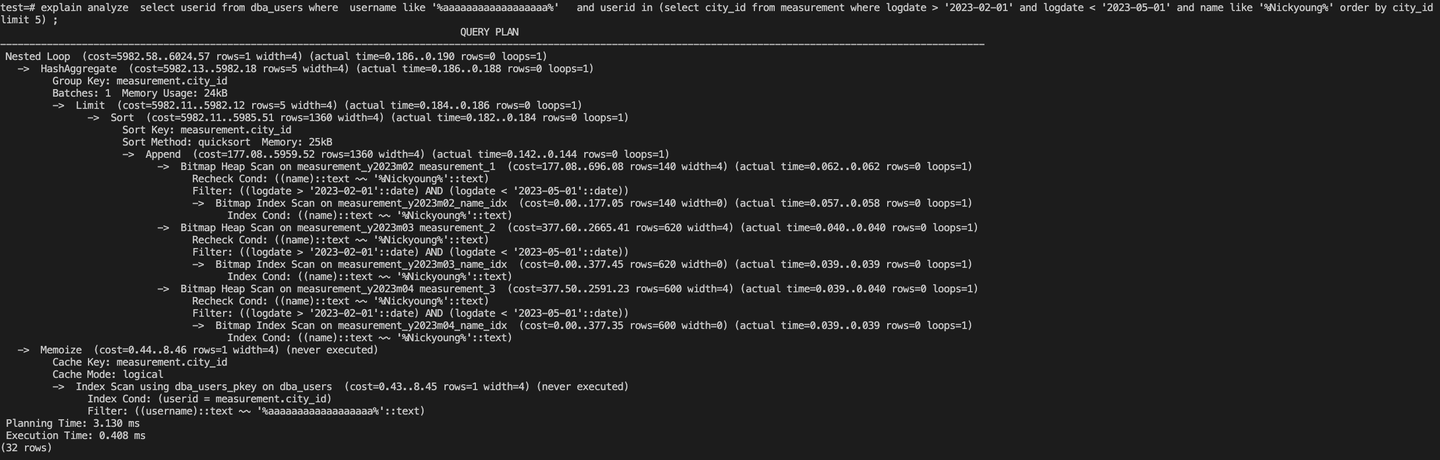
执行计划显示order by userid limit 1和之前order by userid +0 limit 1的执行计划相同,sql耗时符合预期。
也算牛刀小试修正了下limit的cost预估。不过这种修改方式看起来是不优雅不专业的,内核中可能有很多特例,我们不可能只是一股脑堆if else switch case逻辑。就像Linus说的,排除特例完美覆盖所有情况才是好的代码。
针对这个case,我认为优化器目前limit节点的cost计算逻辑需要加强,计算公式可能需要更复杂的关系因子,或者使用更合理的数学表达式。鄙人不才,还需持续学习积累。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70033867/viewspace-3107650/
,如需转载,请注明出处,否则将追究法律责任。