当心 Invalid Index,可能会导致 SQL 突然报错
一例由 invalid 索引引发的诡异 UPDATE 报错,从
_ccnew 索引到悬空 CTID 的完整排查。
关键词:Invalid Index、PostgreSQL 14、bottom-up index deletion、悬空 CTID、REINDEX CONCURRENTLY、amcheck 盲区、 _mdfd_getseg
TL;DR:一条普通的
UPDATE报出
could not open file ... previous segment is only N blocks,看起来像数据文件损坏,但
真正的根因不是 PG 内核 bug,而是用户侧的状态遗留——失败的
REINDEX CONCURRENTLY留下了一个
_ccnew后缀的 invalid 索引(
indisvalid=false / indisready=true),里面残留了指向已被
vacuum truncate截断的 heap block 的悬空 CTID。这种 invalid 索引残骸
在所有 PG 版本上都可能埋下雷。本文从报错现象出发,经过 8 轮推断与反证,最终通过 gdb 直接抓出凶手索引 OID,并用一行
DROP INDEX CONCURRENTLY修复。沿途揭示了
两个跨版本反直觉的事实:①
bt_index_check(heapallindexed=true)通过不能证明索引干净——它在所有 PG 版本上都会
直接跳过 invalid 索引;以及
PG14 特有的一个放大器:② PG14 的
indexUnchanged计算被一个 workaround 简化成
= update(
任何 UPDATE 都为 true,PG15 才真正修复),导致 bottom-up deletion 在 PG14 上几乎对所有 UPDATE 无条件激活,进而把"不在被改列里的 invalid 索引"也卷入悬空 CTID prefetch 路径,
让本就有问题的索引在 PG14 上更容易暴雷。
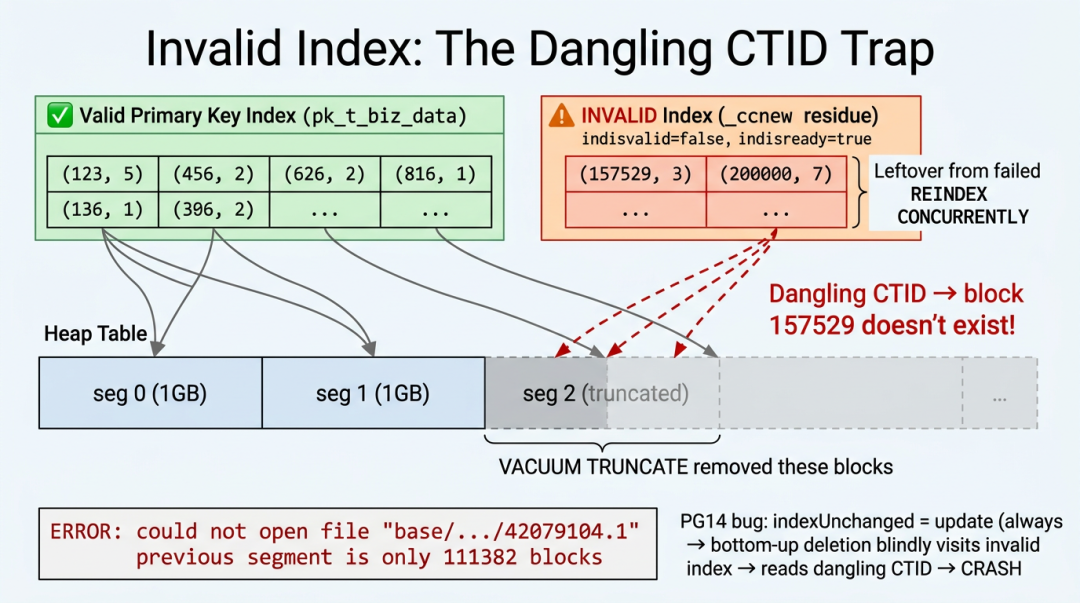
添加图片注释,不超过 140 字(可选)
一、问题现象
某 PostgreSQL 14.x 实例上,业务方反馈一条非常普通的 UPDATE 报错:
UPDATE app_schema.t_biz_data
   SET mtime = '1735689600000'::int8
 WHERE pk_id = 9024681357004299 AND org_id = 300471;
ERROR:  could not open file "base/38500067/42079104.1"
        (target block 157529): previous segment is only 111382 blocks
第一眼看到这种
previous segment is only N blocks 错误,几乎所有 PG 老手的反应都是"数据文件物理损坏 / 备份恢复不一致"。但在做完物理层检查后,事实开始反常:
$ ls -l base/38500067/42079104*
-rw------- 1 pg pg 912441344 Jun 16 16:23 base/38500067/42079104
-rw------- 1 pg pg    245760 Jun 13 00:45 base/38500067/42079104_fsm
-rw------- 1 pg pg     32768 Jun 13 00:45 base/38500067/42079104_vm
# 第 0 段大小 = 912441344 字节 = 111382 × 8192 个 block
# .1 段(即第 1 段)确实不存在
更诡异的是,
pg_class 系统目录里的元信息
完全正常:
SELECT relname, relkind, relfilenode, relpages, reltuples, relispartition
  FROM pg_class WHERE relfilenode = 42079104;
     relname     | relkind | relpages |  reltuples   | relispartition
-----------------+---------+----------+--------------+----------------
 t_biz_data_p001 |    r    |  111382  | 1.51e+06     |       t
pg_class.relpages = 111382 与磁盘文件实际大小
完全一致。这意味着:
-
❌ 不是物理文件被外部破坏(否则 relpages 不会跟磁盘同步)
-
❌ 不是 vacuum truncate 中途崩溃(中断的话 relpages 也对不上)
-
✅ PG 内核 自己就知道这张表只有 111382 个 block
那报错里说的"想访问 block 157529",
到底是从哪儿来的?
二、第一道分水岭:amcheck 检查通过
直觉指向"某个索引里残留了过时的 CTID"。先看 SQL 实际走的是哪条路径——
EXPLAIN 表明这条 UPDATE 走的是
主键索引扫描:
EXPLAIN UPDATE app_schema.t_biz_data
   SET mtime = '1735689600000'::int8
 WHERE pk_id = 9024681357004299 AND org_id = 300471;
QUERY PLAN
----------
 Update on t_biz_data
   Update on t_biz_data_p001
     ->  Index Scan using pk_biz_data_p001 on t_biz_data_p001
           Index Cond: ((org_id = 300471) AND (pk_id = '9024681357004299'::bigint))
既然走的是主键索引,第一嫌疑就是主键里残留了悬空 CTID。我们立刻用
amcheck 扩展对主键做完整性检查:
SELECT bt_index_check('pk_biz_data_p001', heapallindexed => true);
SELECT bt_index_parent_check('pk_biz_data_p001', heapallindexed => true);
 bt_index_check
----------------
(1 row)
主键索引完全通过,包括
heapallindexed=true 的高级检查(heap 中每条 visible tuple 都能在索引找到对应项)。
我们继续用一个反直觉的实验进一步排除索引嫌疑——用
pk_id + 0 强制走 Seq Scan 绕过索引:
EXPLAIN UPDATE app_schema.t_biz_data
   SET mtime = '1735689600000'::int8
 WHERE pk_id + 0 = 9024681357004299 AND org_id = 300471;
QUERY PLAN
----------
 Update on t_biz_data
   Update on t_biz_data_p001
   ->  Seq Scan on t_biz_data_p001
         Filter: ((org_id = 300471) AND ((pk_id + 0) = '9024681357004299'::bigint))
执行结果:
ERROR:  could not open file "base/38500067/42079104.1"
        (target block 157529): previous segment is only 111382 blocks
Seq Scan 路径仍然报同样的错,target block 仍是 157529。
走到这里,常见的几个候选根因都可以"看似排除":
-
✗ 索引悬空 CTID — amcheck 都通过了
-
✗ 走 Index Scan 触发 bottom-up deletion — Seq Scan 也报错
-
✗ FSM 与 heap 不一致 — FSM 推荐路径走的是 heap_update 写入侧,与 prefetch 不同调用链
但事实之后会证明,
前两条"看似排除"的判断都是错的——它们正是 PG14 内核里两个反直觉机制留下的诊断陷阱(FSM 那条判断本身正确,与本案无关)。
三、gdb 抓现场:决定性证据
既然 SQL 层面已经走不下去,直接上 gdb attach 到正在报错的 backend,断点打在
errfinish 或
_mdfd_getseg,复现 UPDATE,抓栈(
下面所有的源文件行号来自本案实例所用的 PG14.x 内核,与社区上游版本可能略有差异,但函数名、调用关系完全一致):
#0  _mdfd_getseg () at md.c:1214
#1  mdprefetch (reln=..., forknum=MAIN_FORKNUM, blocknum=157529) at md.c:565
#2  PrefetchSharedBuffer (smgr_reln=..., forkNum=MAIN_FORKNUM, blockNum=157529) at bufmgr.c:535
#3  index_delete_prefetch_buffer (rel=..., prefetch_state=..., prefetch_count=1) at heapam.c:7760
#4  heap_index_delete_tuples (rel=..., delstate=...) at heapam.c:7959
#5  table_index_delete_tuples (...)
#6  _bt_delitems_delete_check () at nbtpage.c:1541
#7  _bt_bottomupdel_pass (rel=..., buf=421337, heapRel=..., newitemsz=188) at nbtdedup.c:406
#8  _bt_delete_or_dedup_one_page () at nbtinsert.c:2763
调用链揭示了关键事实:报错来自 PG14 引入的
bottom-up index deletion 路径。这是个非常重要的转折点——说明索引层确实参与其中。
继续抓
index_delete_prefetch_buffer 帧的运行时数据:
(gdb) frame 3
(gdb) p prefetch_state->ndeltids
$ = 9
(gdb) p i
$ = 2
(gdb) p prefetch_state->deltids[i]
$ = {tid = {ip_blkid = {bi_hi = 2, bi_lo = 26457}, ip_posid = 3}, id = 30}
把 ItemPointer 解码成 BlockNumber:
BlockNumber = (bi_hi << 16) | bi_lo
            = (2 << 16) | 26457
            = 131072 + 26457
            = 157529   ★ 与报错完全一致
这条 ItemPointer 是从某个 b-tree 索引的 leaf 页里读出来的——索引里
确实残留了一条指向 block 157529 的悬空 CTID。amcheck 通过和 Seq Scan 报错那两条"反证"是怎么回事?暂时先按下,回到栈帧上溯找凶手索引:
(gdb) frame 7   _bt_bottomupdel_pass 帧
(gdb) p ((Relation)rel)->rd_id
$ = 42081573
(gdb) p ((Relation)rel)->rd_node
$ = {spcNode = 1663, dbNode = 38500067, relNode = 42081573}
回到 SQL:
SELECT 42081573::regclass;
                         regclass
-----------------------------------------------------------
 app_schema.idx_biz_multi_col_ccnew
凶手索引名字带着
_ccnew
后缀——这是个非常关键的信号。
四、_ccnew 后缀揭穿真相
PG 中索引名以
_ccnew 结尾,
只有一个来源:
REINDEX CONCURRENTLY 命令的中间产物。
REINDEX CONCURRENTLY 内部步骤(PG12+):
-
创建一个新索引(名字 = 原索引名 + _ccnew 后缀),与旧索引并行接受新插入
-
等所有老事务结束
-
完成后,把 _ccnew 改名为正式索引名,把旧索引改名为 _ccold,最后 drop 旧索引
-
任何一步失败 → 留下 _ccnew 索引处于 invalid 状态
我们立即查这个索引的状态:
SELECT c.oid, c.relname, i.indisvalid, i.indisready, i.indislive
  FROM pg_class c JOIN pg_index i ON c.oid = i.indexrelid
 WHERE c.oid = 42081573;
         relname              | indisvalid | indisready | indislive
------------------------------+------------+------------+-----------
 idx_biz_multi_col_ccnew      |     f      |     t      |     t
indisvalid=false / indisready=true / indislive=true——这是 invalid 状态的
_ccnew 索引的典型特征:
我们之前还跑过一次 amcheck 想检查这个索引:
SELECT bt_index_check('idx_biz_multi_col_ccnew', true);
ERROR:  cannot check index "idx_biz_multi_col_ccnew"
DETAIL:  Index is not valid.
amcheck 直接拒绝检查 invalid 索引——这一点意味着:即使我们后来想到要检查
_ccnew,也无法通过 amcheck 验证它的内部正确性,
它就是一个"无人能体检"的盲区。
回过头看,最初的判断错误其实更早:当时我们只对
主键跑了 amcheck,就以"主键通过"推论出"索引层没问题"。但表上不止主键一个索引,invalid 状态的
_ccnew 当时根本没被检查到——
主键 amcheck 通过 ≠ 表上所有索引都干净。把这两层叠加起来:
-
① 流程上的疏忽:第一次只对主键体检,漏了 _ccnew
-
② 工具的设计盲区:即使第一次想体检 _ccnew,amcheck 也会拒绝
这是一个"流程漏 + 工具盲"的双层陷阱,缺一个就不会变成本案这种"看似排查彻底实则放过真凶"的局面。
五、悬空 CTID 是怎么进入 _ccnew 的
至此故事的一半已经清楚——剩下的问题是:
为什么
_ccnew
索引里会有指向已被截断 block 的 CTID?
回到
REINDEX CONCURRENTLY 内部第 1 步的
index_concurrently_build 实现:在某个一致性快照下扫整个 heap,把现有 visible tuple 全部插入
_ccnew。
某次执行 REINDEX CONCURRENTLY 试图重建索引 idx_biz_multi_col:
  T0:创建空的 _ccnew 索引(OID=42081573, indisvalid=f, indisready=f)
  T1:index_concurrently_build 扫整张 heap
       此时 heap ≥ 157530 blocks(曾经更大)
       block 157529 上有一条业务 tuple → CTID (157529, 3) 写进 _ccnew leaf 页
  T2:标记 indisready=true,等老事务结束
  T3:第二次扫表追平 indisready=true 期间的并发变更
       并行:vacuum 在另一个进程运行,发现 heap 末尾大量空页
              触发 RelationTruncate,heap 缩到 111382 blocks
              vacuum truncate 不主动清理 invalid 索引
              _ccnew 中 (157529, 3) 这条 CTID 一直悬空
  T4:REINDEX CONCURRENTLY 失败(很可能就是因为撞上同一个错误)
  T5:_ccnew 索引被持续留下,处于 indisvalid=false / indisready=true 状态
这条因果链解释了所有反常之处:
-
✅ heap 干净( pg_class.relpages 与磁盘吻合)
-
✅ 主键索引干净(amcheck 通过)
-
✅ 出问题的是 invalid 的 _ccnew 副本索引(amcheck 跳过)
-
✅ 仍然在被写路径维护( indisready=true)
六、决定性细节:block 157529 怎么定位到 .1 文件
理解了"是哪个索引"之后,还要回答一个机制问题:报错里那个
previous segment is only 111382 blocks 的硬校验到底是怎么算出来的?
PG segment 文件的物理布局
PG 把每个 relation(heap/index)的主 fork 切成多个 1GB 的 segment 文件存储。文件命名规则:
      ← 第 0 段(block 0 ~ 131071)
.1    ← 第 1 段(block 131072 ~ 262143)
.2    ← 第 2 段(block 262144 ~ 393215)
...
.N    ← 第 N 段(block N×131072 ~ (N+1)×131072 - 1)
131072 这个数字来自编译时常量:
RELSEG_SIZE = 1 GB / BLCKSZ = 1073741824 / 8192 = 131072 blocks
_mdfd_getseg 的核心计算
PG 内核
src/backend/storage/smgr/md.c 里定位某个 block 在哪个段的核心一行:
targetseg = blkno / ((BlockNumber) RELSEG_SIZE);
代入 block 157529:
targetseg   = 157529 / 131072 = 1     ← 第 1 段
段内偏移    = 157529 % 131072 = 26457
所以:
-
目标段号 = 1 → 对应文件名后缀 .1 → base/38500067/42079104.1
-
段内 block 偏移 = 26457 → 在该文件内第 26457 个 block,字节偏移 26457 × 8192 = 216,793,088(≈ 207 MB)
数字上的有趣巧合
回到 gdb 抓到的 ItemPointer:
ip_blkid = {bi_hi = 2, bi_lo = 26457}, ip_posid = 3
注意
bi_hi << 16 计算出来的高位部分(
2 × 65536 = 131072)
正好等于一个 segment 的容量!但这只是数字上的巧合:
-
bi_hi/bi_lo 是 PG 把 32 位 BlockNumber 拆成两个 16 位字段存储(避免对齐问题)
-
segment 划分由 _mdfd_getseg 在 IO 层做
-
两者 没有任何机制上的关系,BlockNumber 仍是连续的全局编号
PG 强制要求"前段必须满 RELSEG_SIZE"
_mdfd_getseg 源码里关键的硬校验(位于一个 if/else if 链中,前一分支处理
EXTENSION_CREATE 写入扩展,本分支处理只读访问时遇到 size 异常的情况):
else if (!(behavior & EXTENSION_DONT_CHECK_SIZE) &&
         nblocks < ((BlockNumber) RELSEG_SIZE))
{
    /*
     * When not extending (or explicitly including truncated
     * segments), only open the next segment if the current one is
     * exactly RELSEG_SIZE.  If not (this branch), either return NULL
     * or fail.
     */
    if (behavior & EXTENSION_RETURN_NULL)
    {
        errno = ENOENT;
        return NULL;
    }
    ereport(ERROR,
            (errcode_for_file_access(),
             errmsg("could not open file \\"%s\\" (target block %u): "
                    "previous segment is only %u blocks",
                    _mdfd_segpath(reln, forknum, nextsegno),
                    blkno, nblocks)));
}
这个分支为何如此严格?同函数前一个分支(recovery / EXTENSION_CREATE 扩展路径)的注释把整个
_mdfd_getseg 共同遵守的不变量讲得很清楚:
We have to maintain the invariant that segments before the last active segment are of size RELSEG_SIZE; therefore, if extending, pad them out with zeroes if needed.
PG 内核
强制要求:除最后一段外,前面所有段必须正好 RELSEG_SIZE = 131072 blocks。这个不变量保证了从任意 block N 反推它在哪个段的计算永远是
N / RELSEG_SIZE,不需要去 stat 每个段文件实际大小。
如果出现"第 0 段只有 111382 blocks 但有人想访问 block 157529(理应在第 1 段)",PG 认为这是
数据库元数据严重不一致,宁可报错也不创建一个空洞的 .1 文件。
完整的"地址翻译链":
B-tree IndexTuple.t_tid 字节存储:
  ip_blkid.bi_hi = 0x0002        (2 字节)
  ip_blkid.bi_lo = 0x6759        (2 字节, = 26457)
  ip_posid       = 0x0003        (2 字节, slot 内位置)
              ↓ ItemPointerGetBlockNumber 解码
逻辑 BlockNumber = 157529
              ↓ _mdfd_getseg 段拆分
                  targetseg = 157529 / 131072 = 1
                  段内 blkno = 157529 % 131072 = 26457
              ↓ 物理文件定位
物理文件 = base/38500067/42079104.1
              ↓ PG 检查 "前一段必须满 RELSEG_SIZE"
                  发现第 0 段 = 111382 < 131072
              ↓
ereport(ERROR, "previous segment is only 111382 blocks")
七、反直觉机制:_ccnew 不含 mtime,为什么 update mtime 仍会触发它
最让人头疼的一个机制问题——出问题的
_ccnew 索引根本不包含
mtime 列:
\\d+ idx_biz_multi_col_ccnew
   Column   |          Type          | Key? | Definition
------------+------------------------+------+------------
 org_id     | bigint                 | yes  | org_id
 obj_id     | bigint                 | yes  | obj_id
 obj_name   | character varying(255) | yes  | obj_name
 ctime      | bigint                 | yes  | ctime
btree, for table "t_biz_data_p001", invalid
为什么
update mtime 这条语句会让 PG 去维护一个跟
mtime 无关的索引?
关键事实:HOT update 失败 → 所有 indisready 索引都要新增条目
PG 的 UPDATE 在写路径上有两种走法:
路径 A:HOT update (Heap-Only Tuple)
如果
被修改的所有列都不在任何索引上,且
原页有空间放新 tuple,PG 会走 HOT 优化:
-
不更新任何索引
-
新版本 tuple 通过堆内的 t_ctid chain 链接到旧版本
-
索引仍然指向旧版本,查询时通过 chain 找到新版本
但 HOT 的触发条件
极其苛刻——任何被任意一个索引覆盖的列被改,HOT 立刻失败。
路径 B:非 HOT update(本案的情况)
只要 HOT 失败,就走源码
heap_update() →
ExecUpdate → 关键的这一段(
src/backend/executor/execIndexing.c::ExecInsertIndexTuples):
List *
ExecInsertIndexTuples(ResultRelInfo *resultRelInfo,
                      TupleTableSlot *slot,
                      EState *estate,
                      bool update,           /* ← UPDATE 还是 INSERT */
                      bool noDupErr,
                      bool *specConflict,
                      List *arbiterIndexes)
{
    ...
    /* 遍历表上所有索引!没有"列是否被改"的过滤 */
    for (i = 0; i < numIndices; i++)
    {
        Relation    indexRelation = relationDescs[i];
        IndexInfo  *indexInfo;
        bool        indexUnchanged;
        ...
        if (indexRelation == NULL) continue;
        indexInfo = indexInfoArray[i];
        if (!indexInfo->ii_ReadyForInserts) continue;  /* 跳过没准备好的索引 */
        ...
        FormIndexDatum(indexInfo, slot, estate, values, isnull);
        /*
         * XXX We always assume that the hint should be passed for an UPDATE.
         * This is a workaround for a bug in PostgreSQL 14.  In practice this
         * won't make much difference for current users of the hint.
         */
        indexUnchanged = update;   /* ★ PG14 关键 bug workaround:直接等于 update */
        index_insert(indexRelation, values, isnull, tupleid, heapRelation,
                     checkUnique,
                     indexUnchanged,    /* ← 这个 flag 直接进 b-tree */
                     indexInfo);
    }
}
没有任何"被修改的列是否在这个索引中"的判断——只要索引
indisready=true(包括 invalid 的
_ccnew!),每条非 HOT UPDATE 都会给它插一个新的索引 entry。
为什么 PG 必须这么"无差别"地维护所有索引
因为 PG 的 MVCC 模型:
UPDATE 之前:
  heap tuple v1: ctid=(N, k)
  index1 entry: (key1, ctid=(N, k))
  index2 entry: (key2, ctid=(N, k))
UPDATE 之后(非 HOT):
  heap tuple v1: ctid=(N, k)        ← 旧版本仍存在(给老 snapshot 看)
  heap tuple v2: ctid=(N+1, m)      ← 新版本
  index1 entry: (key1, ctid=(N, k))     ← 旧的还在
  index1 entry: (key1, ctid=(N+1, m))   ← 新插入!即使 key1 没变
  index2 entry: (key2, ctid=(N, k))     ← 旧的还在
  index2 entry: (key2, ctid=(N+1, m))   ← 新插入!即使 key2 没变
每个版本的 heap tuple 都需要在每个索引里有对应的索引项指向它。否则一个事务从 index2 走索引扫描时,找不到 v2 的索引项就会漏读这个新版本——这是 MVCC 正确性的硬要求。
反直觉的真相:PG14 的 indexUnchanged 计算是个 bug workaround
PG14 在
index_insert 调用时新增了
indexUnchanged 提示参数,本意是:
如果某个索引覆盖的所有列都没变,就把这个提示传给 b-tree,让它知道"新插入的索引项很可能是 dup,可以激进做 bottom-up deletion"。
但翻开 PG14.15 真实源码(
execIndexing.c:409),这条本应"按列精细判断"的逻辑被简化成了一行:
indexUnchanged = update;
注释里上游开发者明确写道:"This is a workaround for a bug in PostgreSQL 14"——意思是 PG14 中这条优化的精细判定有 bug,作为权宜之计
直接对所有 UPDATE 一律传
true。
直到
PG15 才真正修复,引入
index_unchanged_by_update() 做按列精细判断:
/* PG15+ 的正确实现 */
indexUnchanged = update && index_unchanged_by_update(resultRelInfo, ...);
这个细节解释了
本案最反直觉的部分:
/* nbtinsert.c::_bt_delete_or_dedup_one_page */
if ((indexUnchanged || uniquedup) &&
    _bt_bottomupdel_pass(rel, buffer, heapRel, insertstate->itemsz))
    return;
在 PG14 里,
任何 UPDATE 写入任何 b-tree 索引时
indexUnchanged
都是 true——这意味着只要这条索引页接近满,bottom-up deletion 路径就
几乎无条件激活。"反直觉"不在于"被改列不在索引里反而触发",而在于:
PG14 把按列精细判断"workaround 掉"了,所有 UPDATE 都激活这条 prefetch 路径。
这就是本案触发链最后的临门一脚:
update mtime  (走非 HOT,因为 mtime 在表上某个其他索引里)
   ↓
ExecInsertIndexTuples 遍历所有 indisready=true 索引
   ↓
对 _ccnew (indisvalid=false 但 indisready=true) 也调用 index_insert
   ↓
indexUnchanged = update = true  (PG14 bug workaround:所有 UPDATE 都为 true)
   ↓
btinsert → _bt_doinsert → 找目标 leaf 页发现页快满
   ↓
_bt_delete_or_dedup_one_page: if (indexUnchanged || uniquedup) ... ★ 命中!
   ↓
_bt_bottomupdel_pass(rel=_ccnew, buf=421337, heapRel, ...)
   ↓ 收集 leaf 页 9 条候选 ItemPointer 进 deltids[]
   ↓ 第 2 条恰好是 (157529, 3) 悬空 CTID
table_index_delete_tuples → heap_index_delete_tuples
   ↓
index_delete_prefetch_buffer → PrefetchBuffer(heapRel, MAIN_FORKNUM, 157529)
   ↓
mdprefetch → _mdfd_getseg
   ↓
ereport(ERROR): previous segment is only 111382 blocks
最反直觉的事实:PG14 的设计原本想用
indexUnchanged 做精细优化,但 workaround 把所有 UPDATE 一刀切传 true,反而让 bottom-up deletion 在 PG14 的触发频率
远高于 PG15+。这是个"优化 flag 退化为强制开关"的特殊版本现象——也是为什么 invalid 索引悬空 CTID 在 PG14 上
更容易被触发的根本机制原因。
为什么是"突然"报错——同一个 _ccnew 残骸为什么之前没事
读到这里有个自然的问题:这个
_ccnew 索引可能已经在表上躺了好几个月了,业务一直在 UPDATE,
为什么偏偏今天这条 UPDATE 才爆?
严格回答:bottom-up deletion 在每次进入时会
一次性收集当前 leaf 页的全部有效 ItemPointer(你看到的
ndeltids=9 就是该 leaf 页的全集),一旦进入路径,必然会撞上其中的悬空 CTID。所以"突然"的关键不在收集是否撞,而在
何时第一次进入
_bt_bottomupdel_pass——也就是何时第一次满足下列
全部条件:
-
UPDATE 走 非 HOT 路径(被改列在表上某个索引里,HOT 优化失败)
-
该非 HOT update 在写入侧 ExecInsertIndexTuples 遍历到 _ccnew 索引(因为 indisready=true,必维护)
-
写入 _ccnew 时找到的目标 leaf 页快满,进入 _bt_delete_or_dedup_one_page
-
indexUnchanged=true(PG14 中所有 UPDATE 都满足;PG15+ 仅当被改列不在该索引时满足)或 uniquedup=true
-
这次访问的 leaf 页 正好是含悬空 CTID 的那几个 leaf 页之一
5 条
同时成立才会爆。任何一条不满足,UPDATE 都安然通过——这就解释了三件事:
-
为什么之前没事:之前的 UPDATE 可能是 HOT、可能写到了未满的 leaf 页、可能写到了不含悬空 CTID 的 leaf 页
-
为什么是"突然"爆:业务键分布决定了哪些行的 UPDATE 会路由到含悬空 CTID 的 leaf 页;今天这条 UPDATE 的 pk_id + org_id 正好命中了这个组合
-
为什么报错很"挑"行:同一张表上,有些 pk_id 能 update、有些不能,按业务键看是"零散"分布——这正是 invalid 索引悬空 CTID 故障的典型特征
更进一步:在 PG14 之前的版本里, _bt_bottomupdel_pass 这个函数 根本不存在(PG14 引入),上述触发链条第 3 步永远不可能进入——同一份 invalid 索引在 PG13 上 永远不会暴露这个错误,悬空 CTID 长期沉睡无症状。 升级到 PG14 之后,原本无害的"陈年残骸"才变成了雷。叠加 PG14 上 indexUnchanged workaround 的"一刀切传 true"特性,PG14 是这一类问题的 最高风险版本——PG15+ 修复了 workaround、按列精细判断后,相同 invalid 索引被触发的概率会显著下降,但 不为零(仍可被 unique dup 路径触发)。
八、修复:一行命令
既然出问题的是失败的 REINDEX CONCURRENTLY 留下的孤儿索引,
根本不需要 REINDEX 整个表,直接 DROP 它就行:
DROP INDEX CONCURRENTLY app_schema.idx_biz_multi_col_ccnew;
执行后立即验证:
BEGIN;
UPDATE app_schema.t_biz_data
   SET mtime = '1735689600000'::int8
 WHERE pk_id + 0 = 9024681357004299 AND org_id = 300471;
-- UPDATE 1
ROLLBACK;
UPDATE 1 一次成功——闭环。
九、扫尾:全库 Invalid Index 普查 —— 不止一个分区会爆
这种
_ccnew 残骸
很可能不止一个分区——如果之前的批量 reindex 是对所有分区执行的,每个分区都有自己的
_ccnew 候选;按业务键分布,每个分区里又有若干个含悬空 CTID 的 leaf 页等待被命中。
每一个
_ccnew
残骸都是一颗等待引爆的雷,是否引爆只取决于业务何时 UPDATE 到对应行。强烈建议做一次全库普查:
-- 1. 全库扫所有 invalid 索引
SELECT n.nspname || '.' || c.relname AS index_name,
       i.indrelid::regclass AS table_name,
       pg_size_pretty(pg_relation_size(c.oid)) AS size,
       i.indisvalid, i.indisready, i.indislive
FROM pg_index i
JOIN pg_class c ON c.oid = i.indexrelid
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE NOT i.indisvalid
  AND n.nspname NOT IN ('pg_catalog', 'information_schema', 'pg_toast')
ORDER BY n.nspname, c.relname;
-- 2. 如果出现多个 _ccnew/_ccold 索引,批量生成 DROP 命令
SELECT 'DROP INDEX CONCURRENTLY ' || n.nspname || '.' || c.relname || ';' AS drop_cmd
FROM pg_index i
JOIN pg_class c ON c.oid = i.indexrelid
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE NOT i.indisvalid
  AND (c.relname LIKE '%\\_ccnew%' ESCAPE '\\' OR c.relname LIKE '%\\_ccold%' ESCAPE '\\')
ORDER BY n.nspname, c.relname;
十、总结:四条值得记住的诊断教训
整轮排查从一条 UPDATE 报错出发,经过 8 轮推断与反证,最终落到 OID 级别的精确定位 + 一行 SQL 修复。沉淀的几条
可复用诊断教训:
教训 1:bt_index_check(heapallindexed=true) 通过 ≠ 索引干净
这条函数有两个常被忽略的盲区:
-
会跳过 indisvalid=false 的索引:直接报 cannot check ... Index is not valid 后中断。失败的 _ccnew / _ccold 残骸是它的天然盲区
-
只校验 heap → index 方向:检查"每个 visible heap tuple 都能在索引找到对应项"。 不主动 ReadBuffer 验证 index → heap 方向每条 CTID 是否指向有效 block
所以"主键 amcheck 通过"完全不能推论"表上所有索引都干净"。
教训 2:Seq Scan 报错 ≠ 不是索引问题
UPDATE 即使读路径走 Seq Scan,写路径仍要
ExecInsertIndexTuples
无差别地维护所有
indisready=true
的索引(包括 invalid 的
_ccnew/
_ccold 残骸)。bottom-up deletion 的触发条件是"索引页快满",与扫描路径无关。
教训 3:gdb 上 Relation 参数语义要看清
heap_index_delete_tuples(Relation rel, ...) 第一个参数是
heapRel,不是 indexRel。要拿凶手 indexRel 必须回到
_bt_bottomupdel_pass 帧(栈帧 #7):
(gdb) frame 7
(gdb) p ((Relation)rel)->rd_id
$ = 42081573
再回 SQL 用
42081573::regclass 反查名字——这是从 gdb 现场到具体索引名最快的路径。
教训 4:PG14 的 indexUnchanged 是个 bug workaround
按设计意图,
indexUnchanged=true 应该只在"被改列都不在该索引"时设置,作为给 b-tree 的一个 hint,让它激进做 bottom-up deletion 优化。但 PG14(包括到 PG14.x 末位版本)实际实现是
indexUnchanged = update——
只要是 UPDATE 就一律传 true,注释明说这是 "PostgreSQL 14 的一个 bug 的 workaround"。这意味着在 PG14 上,
任何 UPDATE 写入任何 b-tree 索引时,只要索引页快满,就几乎无条件触发 bottom-up deletion。这条 workaround 在 PG15 才被
index_unchanged_by_update() 正式替换——所以同样一份 invalid 索引,
PG14 是高危版本,PG15+ 风险显著降低但不为零。
修复版本边界(重要):这条 workaround 仅在 PG15.0+ 修复,没有 backport 到 PG14 任何小版本。已确认 PG14.15 仍保留 indexUnchanged = update; 一刀切实现——也就是说 PG14 整个生命周期(直到官方 EOL)都不会修复这条 workaround,任何 PG14.x 实例都和本案同等高危。 关于"是不是 bug"的严格定性:本案是多个非 bug 的设计选择 + 一个被上游承认的 PG14 bug 在特定时序下叠加触发—— REINDEX CONCURRENTLY 失败留下 invalid 索引、vacuum truncate 不清理 invalid 索引、 _mdfd_getseg 撞墙就 ereport(ERROR) 都是设计选择,社区不打算"修复";只有 indexUnchanged = update 这一项被上游注释明确自陈为 PG14 bug,且仅 PG15+ 修复。运维上 唯一可靠的防御是主动清理 invalid 索引,不能依赖任何上游修复。 PG15+ 仍会触发的场景:本案被改列 mtime 不在出问题的 _ccnew(org_id, obj_id, obj_name, ctime) 4 列内,所以 PG15 的 index_unchanged_by_update() 按列判断结果仍为 true——意味着在 PG15+ 实例上 同样这条 UPDATE 仍会复现报错。PG15 真正豁免的是"改的列正好在该索引列内"那一类 UPDATE;本案这种"改索引列外字段"的场景,PG15+ 触发概率与 PG14 等同。
后记:PG14 的特殊风险窗口
PG14 引入的 bottom-up deletion 是个非常出色的优化——它通过主动按索引项 CTID prefetch heap 来批量回收"指向同一死 tuple 的多个索引项",显著降低写密集场景下索引膨胀。但作为代价,它
会主动按索引项 CTID 去访问 heap 物理页,与历史遗留的悬空 CTID 撞在一起才暴露。
更关键的是,本案在第七节揭示的 PG14
indexUnchanged workaround——上游为了规避一个 bug,把"按列精细判断索引是否未变"的优化简化为"所有 UPDATE 一律传 true"——让 bottom-up deletion 在 PG14 几乎成了"任何 UPDATE 写入页快满索引时的标配触发器"。这条 workaround
直到 PG15 才被正式修复(PG15+ 的
index_unchanged_by_update() 真正按列判断),所以同样一份 invalid 索引:
在更早的 PG 版本里,这些悬空 CTID 长期沉睡无症状;升级到 PG14 后,原本无害的"陈年残骸"变成了隐患;升到 PG15+ 后部分缓解但
仍不能彻底排除风险。如果你的实例有过:
-
失败的 REINDEX CONCURRENTLY 历史
-
物理备份恢复后没有清理过 _ccnew/_ccold 残骸
-
跨大版本升级(特别是从 PG13 之前升级上来)
强烈建议跑一次本文第九节的"全库 Invalid Index 普查"——把那些可能定时爆炸的
_ccnew /
_ccold 孤儿索引先清扫一遍。
问题本身并不可怕,可怕的是你不知道自己的实例里到底躺着多少颗这样的雷,以及它们何时会被业务 UPDATE 命中。如果跑完没有发现 invalid 索引,可以暂时安心;如果发现一坨,按本文第八节一行
DROP INDEX CONCURRENTLY 逐个清理即可,不需要更激进的处理。
本文记录的是真实生产实例的诊断过程,所有表名、索引名、业务字段名、OID、relfilenode、buffer ID、文件路径、业务数据值均已脱敏,仅保留 BlockNumber、RELSEG_SIZE、字节计算等公开内核常量级数据,以便读者可以独立复现推导链条。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70033867/viewspace-3174765/ ,如需转载,请注明出处,否则将追究法律责任。
下一篇:
没有了~

请登录后发表评论
登录
全部评论
