YashanDB ALTER TABLE语句
通用描述
ALTER TABLE用于修改数据库里的表的结构和定义,以及对表进行相关管理操作,包括:
- 表更名
- 修改列
- 修改分区
- 修改约束
- 开启和关闭行迁移( row movment)
- 开启和关闭附加日志( supplemental logging)
- 开启和关闭redo日志( nologging)
- 空间收缩( shrink space)
- LSC表的后台数据转换选项开关( data transformer)
- LSC表的可变数据生命周期( MCOL time to live)
- LSC表开启或关闭MCOL功能 ( MCOL ability)
- LSC表的强制转换( force xfmr)
其中,依据LSC表的存储特性,只能对其分区相关属性(但不包括分区索引)进行修改操作(包括增加分区和删除分区等)。
不能对 AC对象以及AC对象的源表执行ALTER TABLE操作。
#语句定义
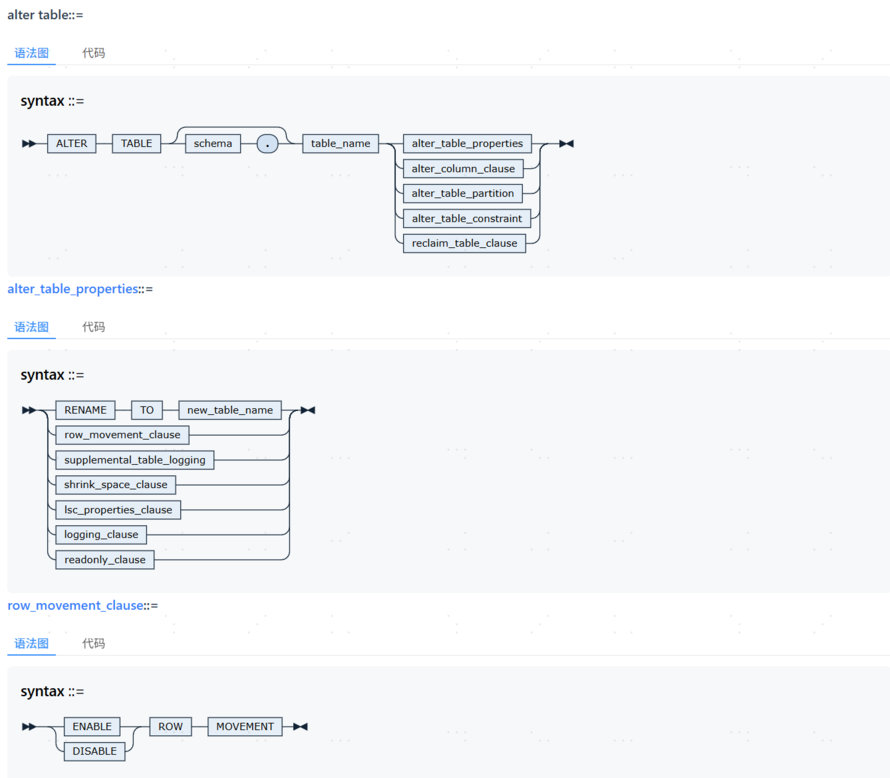
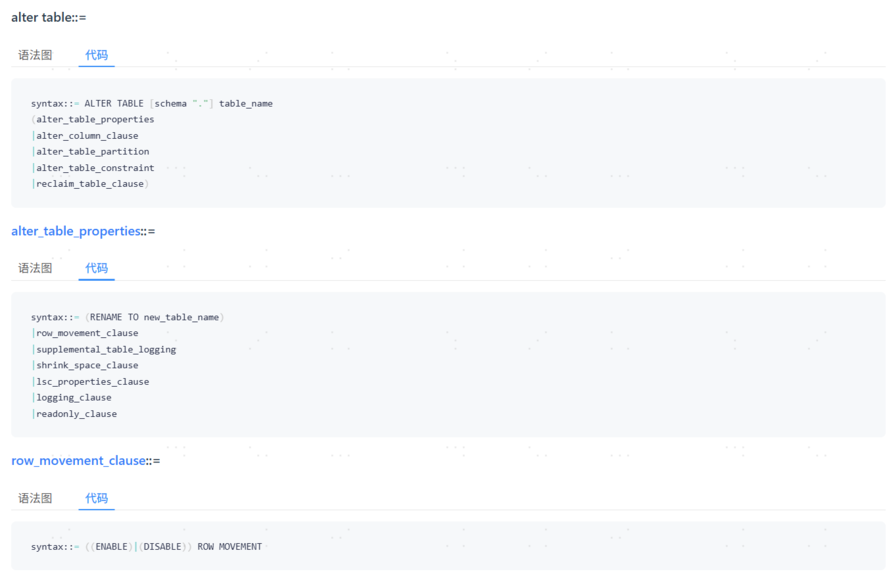




alter_table_properties
该语句用于修改表的一系列属性。
#rename to
该语句用于修改表名,指定的新名称不能为空且必须符合YashanDB的 对象命名规范。
示例
#row_movement_clause
该语句用于开启或关闭表的行迁移功能,参考 CREATE TABLE中相应功能描述。
示例(单机HEAP表、单机TAC表)
示例(分布式TAC表)
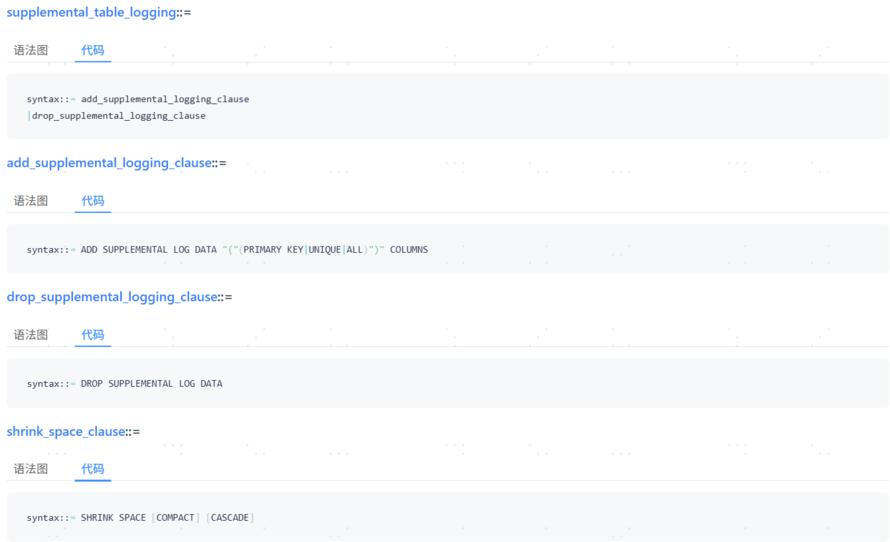
#supplemental_table_logging
该语句用于开启或关闭表级附加日志属性。表级附加日志只对当前的表生效,数据库级附加日志请参考 ALTER DATABASE。
分布式部署中用户无法执行此操作。
#add_supplemental_logging_clause
该语句用于为该表开启附加日志属性,开启附加日志后,对该表执行DML或DDL类型语句,将会在redo日志里记录额外的信息,以便逻辑日志解析工具能从redo日志里解析出DML和DDL语句。尤其是UPDATE和DELETE语句,会额外记录目标行的主键,唯一键或整行(除LOB列)数据到redo日志里,因此对数据库性能有影响。
附加日志有三种类型:
- PRIMARY KEY:在UPDATE,DELETE的redo日志中,仅记录该行的主键列的值。
- UNIQUE:在UPDATE,DELETE的redo日志中,仅记录该行的非空的唯一索引列的值。
- ALL:在UPDATE,DELETE的redo日志中,记录该行的所有列(LOB型,32K以上varchar和char等除外)的值。
附加日志约束项:
- 不能对已开启附加日志的表重复执行ADD SUPPLEMENTAL LOG操作。
- 不能对附加日志类型为PRIMARY KEY或UNIQUE的表,删除附加日志依赖的索引列。
- 不能对没有主键的表开启PRIMARY KEY类型的附加日志。
- 不能对没有非空唯一索引列的表开启UNIQUE类型的附加日志。
- 不能对唯一索引列开启了 加密的表开启UNIQUE类型的附加日志。
- 不能对使用了字典编码的TAC表开启附加日志。
- 不能对开启附加日志的表,执行长度超过32K的DDL语句。
通过 DBA_LOG_GROUPS、 ALL_LOG_GROUPS、 USER_LOG_GROUPS视图可以查看当前已开启的附加日志信息。
示例(单机部署)
#drop_supplemental_logging_clause
该语句用于关闭表上的附加日志属性。
示例(单机部署)
#shrink_space_clause
该语句用于对表或分区进行收缩,使得数据存储更加紧凑,降低segment的高水位线,释放空闲出来的连续的extent。
该语句仅适用于单机HEAP表。
由于收缩数据涉及到物理位置变更,执行本操作前必须开启行迁移,具体操作请查阅 row_movement_clause。
COMPACT
指定此关键字表示只将数据存储紧凑,降低水位线,并不释放空出来的extent。
CASCADE
指定此关键字表示在收缩表的同时,对其上索引也进行收缩,仅用于语法兼容,无实际意义。
示例(单机HEAP表)
#lsc_properties_clause
该语句只用于修改LSC表的相关属性,对其他类型表执行这些修改将会报错。
#enable_xfmr_clause
该语句用于控制LSC表的后台数据转换能力。
目前的YashanDB后台提供给LSC表如下数据转换能力:
- TRANSFORM:LSC的可变数据依据此开关转换为稳态数据存储,可变数据缓冲区的数据被转换,转移到稳态数据内。关闭此开关即不再允许自动转换。需要注意,如果一直不转换,数据将一直存放在可变数据区,无法对数据存储格式进行优化,不建议长时间关闭。
- COMPACT:LSC的稳态数据依据此开关将数据格式进行自动优化(包括排序和合并)。关闭此开关即不再允许自动优化。需要注意,稳态数据的优化有利于查询性能提升,但是优化期间会产生额外的资源消耗,可以根据业务要求适当关闭。
- BUILD AC:LSC的稳态数据依据此开关进行AC的数据文件生成。关闭此开关即不再允许自动生成AC的数据文件,AC的能力可根据业务自行关闭开启。
此子句允许同时开启或关闭多种能力,用户也可通过配置DATA_TRANSFORMER_ENABLED参数整体开启或关闭后台数据转换能力。
Note:
1.TRANSFORM和COMPACT涉及物理空间变动, 转换任务执行后将在一段时间内保留转换前的数据,用于满足长查询的需要;当达到保留的最大时间时对这些数据进行清理 。用户在确保业务不受影响的情况下,可参照 force_xfmr_clause执行立即清理。
2.系统中不存在AC对象时,打开BUILD AC开关不会创建AC数据文件。
示例(LSC表)
#mcol_ttl_clause
该语句用于修改LSC表的可变生命周期,其含义请参考 CREATE TABLE中对应语句描述。
该语句不适用于分布式部署。
示例(单机LSC表)
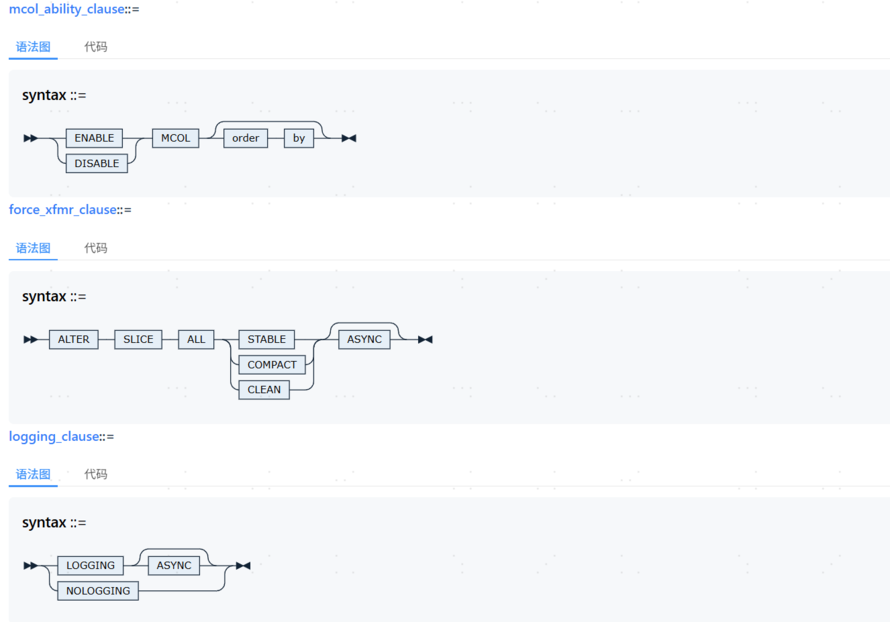
mcol_ability_clause
该语句用于开启或关闭LSC表的可变数据(MCOL)整体功能或排序功能,排序含义请参考 CREATE TABLE中table_sort_clause语句描述。
关闭MCOL功能后,对LSC表进行的数据插入或修改操作会在提交时立即变成不可变数据,如果业务没有较高的事务要求,建议关闭此模块功能。
如需关闭某个LSC表的MCOL功能,请确保已开启该表的后台数据转换能力(ENABLE TRANSFORM)。
示例(LSC表)
#force_xfmr_clause
该语句用于LSC表强制转换,其中ASYNC标记表示异步转换,省略情况下默认进行同步转换。
强制转换有如下三种模式:
- STABLE:将LSC表的可变数据强制转换成稳态数据并生成此表下所有AC数据。
- COMPACT:将LSC表的稳态数据强制进行合并。
- CLEAN:将LSC的所有可删除数据( 转换任务执行完成后达到延期清理条件的数据 )强制进行删除。
示例(LSC表)
#logging_clause
该语句用于修改表的logging属性,logging属性用于指定表记录日志的方式。
该语句不适用于分布式部署。
#logging
该语句用于将表转为logging属性,即对该表的所有操作记录日志。
- 若对已是logging属性的表执行该语句,直接返回成功。
- 若对nologging属性的表执行该语句,系统将执行一次全量checkpoint,将数据写盘并修改flushback,最后修改表的logging属性。
#logging async
该语句用于异步将表转为logging属性。启动新线程完成表模式转化的操作从而不阻塞主线程工作。
注意当客户端返回成功时并不保证转换一定成功,只代表启动线程成功。后续转换仍有可能失败。转换结果通过 运行日志记载。
在异步转换表的过程中存在如下约束限制:
- 不能对转换中的表做任意DML操作。
- 不能对转换中的表做除了DROP以外的任意DDL操作。
#nologging
该语句用于将表转为nologging属性。若对已是nologging属性的表执行该语句,直接返回成功。若对logging属性的表执行该语句,会将其转为nologging属性。建议只在数据迁移场景打开此属性。
该语句不适用于共享集群部署。
执行该语句存在如下约束限制:
- 不能将临时表设置为nologging属性。
- 主备环境中,不能将表设置为nologging属性。
nologging属性的表存在如下特征:
- nologging表对DML操作仅支持插入数据和导入数据,且插入数据时只会记录必要的redo和undo(例如segment相关的redo),其他redo会被忽略。
- nologging表不能执行并发操作。
- nologging表不能执行回滚操作。
- nologging表不能在线创建索引( CREATE INDEX ONLINE)和在线重建索引( ALTER INDEX REBUILD ONLINE)。
- 数据库重启时会将nologging表标记为corrupted,阻止对其进行除drop和truncate外的任何操作。
- 如果一个事务失败,该事务内所有执行过插入数据操作的nologging表都会被标记为corrupted。
- nologging属性的LSC表使用 bulkload模式导入数据时,不受nologging属性影响(性能无变化,失败也不会被标记为corrupted)。
- nologging属性的TAC表不允许修改列和删除主键约束。
示例(单机部署)
#readonly_clause
无实际含义。
#alter_column_clause
该语句用于指定对表的列字段的操作。
#add_column_clause
该语句用于为表增加列字段,同时增加多项时在
()中以
,分隔。COLUMN关键字可省略。
#column_definition
为表增加一个新的列字段,并对增加的列字段进行数据类型(DataType)、缺省值(DEFAULT)、行内约束(inline_constraint)等定义。
对非空表增加定义了NOT NULL约束的列字段时,必须同时为其指定缺省值,否则将提示错误。
#datatype
指定列字段的数据类型。查看YashanDB的 数据类型描述。
其中,数据类型指定为LOB/JSON类型时,可通过 lob_clauses子句指定其存储属性。
YashanDB不允许将新增的列字段指定为Nested Table UDT类型。
#default
为增加的列字段指定一个符合该列字段数据类型的缺省值,default_expr可以为字面量、运算式、函数等表达式。
当指定了缺省值时,系统将对表中现有行的该列字段填充该缺省值。
对于LSC表的新增列字段,该列为LOB型时不能指定缺省值;为其他类型时,缺省值不能定义为 Sequence伪列。
示例(单机LSC表)
#inline_constraint
该语句用于在增加列字段时同时定义表的行内约束项。关于约束项的详细描述请参考通用SQL语法 constraint。
示例
#column_encryption_clause
该语句用于在增加列字段时同时定义列的加密属性,规则同 CREATE TABLE。
示例(HEAP表、LSC表)
#lob_clause
该语句为增加的LOB/JSON字段指定存储属性,语法同 CREATE TABLE中lob_clause子句描述。
#drop_column_clause
该语句用于删除表中已有的列字段或约束项。
#drop_column
删除指定的列字段,指定多个列字段时用
,分隔。COLUMN关键字可省略。
该语句遵循如下规则:
- 不允许删除表中的所有列字段。
- 如果删除的列字段已被定义为主键组合中的一项,则不允许删除此列,但可以删除整个主键对应的列组合。
- 如果删除的列字段已被定义为索引对象中的一项,则删除此列字段后,其对应的索引对象也被删除。
- 分布式部署中,不允许删除分区键所在的列字段。
- LSC表中,不允许删除被定义为排序键的列字段。
- 如果数据库后台正在执行回滚,则不允许删除TAC表/含有热数据的LSC表中使用变长存储的列。
示例(单机、共享集群部署)
示例(分布式TAC表)
示例(LSC表)
#rename_column_clause
该语句用于对列字段进行重命名,指定的新名称不允许为空且必须符合YashanDB的 对象命名规范。
示例(HEAP表、TAC表)
#modify_column_clause
该语句用于对列字段的数据类型、默认值、约束等属性进行修改,同时修改多个列字段时需在
()中以
,分隔。
YashanDB支持同时对列字段修改多个属性,但需遵循与 CREATE TABLE相同的顺序要求,否则系统提示错误;当同时修改多个约束项时,对这些约束项无顺序要求。
#datatype
修改列字段的数据类型为YashanDB认可的 数据类型。
LSC表不允许修改列字段的数据类型,HEAP表和TAC表列字段数据类型修改规则如下:
-
外键约束所在列:不允许修改子表和父表中相应列的数据类型。
-
索引所在列:
-
若为空表(即无数据),允许将其修改为除LOB/JSON/UDT/XMLTYPE外的数据类型。
-
若为非空表,则不允许修改其数据类型。
-
-
使用字典编码的列(仅适用于TAC表):仅允许将其修改为字符型,但仍遵循字符型列的修改规则。
-
变长存储的字符型列(仅适用于TAC表):不允许在数据库进行回滚时,修改其数据类型。
-
分区键、函数索引或AC所在列:不允许修改其数据类型。
-
原数据类型为LOB/JSON/UDT/XMLTYPE的其他列:不允许修改其数据类型。
-
原数据类型为字符型的其他空列:允许将其修改为除LOB/JSON/UDT/XMLTYPE外的其他数据类型。
-
原数据类型为字符型的其他非空列:允许修改为不同字符型,但仍需遵顼以下规则:
-
不允许CHAR/VARCHAR与NCHAR/NVARCHAR交叉修改。
-
当按长度属性从大向小修改时,必须保证该列现有数据的长度均未超过目标数据类型的上限,否则无法修改成功并提示相应错误。
-
HEAP表不允许跨存储方式修改数据类型,例如HEAP表不允许将列数据类型从VARCHAR(3200)(采用普通字符串存储)修改为VARCHAR(8004)(会自动转换为LOB型存储),而TAC表允许此操作。存储方式介绍请查阅 字符型。
-
-
原数据类型为其他数据类型的其他空列:允许将其修改为除LOB/JSON/UDT/XMLTYPE外的其他数据类型。
-
原数据类型为其他数据类型的其他非空列:
-
不允许跨大类修改数据类型,例如不允许将数值型修改为字符型。
-
同一数据大类中,除字符型外其他类型只允许按值域、精度、长度等属性从小向大修改数据类型,例如不允许将INT修改为指定了精度的NUMBER,不允许将DATE修改为TIME。
-
#default
修改列字段的缺省值,default_expr可以为字面量、运算式、函数等表达式。
示例(HEAP表、TAC表)
#inline_constraint
修改列字段的约束项,遵循通用 constraint里的行内约束所定义语法要求。
#modfiy null/not null
修改NOT NULL约束项:
- 不允许对未定义NOT NULL约束项的列字段执行modify NULL。
- 不允许对已定义NOT NULL约束项的列字段执行modify NOT NULL。
- 不允许对已存在NULL数据的列字段执行modify NOT NULL。
- 不允许对已定义ON DELETE SET NULL或ON UPDATE SET NULL外键的列字段执行modify NOT NULL。
#modify unique
修改UNIQUE约束项:
- 不允许对已定义UNIQUE约束项的列字段执行modify UNIQUE。
- 不允许对已存在重复数据的列字段执行modify UNIQUE。
- 不允许对多个列字段同时执行modify UNIQUE。
#modify primary key
修改主键约束项:
- 不允许对已有主键的表执行任意列字段的modify PRIMARY KEY。
- 不允许对已定义UNIQUE约束项的列字段执行modify PRIMARY KEY。
- 不允许对不符合创建主键要求的列字段执行modify PRIMARY KEY,创建主键的要求请参考 constraint描述。
#modify check
修改CHECK约束项:
- 如新的CHECK与表中现有其他的CHECK冲突,无法执行修改。
- 如表中现有的数据不符合CHECK,无法执行修改。
#modfiy foreign key
修改外键约束项:
- 不允许对不符合创建外键要求的列字段执行modify FOREIGN KEY,创建外键的要求请参考 constraint描述。
示例(HEAP表、TAC表)
#alter_table_partition
该语句用于指定对表的分区的操作。
如在表上已建立了分区索引,当执行新增分区和删除分区的操作时,系统也会同时新增索引分区和删除索引分区。
分布式部署中不允许对一级分区执行本语句。
#add_table_partition
该语句用于对表增加一个新的分区(Partition)。
不同类型的表可增加的分区类型不同:
- HEAP表支持增加范围(Range)、列表(List)和哈希(Hash)类型的分区。
- TAC表支持增加范围(Range)、列表(List)和哈希(Hash)类型的分区。
- LSC表支持增加范围(Range)和列表(List)类型的分区。
#add_range_partition_clause
增加范围类型的分区,只能在当前最大分区界值之上建立分区,如表的最大分区界值被设为MAXVALUE,则不允许增加分区。
定义了INTERVAL的范围分区表,其分区由系统自动维护,不可以用本语句为其增加分区。
#table_partition_description
可以为新增的分区指定所属表空间(缺省为表所属表空间),及PCTFREE/PCTUSED/INITRANS/MAXTRANS等属性。
可以为新增的分区指定range、list或者hash子分区,子分区的类型需要和表的定义一致。
如建表时未指定该表为组合分区表,不允许通过本语句为新增分区指定子分区。
示例(单机、共享集群部署)
#add_list_partition_clause
增加列表类型的分区,如表已在列表值里定义了DEFAULT,则不允许增加分区。
分区列表值可以指定为通用表达式( expr)。
#table_partition_description
可以为新增的分区指定所属表空间(缺省为表所属表空间),及PCTFREE/PCTUSED/INITRANS/MAXTRANS等属性。
可以为新增的分区指定range、list或者hash子分区,子分区的类型需要和表的定义一致。
如建表时未指定该表为组合分区表,不允许通过本语句为新增分区指定子分区。
当分区列数量为一并且新增分区包含多个值时,每个值需要用括号包起来,否则报错。
示例(单机、共享集群部署)
#add_hash_partition_clause
增加哈希类型的分区。本语句只适用于HEAP/TAC表。
新增分区的PCTFREE/PCTUSED/INITRANS/MAXTRANS等属性从表上继承,不允许指定。
可以为新增的分区指定range、list或者hash子分区,子分区的类型需要和表的定义一致。
如建表时未指定该表为组合分区表,不允许通过本语句为新增分区指定子分区。
#partition_storage_clause
可以为新增的分区指定所属表空间(缺省为表所属表空间)。
示例(HEAP表、单机TAC表)
#drop_table_partition
该语句用于删除表的分区,同时删除分区里的数据。指定多个分区用
,分隔。
该语句指定的分区中存有数据时,会同步失效表上的全局索引。分布式部署模式下,不管指定的分区是否存有数据,都会失效表上的全局索引。
该语句存在如下约束限制:
- 删除分区时,不允许将表上的所有分区都删除。
- 不允许删除哈希类型分区。
- 在表的分区被删除时,对应的索引分区也会被删除。
- 对于范围类型分区,删除分区后其分区界值将会向相邻大一级分区合并,这样符合此被删除分区界值范围的新增表数据将进入相邻分区中,如不存在相邻大一级分区则数据无法再插入成功。
示例(单机、共享集群部署)
#update_index_clause
指定分区被删除后,对表上的全局索引(Global Index)的处理,默认为INVALIDATE。
- INVALIDATE GLOBAL INDEXES:将全局索引全部失效,不可用。
- UPDAET GLOBAL INDEXES:将全局索引进行更新,仍然可用。
示例(单机、共享集群部署)
#drop_table_subpartition
该语句用于删除表的子分区,同时删除子分区里的数据。指定多个子分区用
,分隔。
本语句存在如下约束限制:
- 删除子分区时,不允许将分区下的所有子分区都删除,也不允许跨分区删除子分区。
- 不允许删除哈希类型子分区。
- 在表的子分区被删除时,对应的索引子分区也会被删除。
示例
#update_index_clause
同drop_table_partition语句中描述一致。
#truncate_table_partition
该语句用于删除分区里的所有数据,指定删除多个分区数据用
,分隔。
该语句同时删除分区对应的本地索引数据(Local Index)。
该语句指定的分区中存有数据时,会同步失效表上的全局索引。分布式部署模式下,不管指定的分区是否存有数据,都会失效表上的全局索引。
#truncate_part_clause
该语句用于指定删除分区数据的方式。
#drop|reuse storage
指定删除分区数据后释放|保留其存储空间。
#cascade
如某张分区表为被子表定义了外键约束的父表,且要删除的分区数据在子表对应列字段值中已经存在,则指定CASCADE将同时删除子表中对应的数据行。本语句只作用于HEAP表。
#purge
当回收站开启时,被删除的数据默认将进入回收站,指定本关键字则表示数据被彻底删除,不进入回收站。本语句只作用于HEAP表。
示例(单机、共享集群部署)
#truncate_table_subpartition
该语句用于删除子分区里的所有数据,指定删除多个子分区数据用
,分隔。
该语句同时删除子分区对应的本地索引数据(Local Index)。
#truncate_part_clause
同truncate_table_partition语句中描述一致。
示例(单机、共享集群部署)
#set_partition_clause
该语句只作用于HEAP表,且只针对范围分区表,用于指定INTERVAL和非INTERVAL分区类型之间的相互转换。转换分区类型不会影响表中原有的数据,新增加的数据则按转换后的分区类型特点存储。
分布式部署中用户无法执行此操作。
#transfer range to range-interval
将RANGE分区表转换为INTERVAL分区时,要求分区键的数据类型为number或date,语法如下:
建立INTERVAL分区的要求和规则与 CREATE TABLE里的interval_clause中描述一致,不符合时无法成功转换。
示例(HEAP表)
modify range-interval
修改INTERVAL分区的属性。
#修改interval值
调整INTERVAL为新的值,之后插入的数据将按新值创建分区。
本功能语法为:
相关要求和规则与上述transfer range to range-interval一致。
#修改分区表空间
指定INTERVAL分区的表空间,指定多个以
,分隔,之后所有新创建的分区将循环使用这些表空间。
本功能语法为:
只能对INTERVAL类型的范围分区表执行此操作,否则系统报错。
示例(HEAP表)
#transfer range-interval to range
将INTERVAL范围分区转换为非INTERVAL的范围分区,语法如下:
示例(HEAP表)
#modify_partition_clause
该语句用于对表分区进行操作,对于一级分区其中包含收缩操作和添加二级分区的操作,对于二级分区只有收缩操作。
#shrink_space_clause
收缩操作与表的收缩一致,请参考 shrink_space_clause。
示例(单机HEAP表)
#split_table_partition
该语句能将一个范围或者列表分区重新划分为多个分区。当一个分区过于臃肿影响到了查询、备份等性能时,可以考虑SPLIT PARTITION。
只能对HEAP表和单机TAC表执行本语句。
该语句须遵循如下限制:
- 不可对组合分区表执行SPLIT PARTITION。
- UPDATE GLOBAL INDEXES为语法兼容,SPLIT PARTITION后会失效全局索引,请SPLIT后 重建(rebuild_clause)全局索引。
- 若指定UPDATE INDEXES,则SPLIT PARTITION后不会失效LOCAL索引,会失效全局索引。
- 未指定分区名的表分区、索引分区、LOB分区会按照SYS_Pn的格式自动生成分区名。
#split at (literal) into
该语句根据指定的字面量将一个范围分区划分为两个范围分区,仅适用于范围分区。
#literal
划分值,该值须位于被划分的分区范围内,否则返回错误。
#range_partition_desc
该语句用于指定划分后两个范围分区的名称,其中一个分区名可保留原分区名称,另一分区名不可与已有的分区名称重复。
新范围分区上下限分别为
[原范围分区下限,literal]和
[literal,原范围分区上限]。
示例(HEAP表、单机TAC表)
#split values (list_values) into
该语句根据指定的列表内容将一个列表分区划分为两个列表分区,仅适用于list分区。
#list_values
划分的列表内容,其中的值须包含在被划分的列表分区内,否则返回错误。
#list_partition_desc
该语句用于指定划分后两个列表分区的名称,其中一个分区名可保留原分区名称,另一分区名不可与已有的分区名称重复。
划分后的第一个列表分区包含list_values中所有值,其余值保存在第二个列表分区中。
示例(HEAP表、单机TAC表)
#split into (range/list_partition_desc)
该语句可将范围分区或列表分区根据指定内容划分为多个分区,适用于范围分区和列表分区。
#range_partition_desc|list_partition_desc
该语句用于指定划分后的分区具体信息,包括分区名称、类型和分区值,新分区类型须与原分区类型保持一致,多个分区间使用
,进行分隔。
划分后的其中一个分区名可保留原分区名称,其余分区名不可与已有的分区名称重复。
#partition partname table_partition_description
该语句用于指定包含所有剩余值的分区名称及信息,名称不可与已有分区的名称重复。
示例(HEAP表、单机TAC表)
#add_subpartition_clause
该语句用于在组合分区表中给指定的一级分区添加二级分区。
该语句中range_subpartition_desc、list_subpartition_desc、individual_hash_subparts的描述请参考 CREATE TABLE。
示例(HEAP表、单机TAC表)
#alter_table_constraint
该语句用于指定对表上的约束的操作包括对添加约束、删除约束、修改约束和停用或启用约束。
#add_constraint
该语句用于添加约束,同时增加多项在
()中以
,分隔。
#out_of_line_constraint
约束项,关于约束项的详细描述请参考通用SQL语法 constraint。
#drop_constraint
该语句用于删除约束项。
如某个约束项在其创建时未指定名称,可以从系统提供视图(如USER_CONSTRAINTS)中查询到其默认名称后再执行删除操作。
删除UNIQUE/PRIMARY KEY约束项会自动删除对应的索引。
示例(HEAP表、)
#modify_constraint
该语句用于修改约束项的属性。
#约束项名称
指定用于修改属性的约束项,可按如下三种方式指定(指定的约束项不存在时报错):
- 对于主键约束项,以PRIMARY KEY表示即可。
- 对于唯一约束项,以UNIQUE表示即可,但需同时指定该约束项对应的列。
- 以CONSTRAINT 约束项名称表示,从系统视图(例如USER_CONSTRAINTS)可获得表上所有的约束项名称。
#enable|disable
启用或停用指定的约束项(含义见 constraint中的ENABLE|DISABLE描述)。
对于存在子表外键关联的约束项,指定DISABLE将无法成功停用,除非同时指定CASCADE。
在指定ENABLE启用约束项时,如表中现有数据无法满足约束规则,则启用失败,除非同时指定NOVALIDATE(但对于主键/唯一/NOT NULL约束项无效)。
#validate|novalidate
启用或停用约束检查(含义见 constraint中的VALIDATE|NOVALIDATE描述)。
本关键字可省略,则对ENABLE操作默认为VALIDATE,对DISABLE操作默认为NOVALIDATE。
#cascade
指定CASCADE表示在DISABLE一个存在子表外键关联的约束项时,同时对子表的外键约束项执行DISABLE。
需注意的是,在重新ENABLE父表的该约束项时,即使指定CASCADE也不会对子表的外键约束项执行ENABLE,用户需手工操作。
本关键字可省略,则在DISABLE一个存在子表外键关联的约束项时默认不会对子表的外键约束项执行DISABLE,而是进行错误提示。
示例
示例(HEAP表)
#enable_disable_constraint
该语句用于启用或者停用表上的某个约束项,拥有与 modify_constraint子句除MODIFY外相同的关键字和含义,但顺序不相同。
示例(HEAP表)
同时,本语句还提供如下与索引相关的语法选项(针对主键/唯一约束项):
-
using_index_clause
-
(KEEP|DROP) INDEX
默认情况下,停用主键/唯一约束项会自动删除对应的索引,启用主键/唯一约束项会自动复用或者创建索引,上述两个选项用于对此情况进行人工干预。
#using_index_clause
在启用主键/唯一约束项时,使用本语句可对系统自动复用或创建的索引进行人工指定,详细语法定义和描述见 constraint中的using_index_clause。
#(keep|drop) index
在停用主键/唯一约束项时,使用KEEP INDEX可指定不删除对应的索引,使用DROP INDEX则同默认情况,即删除对应的索引。
示例
#reclaim_table_clause
该语句用于在表空间迁移后,为迁移的对象声明存储对象和属性。
Warn:
通常用于在分布式部署中进行节点/节点组扩缩容后,将逻辑对象与物理存储对象进行关联。
在该场景下,数据库会自动生成reclaim语句并自动在目标节点执行。 不建议用户手动执行该语句,若不避免可能会导致系统崩溃或其他不可预知的结果。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70028812/viewspace-3093533/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 10亿美元收购Neon背后的技术风口:数据分支爆红,YashanDB正式发布数据沙箱
- 为AI Coding设计!YashanDB发布极简应用开发Skill套件
- 行业发布!企业级龙虾管控方案YashanClaw来了
- 图灵奖得主断言“AI Agent最后全是数据库问题”,YashanDB如何破解 AI落地困局
- YashanDB CREATE DATABASE LINK语句
- YashanDB COMMIT语句
- YashanDB COMMENT语句
- YashanDB BUILD DATABASE语句
- YashanDB BACKUP DATABASE函数
- YashanDB BACKUP ARCHIVELOG语句
