YashanDB hint语法
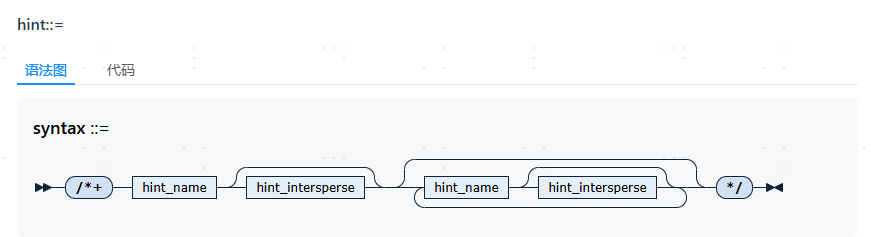 SQL在查询优化阶段,优化器根据内定规则确定执行计划;作为辅助手段, 开发者可以通过在语句中书写hint,指示优化器改变执行路径,以便快速的查询数据。
优化器可以根据系统统计信息动态调整执行计划,使用hint则对执行计划进行了唯一指定,所以应该被谨慎使用,只有在已获取到足够的统计信息,确认改变执行路径是对性能更优的方式,才建议给语句增加hint。当语句涉及的表结构、业务场景或数据量等信息发生变化时,应通过 查看执行计划等手段,重新审视该hint是否合适。
hint有时候会失效,如在hint中指定了非法的顺序(OUTER JOIN则不允许指定顺序),或者指定了非法的JOIN类型等。正常情况下,优化器会优先选择有效的hint,即使该hint的代价更高,但是对于前述非法的hint,优化器会不选择该hint,并在执行计划中输出hint unused。
hint_name
hint提示项的名称,可以同时指定多项hint_name作为组合提示。
如下标识符将被作为YashanDB认可的hint提示项名称:
NO_USE_HASH NO_USE_MERGE NO_USE_NL USE_HASH USE_MERGE USE_NL
hint_intersperse
对于某些提示,需要提供更多的信息来结合指定,例如指定使用索引提示时的索引名称。
YashanDB中使用hint的规则如下:
-
只有跟在SELECT、UPDATE、INSERT、MERGE或DELETE等关键字后面,且以”/*+ ” 作为开始( “+“ 号后面需有空格 ),“*/” 作为结束的语句块 ,才会被解析成hint。
-
一个关键字后跟多组”/*+ */”时,只有第一组被解析成hint,其他忽略。
-
一个hint里某项提示出现如下情况时,优化器忽略该项提示:
- 拼写错误或语法错误
- 不能识别的提示项名称
- 与其他提示项相互冲突
- hint_intersperse里包含了查询块
- 在SQL语句中为表对象定义了别名,而提示中未使用别名
示例(HEAP表、TAC表)
#full提示项
使用FULL提示项时,需同时使用hint_intersperse指定表名,表示对该表执行全表扫描。
示例
#index提示项
使用INDEX提示项时,需同时使用hint_intersperse指定表名 [索引名],表示对该表执行指定的索引扫描。
当hint_intersperse中包含多个索引时,优化器从中选择代价最低的索引;当hint_intersperse中未指定任何索引时,优化器从该表上所有的索引中选择代价最低的索引。
示例(HEAP表、TAC表)
#index_ffs提示项
使用INDEX_FFS提示项时,需同时使用hint_intersperse指定表名 索引名,表示对该表执行指定的索引快速全表扫描。
只有当所有查询列都位于指定的索引列之中,即通过扫描索引就可以得到所有的查询列而不用回表时,优化器才会接受提示选择此索引。
示例
#no_index提示项
使用NO_INDEX提示项时,需同时使用hint_intersperse指定表名 [索引名],表示不使用指定的索引对该表执行索引扫描。
当hint_intersperse中包含多个索引时,这些索引都将不会被优化器使用,但如果该表上存在其他索引,则优化器可能会选择那些索引(由优化器规则决定);当hint_intersperse中未指定任何索引时,则优化器将不会选择该表上的任何索引。
示例
#parallel提示项
使用PARALLEL提示项,可以实现并行查询。为了语法兼容,配置PARALLEL提示项时需使用hint_intersperse同时指定表名和并行度[表名,并行度],但仍表示是对查询操作整体的并行。
若查询中有多张表同时通过hint指定多个并行度值时,所有表的并行度将全采用此次最大的指定值。
通过hint所指定的并行度最大为255,超过255时会退化为255。
无法跨SELECT指定并行度,此种场景请使用数据库参数DEGREE_OF_PARALLEL来指定。
对并行查询的指定只作为一个参考项,如果优化器评估后认为并行查询不是最优计划,则不会选择生成并行计划。
示例
在INSERT关键字后面使用PARALLEL提示项时,表示对指定表进行并行INSERT。目前只支持INSERT INTO SELECT的INSERT并行,INSERT和SELECT可以同时指定并行,也可以只指定一个并行。
当出现下列情形之一时,INSERT并行不生效,对应语句将生成非并行执行计划。
- PARALLEL DML DISABLED,只有在会话中显式ENABLE了PARALLEL DML,INSERT语句中的PARALLEL HINT才能生效。
- INSERT MULTI VALUES、多表INSERT、INSERT ON DUPLICATE不能并行。
- 列表、临时表、DBLINK、物化视图基表不允许并行。
- 带外键约束、INSERT TRIGGER、LOB列的表不允许并行。
- XA事务不允许并行,本地已经启动并行事务后,不能再START一个XA事务,START XA事务后并行不生效。
- 可串行化事务不允许并行。
示例
并行DML使用限制:
- 当表在并行DML中被修改过,不能在事务内对这个表进行查询操作,包括SELECT/UPDATE/DELETE。
- 当表执行过DML,不能在同一事务中对表再进行并行DML。
- 当表执行过并行INSERT:
- 若该表存在索引,则不能再次进行并行INSERT和非并行INSERT。
- 若该表不存在索引,则可以多次进行并行INSERT和非并行INSERT。
并行INSERT使用建议:
- 并行INSERT适用于导入数据的场景,数据导入后立即提交,以免因为并行后的限制影响后续业务。
- 插入数据时不建议带索引,索引冲突大,对并行性能提升影响较大。
- 并行INSERT的并行数受资源限制,需合理设置并行数,执行会按照实际申请到的并行资源设置并行度。
- 并行INSERT有额外的并行资源申请分配,数据分发操作,小数据量或资源不充足的场景下不建议使用。
示例
#leading提示项
使用LEADING提示项时,需同时使用hint_intersperse指定表名 [表名],表示在多表关联的查询中,提示优化器按照指定顺序访问表。
hint_intersperse中只支持以表名或别名指定顺序,大小写不敏感。
LEADING提示的表访问顺序为建议顺序,非强制,当遇到无法调整的JOIN类型(OUTER)时,则不会改变顺序。
当hint_intersperse中指定表数量超过参与JOIN的实际表数量时,优化器不接受此项提示。
当hint_intersperse中出现无效的表时,优化器不接受在该表之后指定的顺序,但仍接受该表之前所指定的顺序。
hint_intersperse中指定多张表时,表示指定的是表连接顺序的前缀,例如LEADING(b a),((b a) c)符合指定的顺序,(c (b a))则不符合。
示例
#no_use_hash提示项
使用NO_USE_HASH提示项时,需同时使用hint_intersperse指定表名 [表名],表示在指定的这些表与其他表进行关联查询时,提示优化器不进行HASH JOIN 。
示例
#no_use_merge提示项
使用NO_USE_MERGE提示项时,需同时使用hint_intersperse指定表名 [表名],表示在指定的这些表与其他表进行关联查询时,提示优化器不进行MERGE JOIN。
示例
#no_use_nl提示项
使用NO_USE_NL提示项时,需同时使用hint_intersperse指定表名 [表名],表示在指定的这些表与其他表进行关联查询时,提示优化器不进行NEST LOOPS。
示例
#use_hash提示项
使用USE_HASH提示项时,需同时使用hint_intersperse指定表名 [表名],表示在指定的这些表与其他表进行关联查询时,提示优化器进行HASH JOIN 。
示例
#use_merge提示项
使用USE_MERGE提示项时,需同时使用hint_intersperse指定表名 [表名],表示在指定的这些表与其他表进行关联查询时,提示优化器进行MERGE JOIN。
示例
#use_nl提示项
使用USE_NL提示项时,需同时使用hint_intersperse指定表名 [表名],表示在指定的这些表与其他表进行关联查询时,提示优化器进行NEST LOOPS。
示例
#selectivity提示项
使用SELECTIVITY提示项时,语法与其他hint不同,SELECTIVITY提示项只可跟在filter后,表示指定这些filter的选择率,其后需跟一个0到1之间的浮点数。
AND、OR和BETWEEN的选择率无法通过hint的方式指定,只能通过计算得到。
示例
#bulkload提示项
使用BULKLOAD提示项时,无需指定表名,仅在LSC表进行单表插入的场景下,使用该提示项会生效,表示对LSC表进行批量插入,可以减少redo的产生,提高插入速度,但是对事务可见性有一定的影响,详见下文约束项。
示例(LSC表)
使用BULKLOAD提示项对表进行插入优化时,在事务提交前,保证其他事务对该插入的数据不可见,不保证本插入事务对新插入数据的可见性。事务提交后,保证该插入的数据对本会话和其他事务可见。
使用BULKLOAD提示项的相关约束如下:
- 开启自动提交时,无法用BULKLOAD提示项。
- BULKLOAD提示项与 SAVEPOINT功能不能同时使用。
- BULKLOAD提示项不能在 INSERT ON DUPLICATE UPDATE语句中使用。
- 同一个事务内,使用BULKLOAD提示项进行插入后,不允许再对该表进行除插入(但不能为INSERT ON DUPLICATE UPDATE)、查询外的其他DML操作。
- 同一个事务内,只能对一张表使用BULKLOAD提示项进行插入。
使用BULKLOAD提示项后,事务失败的回滚机制如下:
- 同一个事务内,若当前语句执行失败且当前语句执行过BULKLOAD插入,会使整个事务回滚并抛出相应的报错信息。例如,使用BULKLOAD提示项执行多值插入语句,部分值插入成功的情况下,后面的值一旦发生失败会使得整个事务回滚。
- 同一个事务内,执行BULKLOAD提示项插入语句后,若因BULKLOAD提示项约束、语法错误、校验错误或部分资源分配失败而导致非匿名块语句执行失败,会使该失败语句回滚;若因其他原因导致某条语句执行失败,会使整个事务回滚并抛出相应的报错信息。
示例(LSC表)
建议在导入期间无需进行查询和其他DML操作的场景中,使用BULKLOAD提示项进行插入,例如增量批量导入。
#deduplicate提示项
使用DEDUPLICATE提示项时,无需指定表名,该提示项仅适用于LSC表,在同时使用有效的BULKLOAD提示项时,DEDUPLICATE提示项才生效。表示对有唯一约束、主键约束的LSC表进行批量插入时,若插入数据与已有数据冲突,则进行去重处理,将冲突的数据对应的行替换成新插入的行。
示例(LSC表)
#max_workers_per_exec提示项
使用MAX_WORKERS_PER_EXEC提示项时,无需指定表名,该提示项仅适用于分布式数据库的TAC表和LSC表的查询和子查询语句,指定可以同时执行的stage的数量。
示例(分布式LSC表、TAC表)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70028812/viewspace-3079843/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 10亿美元收购Neon背后的技术风口:数据分支爆红,YashanDB正式发布数据沙箱
- 为AI Coding设计!YashanDB发布极简应用开发Skill套件
- 行业发布!企业级龙虾管控方案YashanClaw来了
- 图灵奖得主断言“AI Agent最后全是数据库问题”,YashanDB如何破解 AI落地困局
- YashanDB CREATE DATABASE LINK语句
- YashanDB COMMIT语句
- YashanDB COMMENT语句
- YashanDB BUILD DATABASE语句
- YashanDB BACKUP DATABASE函数
- YashanDB BACKUP ARCHIVELOG语句
