【YashanDB 知识库】Hive 命令工具 insert 崖山数据库报错
本文内容来自 YashanDB 官网,原文内容请见 https:///newsinfo/7919217.html?templateId=1718516
**【问题分类】** 功能兼容
**【关键字】**spark 30041、不兼容
【问题描述】
本项目的架构是 hadoop+hive+yashandb
使用崖山数据库,初始化所有的原数据表和数据
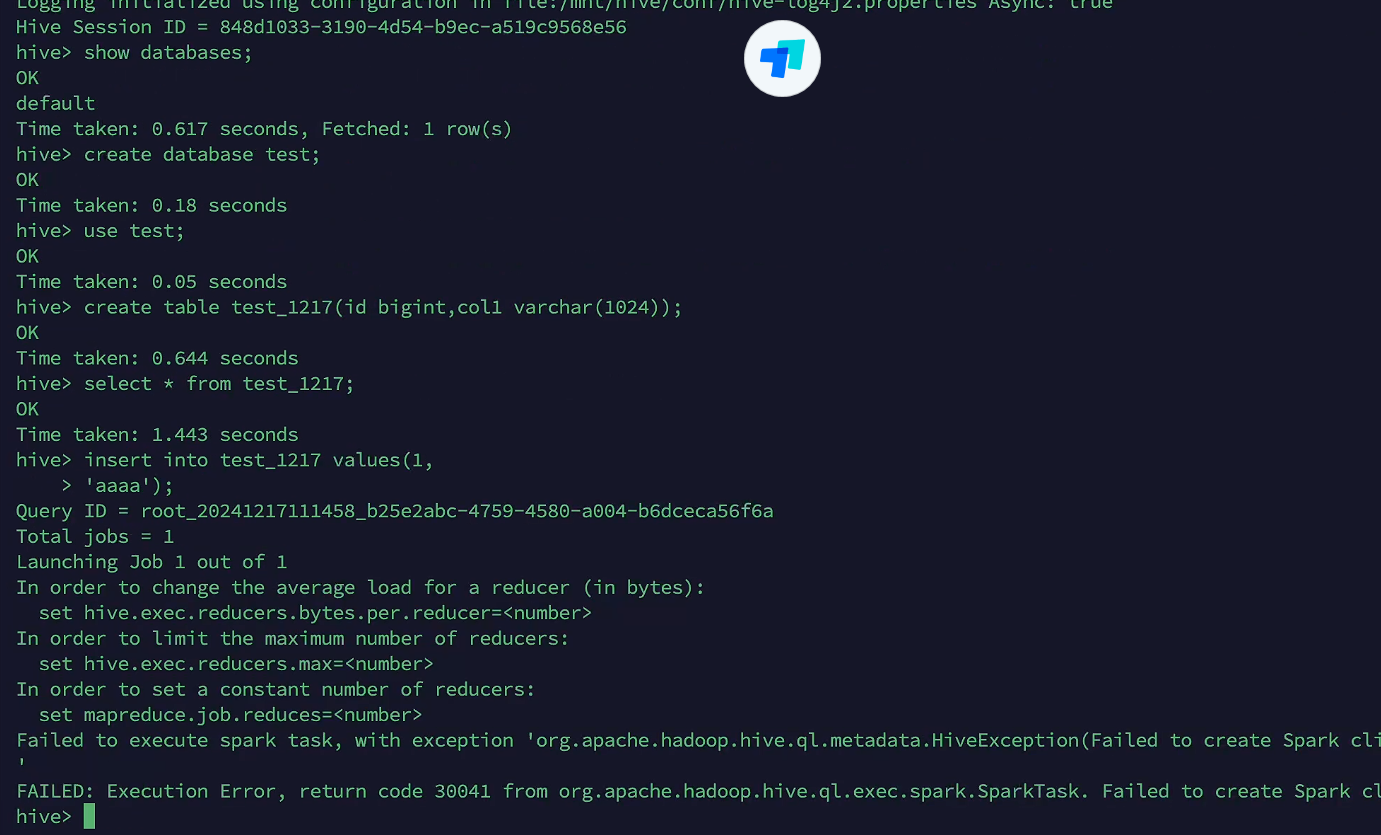
新建表之后,插入数据时候报错,hadoop code 30041 sparktask
【问题原因分析】
综合分析如下可能性,逐一排查
关于 Hadoop 中出现的错误代码 30041,特别是在使用 Spark 作为 Hive 的执行引擎时,这个错误通常指的是
org.apache.hadoop.hive.ql.exec.spark.SparkTask 执行失败。以下是一些可能的原因和解决方案:
1、Spark 未启动:确保 Spark 集群已经启动。如果 Spark 服务未启动,需要在 Spark 的安装路径下执行
./sbin/start-all.sh 来启动 Spark 服务。
2、版本不兼容:检查 Spark 和 Hive 的版本是否兼容。例如,Hive 3.1.2 默认不支持 Spark 3.0.0,需要重新编译 Hive 以支持特定的 Spark 版本。
3、内存资源不足:如果因为内存资源不足导致 Hive 连接 Spark 客户端超时,可以在配置文件中增加 executor 内存或减少每个 executor 的线程数。
4、配置文件调整:在
hive-site.xml 中增加或调整以下配置,以延长 Hive 和 Spark 连接的超时时间:
   <property>
       <name>hive.spark.client.connect.timeout</name>
       <value>100000ms</value>
   </property>
复制代码
这可以有效避免超时报错。
5、网络问题:排查集群内的网络连接,确保通信畅通无阻,因为 Spark 作业依赖于良好的网络环境来完成节点间的通信。
6、YARN 配置:检查 YARN 配置,如
spark.executor.memory 和
yarn.scheduler.maximum-allocation-mb,确保 YARN 配置的最大内存不小于 Spark 配置的内存。
7、环境变量和类路径:确认
SPARK_HOME 环境变量设置正确,并且
spark-env.sh 文件中包含了正确的类路径设置,例如:
export SPARK_DIST_CLASSPATH=$(hadoop classpath);
复制代码
这有助于确保 Spark 能够找到 Hadoop 的类路径。
8、报错分析:查看 SparkSubmit 日志,找到导致任务失败的详细原因,这些信息通常能提供更具体的错误线索。
【解决 / 规避方法】
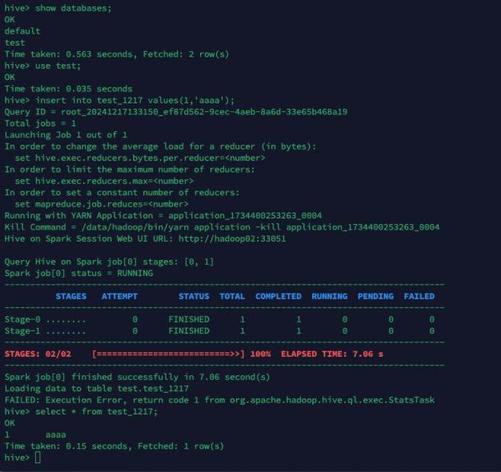
将上述可能性一一排除,发现 spark 环境还没配置成功,下载对应版本的 spark 进行配置调通之后,该问题就解决了
【 影响范围】
【修复版本】-
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70028812/viewspace-3064980/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 10亿美元收购Neon背后的技术风口:数据分支爆红,YashanDB正式发布数据沙箱
- 为AI Coding设计!YashanDB发布极简应用开发Skill套件
- 行业发布!企业级龙虾管控方案YashanClaw来了
- 图灵奖得主断言“AI Agent最后全是数据库问题”,YashanDB如何破解 AI落地困局
- YashanDB CREATE DATABASE LINK语句
- YashanDB COMMIT语句
- YashanDB COMMENT语句
- YashanDB BUILD DATABASE语句
- YashanDB BACKUP DATABASE函数
- YashanDB BACKUP ARCHIVELOG语句
