Redis官网:
https://redis.io
看到标题各位可能有点懵,这里我必须解释一下——假面骑士甲斗王是以速度著称的骑士,在加速模式下可以做到时间静止,在剧场版里甲斗甚至能让时间倒流,可以说是很快很强了
而本文介绍的Redis数据库也是以速度著称,读写速度能达到每秒十万次!
那么开始我们的Redis之旅吧!
REmote DIctionary Server(Redis) 是一个由 Salvatore Sanfilippo 写的 key-value 存储系统,是跨平台的非关系型数据库。
Redis 是一个开源的、支持网络、可基于内存、分布式、可选持久性的键值对(Key-Value)存储数据库,并提供多种语言的 API。
它支持存储的value 类型相对更多, 包括string(字符串)、list(链表)、set(集合)、zset(sorted set 有 序集合)和hash(哈希类型)这些数据类型都支持 push/pop、add/remove及取交集并集和差集及更丰富的操作,而且这些操作都是原子性的
在此基础上,redis支持各种不同方式的排序。与memcached一样,为了保证效率, 数据都是缓存在内存中。区别是redis会周期性的把更新的数据写入磁盘或者把修改操作写入追加的记录文件(数据持久化), 并在此基础上实现了主从同步
特点
速度快,redis虽然是单线程架构,但由于redis的数据是运行在内存中的,所以速度非常快。官方 提供的数据是可以达到100000+的QPS(每秒内查询次数)
支持丰富的数据类型
支持事务,具有丰富的功能特性(慢查询分析、消息队列等)
上面说到Redis是单线程架构,那么什么是单线程架构呢?
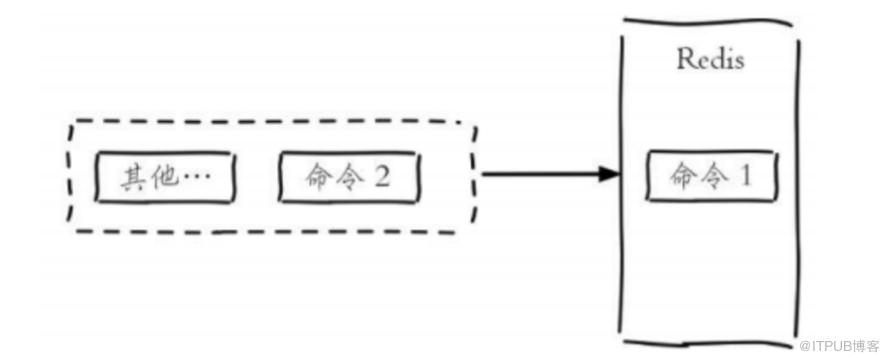
Redis是单线程来处理命令的,也就是说服务端收到客户端一条命令不会立刻执行,而是放进一个队列中,然后等待被执行
但是!像发送命令、返回结果这些是采用了I/O多路复用技术来解决I/O问题
有小伙伴可能会有疑问,既然是单线程那为什么Redis还这么快呢?
这是因为:
Redis是纯内存访问,Redis将所有数据都放在内存中,内存响应时间大约为100纳秒;
其次Redis使用了epoll作为I/O多路复用技术,加上Redis自身事件处理模型将epoll中 的连接,读写,关闭都转换为事件,不会在网络I/O上浪费过多时间;
单线程避免了不必要的上下文切换、多线程资源竞争所带来的资源消耗
client向server请求过程
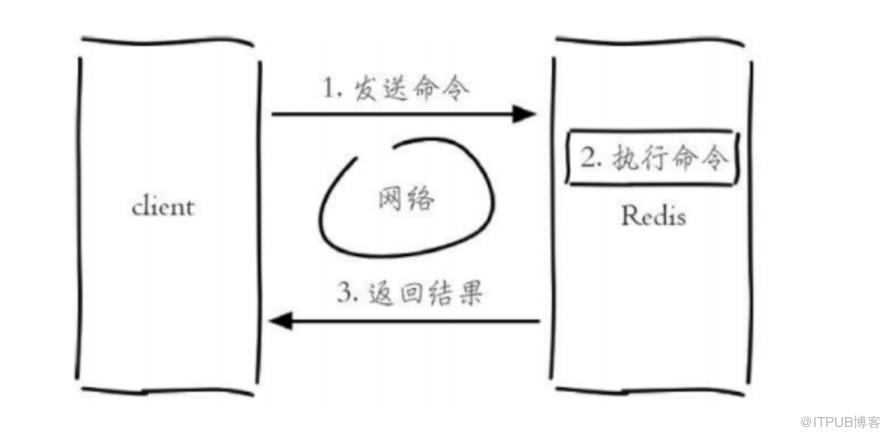
所有命令在一个队列里等待被执行
(这里建议安装官方推荐的文档版本)
# 需要gcc、libc环境yum install -y wget gcc gcc-c++ make tar openssl openssl-devel cmake# 源码安装wget http://download.redis.io/redis-stable.tar.gztar -zxvf redis-stable.tar.gzcd redis-stable/makemake installmkdir /var/log/redis /var/lib/redis /etc/redis -pcp redis.conf /etc/redis/redis.conf.bakcp sentinel.conf /etc/redis/sentinel.conf.bak
因为我们是源码编译,需要自己去配置服务的启动文件
#切换路径cd /usr/lib/systemd/system#创建redis-server服务vim redis-server.service[Unit]Description=Redis persistent key-value databaseAfter=network.targetAfter=network-online.targetWants=network-online.target[Service]ExecStart=/usr/local/bin/redis-server /etc/redis/redis.confExecStop=/usr/bin/killall redis-serverType=forkingUser=rootGroup=root[Install]WantedBy=multi-user.target#创建redis-sentinel服务vim redis-sentinel.service[Unit]Description=Redis sentinel HA solutionAfter=network.targetAfter=network-online.targetWants=network-online.target[Service]ExecStart=/usr/local/bin/redis-sentinel /etc/redis/sentinel.confExecStop=/usr/bin/killall redis-sentinelType=forkingUser=rootGroup=root[Install]WantedBy=multi-user.target
创建好之后我们重新加载让它生效
systemctl daemon-reloadRedis配置文件
基础配置
==================================基础配置bind 127.0.0.1protected-mode yesport 6379tcp-backlog 511timeout 0tcp-keepalive 300daemonize yessupervised nopidfile /var/run/redis_6379.pidloglevel noticelogfile /var/log/redis/redis.logdatabases 16
RDB持久化相关配置
save 900 1 #900s操作一次save 300 10save 60 10000stop-writes-on-bgsave-error yes # 当启用了RDB且最后一次后台保存数据失败,Redis是否停止接收数据rdbcompression yes # 对于存储到磁盘中的快照,可以设置是否进行压缩存储rdbchecksum yes # 在存储快照后,我们还可以让redis使用CRC64算法来进行数据校验dbfilename dump.rdb # 设置快照的文件名dir /var/lib/redis # 设置快照文件的存放路径
AOF持久化相关配置
appendonly no # 默认redis使用的是rdb方式持久化appendfilename "appendonly.aof" # 文件名appendfsync everysec # aof持久化策略的配置no-appendfsync-on-rewrite no # 在aof重写或者写入rdb文件的时候,不执行持久化策略auto-aof-rewrite-percentage 100 # 当目前aof文件大小超过上一次重写的aof文件大小的百分之多少进行重写auto-aof-rewrite-min-size 64mb # 设置允许重写的最小aof文件大小aof-load-truncated yes # 当截断的aof文件被导入的时候,会自动发布一个log给客户端然后load。lua-time-limit 5000 # 一个lua脚本执行的最大时间
主从复制相关配置
slave-serve-stale-data yesslave-read-only yes # 配置Redis的Slave实例是否接受写操作repl-diskless-sync no # 主从数据复制是否使用无硬盘复制功能repl-diskless-sync-delay 5 # 等待时间repl-disable-tcp-nodelay no # 同步之后是否禁用从站上的TCP_NODELAYslave-priority 100
Redis启动
默认启动方式(启动时会加载默认配置文件)
systemctl start redis-server指定配置文件启动(要关闭服务的话得使用kill工具)
redis-server 配置文件
登录使用redis-cli工具进行登录
[]redis-cli 3.2.12Usage: redis-cli [OPTIONS] [cmd [arg [arg ...]]]-h <hostname> Server hostname (default: 127.0.0.1).-p <port> Server port (default: 6379).-s <socket> Server socket (overrides hostname and port).-a <password> Password to use when connecting to the server.-r <repeat> Execute specified command N times.-i <interval> When -r is used, waits <interval> seconds per command.It is possible to specify sub-second times like -i 0.1.-n <db> Database number.-x Read last argument from STDIN.-d <delimiter> Multi-bulk delimiter in for raw formatting (default: \n).-c Enable cluster mode (follow -ASK and -MOVED redirections).
例如
redis-cli -h 127.0.0.1 -p 6379127.0.0.1:6379>
Redis基础命令
由于篇幅有限,关于Redis的基础命令就不在这过多介绍了。
大家可以自行查阅命令手册:http://redisdoc.com/index.html
自动触发(配置文件中配置save字段)
save 900 1 #900s操作一次save 300 10 #每300s数据发生10次改变save 60 10000
手动触发 save命令:阻塞当前redis服务器,直到RDB过程结束。生产环境不建议使用 bgsave命令:Redis进程执行fork操作创建子进程,RDB持久化过程由子进程负责,完成后 自动结束。阻塞只发生在fork阶段,一般时间很短 默认情况下,当关闭redis时(执行shutdown命令),如果没有开启AOF持久化则会自动执行bgsave命令
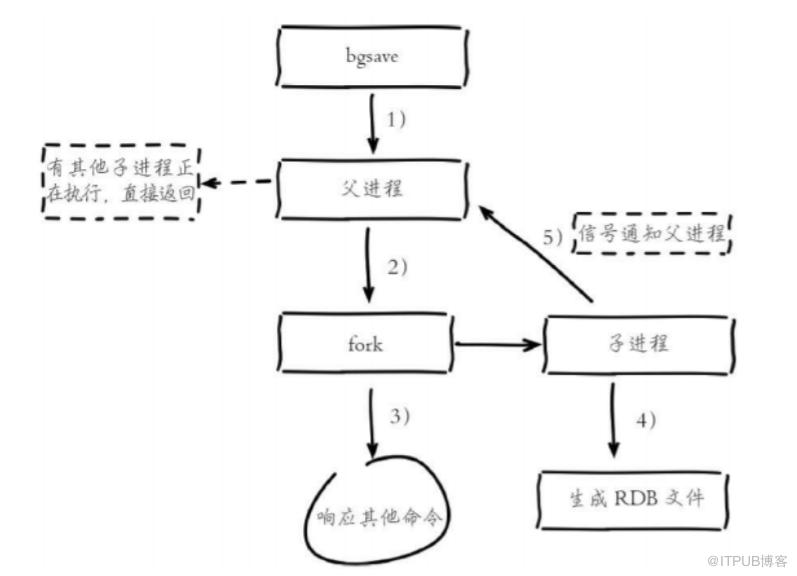
1. 执行bgsave命令,Redis父进程判断当前是否存在正在执行的子进程,如RDB/AOF子进程,如果存在,bgsave命令直接返回。2. 父进程执行fork操作创建子进程,fork操作过程中父进程会阻塞。通过info stats命令查看latest_fork_usec选项,可以获取最近一个fork操作的耗时,单位为微秒。3. 父进程fork完成后,bgsave命令返回“Background saving started”信息 并不再阻塞父进程,可以继续响应其他命令。4. 子进程创建RDB文件,根据父进程内存生成临时快照文件,完成后对原有文件进行原子替换。执行lastsave命令可以获取最后一次生成RDB的时间,对应info统计的rdb_last_save_time选项。5. 进程发送信号给父进程表示完成,父进程更新统计信息,
AOF持久化
AOF持久化机制区别于RDB机制的快照形式,实现了实时持久化,它是以独立日志的方式去记录每次的写命令,Redis启动时会去找到AOF文件然后重新执行里面的命令以达到恢复数据的目的。
AOF 持久化的方法提供了多种的同步频率,即使使用默认的同步频率每秒同步一次,Redis 最
多也就丢失 1 秒的数据而已
AOF 文件使用 Redis 命令追加的形式来构造,因此,即使 Redis 只能向 AOF 文件写入命令的 片断,使用 redis-check-aof 工具也很容易修正 AOF 文件
AOF的触发方式:
appendonly yes # 将配置文件中 appendonly字段设置为yes即可AOF的工作流程:
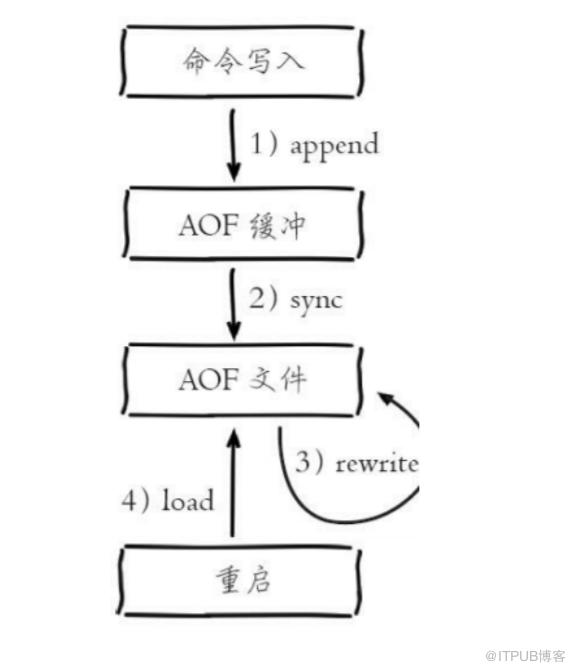
1. 所有的写入命令会追加到aof_buf(缓冲区)中。2. AOF缓冲区根据对应的策略向硬盘做同步操作。3. 随着AOF文件越来越大,需要定期对AOF文件进行重写,达到压缩的目的。4. 当Redis服务器重启时,可以加载AOF文件进行数据恢复
AOF的重写机制:
我们知道,AOF文件记录每次的写命令,随着命令的不断写入,会导致AOF文件越来越大。所以我们需要使用AOF重写机制来压缩文件体积
手动触发:直接调用 bgrewriteaof 命令自动触发:根据 auto-aof-rewrite-min-size 和 auto-aof-rewrite-percentage 参数确定自动触发时机
那么重写机制是如何压缩AOF文件体积的呢?
1.已经超时的数据不会再写入文件
2.旧的AOF文件里面可能会含有无效命令,例如:set key1、del key1、hdel key1、set a111等。重写之后新的AOF文件只保留最终数据的写入命令
3.多条写命令可以合并为一个,如:lpush list a、lpush list b、lpush list c可以转化为:lpush list a b c
4.为了防止单条命令过大造成客户端缓冲区溢 出,对于list、set、hash、zset等类型 操作,以64个元素为界拆分为多条
重写过程:
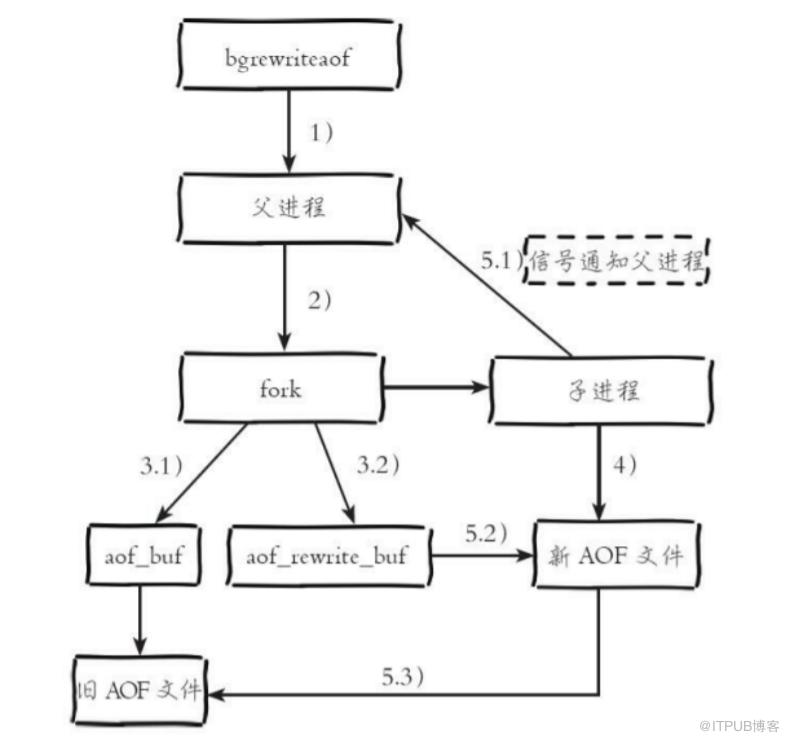
1.执行AOF重写请求2.父进程fork一个子进程,父进程fork完成后继续响应其他命令。所有修改命令先写入AOF缓冲区并根据appendfsync策略同步到硬盘,保证原有AOF机制正确性。4.由于fork操作运用了写时复制技术,子进程只能共享fork操作时的内存数据,由于父进程依然响应命令,Redis使用“AOF重写缓冲区”保存这部分新数据,防止新AOF文件生成期间丢失这部分数据。5.子进程根据内存快照,按照命令合并规则将命令写入到新的AOF文件。每次批量写入硬盘数据量由配置aofrewrite-incremental-fsync控制,默认为32MB,防止单次刷盘数据过多造成硬盘阻塞6.新AOF文件写入完成后,子进程发送信号给父进程,父进程更新统计信息(具体见info persistence下的aof_*相关统计)7.父进程把AOF重新缓冲区的数据写入新AOF文件8.用新AOF文件替换老文件,完成AOF重写
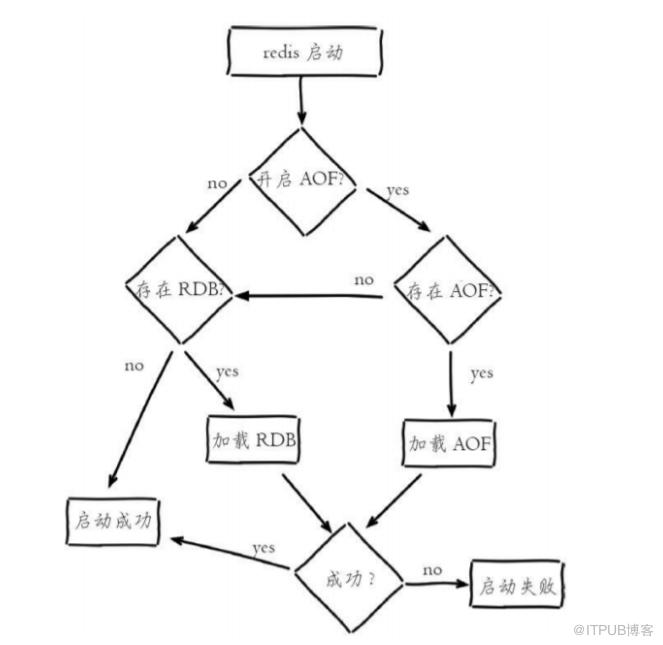
Redis启动执行持久化文件的顺序
原文作者:咸鱼运维杂谈;如有侵权,请联系管理员删除。

