我们紧接上文,现在你使用了哨兵机制架构,业务的性能又上升了一个新的高度

你的Redis从最简单的只有一台实例,经过数据持久化机制、主从复制架构,再到哨兵架构,其性能和稳定性都越来越高,就算节点发生故障,也不用担心了
基于哨兵架构,你的Redis基本上可以稳定运行很长一段时间了,随着时间的发展,你的业务流量迎来了爆炸式的增长,此时你的架构还能够承担这么大的流量吗?
我们思考一下:
Redis节点故障宕机,我们有哨兵+slave,可以实现主从自动切换
大量读请求,我们有多个slave节点来分担压力,就算不够我们还可以增加多台slave
大量写请求,由于只有一台msater,而且只有master才能够提供写服务,所以master容易出现写性能瓶颈
问题出现了,当有大量的写请求时,你的架构只有一个msater能够提供服务,很有可能无法承担那么大的写流量
要想完美的解决这个问题,Redis第三个架构随之而来——分片集群(cluster)
Redis3.0之后添加了cluster模式,这下再也不是一台 redis 服务器提供写服务了
Cluster 将写操作分摊到了多个节点上,提高了写的并发能力,实现了 Redis 的分布式存储
cluster特点
redis cluster集群是为了降低主节点的压力,主主节点之间是不存在同步关系的,各主从之间的数据存在同步关系。有多少主节点,就会把16384个哈希槽(hash slot)平均分配到这些主节点上
当往redis里写入数据时,会根据哈希算法(CRC16(KEY)%16384)算出这个数的哈希槽来决定它放到哪一个主节点上,然后这个主节点的从节点去自动同步。在客户端随便连接一个主节点即可,主节点之间会进行内部跳转。当取对应数据时,各节点之间会自动跳转到所取数据所在的主节点上
cluster节点之间是如何进行通信的?

Redis集群中,节点之间通过建立TCP连接,使用gossip协议来传播集群的信息(节点通信端口=服务端口+10000)
所谓gossip协议,指的是一种消息传播的机制,类似人们传递八卦消息似的,一传十,十传百,直至所有人都知道这条八卦内容。
Redis集群中各节点之间传递消息就是基于gossip协议,最终实现所有节点都会知道整个集群完整的信息
MEET:当需要向集群中加入新节点时,需要集群中的某个节点发送MEET消息到新节点,通知新节点加入集群。新节点收到MEET消息后,会回复PONG命令给发送者(redis5.0后 用add-node命令来添加节点)
PING:集群内每个节点每秒会向其他节点发送PING消息,用来检测其他节点是否正常工作,并交换彼此的状态信息。PING消息中会包括自身节点的状态数据和其他部分节点的状态数据
PONG:当接收到PING消息和MEET消息时,会向发送发回复PONG消息,PONG消息中包括自身节点的状态数据。节点也可以通过广播的方式发送自身的PONG消息来通知整个集群对自身状态的更新
我们前面说到,Cluster模式实现了写请求的并发操作——即不仅仅只有一台master提供写服务,而是多台master提供写服务
那么问题来了,我往Redis集群写入数据时,我怎么数据写到了哪台 Redis master上呢?
在 cluster 中,规定了数据和 Redis 实例的映射规则——哈希槽(Hash slot),一个cluster共有16384个哈希槽(2^14),这些哈希槽类似于数据分区,cluster中的每个master被平均分配了一个 slot 段,对应着0-16384,Slot不能重复也不能缺失,否则会导致对象重复存储或无法存储
当用户想要对 key 执行操作时(读或者写),master首先会对 key 执行计算,得出该 key 所对应的槽位,然后再从哈希槽与节点的映射关系中找到负责该槽位的master
如果在自身,就直接处理;如果在其他master上,就通过重定向告知用户连接到正确的master去处理
master之间也相互监听,一旦有master退出或者加入,会进行数据迁移
例如Node1如果掉线了,0- 3276这些Slot将会平均分摊到Node2和Node3上,由于Node2和Node3本身维护的Slot还会在自己身上不会被重新分配,所以迁移过程中不会影响到3277-16384 Slot段的使用
客户端如何定位数据在哪个节点上?
通过哈希槽,就实现了数据到哈希槽,哈希槽再到实例的分配
但客户端如何知道要访问的数据在哪个实例上呢?
一般来说,客户端和集群实例建立连接后,实例就会把哈希槽的分配信息发给客户端。但是,在集群刚刚创建的时候,每个实例只知道自己被分配了哪些哈希槽,是不知道其他实例拥有的哈希槽信息的
那么实例之间怎么通信呢?
Redis 实例会把自己的哈希槽信息发给和它相连接的其它实例,来完成哈希槽分配信息的扩散。当实例之间相互连接后,每个实例就有所有哈希槽的映射关系了
客户端给相应的节点发送请求的时候,接收请求的节点会计算出命令要处理的键属于哪个槽,并检查这个槽是否指派给了自己
如果键所在的槽刚好指派给了当前节点,那么节点会直接执行这个命令;如果没有指派给当前节点,那么节点会向客户端返回一个 MOVED 错误,然后重定向(redirect)到正确的节点,并再次发送之前待执行的命令
节点通过以下算法来算出 key 属于哪个槽
crc16(key,keylen) & 0x3FFF;#crc16:用于计算 key 的 CRC-16 校验和#0x3FFF:换算成 10 进制是 16383#& 0x3FFF:用于计算出一个介于 0~16383 之间的整数作为 key 的槽号。
查看key属于哪个槽
CLUSTER KEYSLOT <KEY>比如:MOVED 10086 127.0.0.1:7002 表示,客户端请求的键值对所在的哈希槽 10086,实际是在 127.0.0.1:7002 这个实例上。通过返回的 MOVED 命令,就相当于把哈希槽所在的新实例的信息告诉给客户端了。这样一来,客户端就可以直接和 7002 连接,并发送操作请求了。同时,客户端还会更新本地缓存,将该槽与 Redis 实例对应关系更新正确
当对集群中的实例扩容或缩容时,Redis 需要重新分配哈希槽
为了让哈希槽能够平均分配以此实现负载均衡,Redis 需要把哈希槽重新分配,而且分配过程中实例不用下线
但这样有可能会导致客户端进行读操作时,读到的键值对正好属于被迁移槽,并且被迁移槽的一部分键值对还在源实例中,另一部分键值对已经成功迁移到新实例
Redis是如何解决的呢?
首先在源实例中去找相关的 key ,如果对应的 key 还没开始迁移就直接返回
如果 key 不在源实例中,就会返回一个 ASK 错误给客户端,让客户端重定向到新实例处,然后再执行命令
我们发现 ASK 错误和 MOVED 错误都会导致客户端重定向,那他们之间有什么区别呢?
MOVED 错误表示客户端请求的 key 不在当前实例的槽位上,客户端需要重定向到 MOVED 错误指向的实例
而 ASK 错误只是两个节点迁移槽过程中的一种临时措施,客户端请求的 key 正在迁移而且迁移到新实例上去时,就会返回一个 ASK 错误,客户端就会将请求的 key 重定向到 ASK 错误指向的新实例上
如果客户端再次请求相同的 key,它还是会向原来负责该槽位的实例发送请求
ASK 命令只是让客户端给新实例发送一起请求,不像 MOVED命令一样会更改本地缓存的哈希槽分配信息,让后续所有请求都发往新实例
cluster是如何实现高可用的
cluster实现高可用有两个过程:故障检测、故障转移
集群中每个节点会定期向集群中的其他节点发送 ping 消息(基于 gossip 协议),以此判断对方是否在线
如果收到了 ping 消息的节点没有在规定时间内返回 pong 消息,那么发送 ping 消息的节点将该节点标记为疑似下线(possible fail,PFAIL)
如果集群中超过半数以上的master都将该节点 x 标记为疑似下线,则就会将这个节点 x 标记为下线(FAIL),并广播这条消息
我们知道在 cluster 集群中提供服务的是 master,slave是负责同步 master 的数据的
当 slave 发现自己的 master 下线后,就会开始进行故障转移
首先在下线 master 下的所有 slave 中选出一个新的 master
被选中的 slave 会执行SLAVEOF no one命令,成为新的 master
新 master 会撤销对旧 master 的哈希槽,并将这些槽位分配给自己
接着向集群广播一条 pong 消息,告诉其他节点自己成为了 新master,然后对外提供服务
#集群相关redis-cli -c -p 7001 cluster info :打印所有集群的信息redis-cli -c -p 7001 cluster nodes :列出集群当前已知的所有节点( node),以及这些节点的相关信息#节点相关redis-cli -c -p 7001 cluster meet <ip> <port> :将节点添加到集群当中,让它成为集群的一份子(随机分配角色。)redis-cli -c -p 7001 cluster forget <node_id> :从集群中移除 node_id 指定的节点redis-cli -c -p 7001 cluster replicate <master_node_id> :可以让接受命令的节点成为node_id所指定的从节点,并开始对主节点进行复制redis-cli -c -p 7001 cluster saveconfig :将节点的配置文件保存到硬盘里面#哈希槽相关redis-cli -c -p 7001 cluster addslots <slot> [slot ...] :将一个或多个槽(slot)指派( assign)给当前节点redis-cli -c -p 7001 cluster delslots <slot> [slot ...] :移除一个或多个槽对当前节点的指派。redis-cli -c -p 7001 cluster flushslots :移除指派给当前节点的所有槽,让当前节点变成一个没有指派任何槽的节点。redis-cli -c -p 7001 cluster setslot <slot> node <node_id> :将槽 slot 指派给 node_id 指定的节点,如果槽已经指派给另一个节点,那么先让另一个节点删除该槽,然后再进行指派redis-cli -c -p 7001 cluster setslot <slot> migrating <node_id> :将本节点的槽 slot 迁移到 node_id 指定的节点中redis-cli -c -p 7001 cluster setslot <slot> importing <node_id> :从 node_id 指定的节点中导入槽 slot 到本节点redis-cli -c -p 7001 cluster setslot <slot> stable :取消对槽 slot 的导入( import)或者迁移( migrate)#key相关redis-cli -c -p 7001 cluster keyslot <key> :计算键 key 应该被放置在哪个槽上redis-cli -c -p 7001 cluster countkeysinslot <slot> :返回槽 slot 目前包含的键值对数量redis-cli -c -p 7001 cluster getkeysinslot <slot> <count> :返回 count 个 slot 槽中的键
集群相关
#帮助文档redis-cli --cluster help#集群相关redis-cli --cluster create --cluster-replicas 1 <host:port>创建集群#添加主节点redis-cli --cluster add-node <新主节点host:port> <集群任意节点host:port>#添加从节点redis-cli --cluster add-node --slave <从节点host:port> <主节点host:port> --cluster-slave#重新分配slotredis-cli --cluster reshard <节点host:port>#平衡新增节点的slotredis-cli --cluster rebalance --cluster-use-empty-masters#查看集群情况redis-cli --cluster check <节点host:port>#移除节点(在删除的时候,需要保证节点的hash槽是空的,如果不是空的,需要把hash槽移走)redis-cli --cluster del-node <节点host:port> <节点id>#查看某一node信息redis-cli --cluster info <host:port>
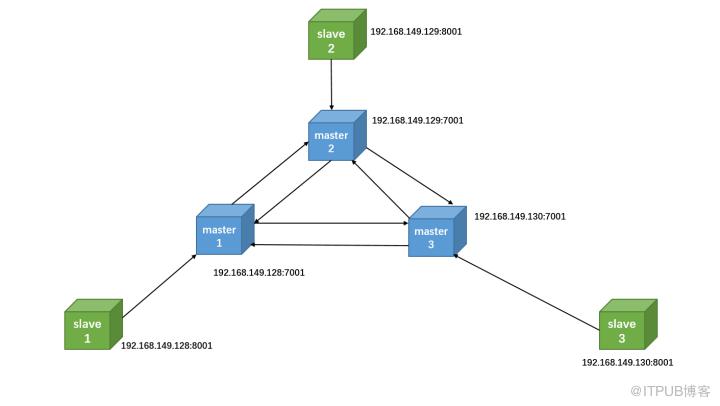
分别在三台服务器上部署
#创建redis cluster data目录mkdir /var/lib/redis/cluster
配置master1和slave1
#vim /etc/redis_7001.confbind 0.0.0.0port 7001daemonize yesprotected-mode nodir /var/lib/redis/clusterlogfile /var/log/redis/redis_7001.logpidfile /var/redis/redis_7001.pidtcp-backlog 511tcp-keepalive 300timeout 0supervised nologlevel noticedatabases 16save 900 1save 300 10save 60 10000stop-writes-on-bgsave-error yesrdbcompression yesrdbchecksum yesdbfilename dump.rdb_7001slave-serve-stale-data yesslave-read-only yesrepl-diskless-sync norepl-diskless-sync-delay 5repl-disable-tcp-nodelay noslave-priority 100cluster-enabled yescluster-config-file nodes_7001.confcluster-node-timeout 15000
#vim /etc/redis_8001.confbind 0.0.0.0port 8001daemonize yesprotected-mode nodir /var/lib/redis/clusterlogfile /var/log/redis/redis_8001.logpidfile /var/redis/redis_8001.pidtcp-backlog 511tcp-keepalive 300timeout 0supervised nologlevel noticedatabases 16save 900 1save 300 10save 60 10000stop-writes-on-bgsave-error yesrdbcompression yesrdbchecksum yesdbfilename dump.rdb_8001slave-serve-stale-data yesslave-read-only yesrepl-diskless-sync norepl-diskless-sync-delay 5repl-disable-tcp-nodelay noslave-priority 100cluster-enabled yescluster-config-file nodes_8001.confcluster-node-timeout 15000
启动Redis实例
redis-server /etc/redis_7001.conf && redis-server /etc/redis_8001.conf配置master2和slave2
#vim /etc/redis_7001.confbind 0.0.0.0port 7001daemonize yesprotected-mode nodir /var/lib/redis/clusterlogfile /var/log/redis/redis_7001.logpidfile /var/redis/redis_7001.pidtcp-backlog 511tcp-keepalive 300timeout 0supervised nologlevel noticedatabases 16save 900 1save 300 10save 60 10000stop-writes-on-bgsave-error yesrdbcompression yesrdbchecksum yesdbfilename dump.rdb_7001slave-serve-stale-data yesslave-read-only yesrepl-diskless-sync norepl-diskless-sync-delay 5repl-disable-tcp-nodelay noslave-priority 100cluster-enabled yescluster-config-file nodes_7001.confcluster-node-timeout 15000
#vim /etc/redis_8001.confbind 0.0.0.0port 8001daemonize yesprotected-mode nodir /var/lib/redis/clusterlogfile /var/log/redis/redis_8001.logpidfile /var/redis/redis_8001.pidtcp-backlog 511tcp-keepalive 300timeout 0supervised nologlevel noticedatabases 16save 900 1save 300 10save 60 10000stop-writes-on-bgsave-error yesrdbcompression yesrdbchecksum yesdbfilename dump.rdb_8001slave-serve-stale-data yesslave-read-only yesrepl-diskless-sync norepl-diskless-sync-delay 5repl-disable-tcp-nodelay noslave-priority 100cluster-enabled yescluster-config-file nodes_8001.confcluster-node-timeout 15000
启动Redis
redis-server /etc/redis_7001.conf && redis-server /etc/redis_8001.conf配置master3和slave3
#vim /etc/redis_7001.confbind 0.0.0.0port 7001daemonize yesprotected-mode nodir /var/lib/redis/clusterlogfile /var/log/redis/redis_7001.logpidfile /var/redis/redis_7001.pidtcp-backlog 511tcp-keepalive 300timeout 0supervised nologlevel noticedatabases 16save 900 1save 300 10save 60 10000stop-writes-on-bgsave-error yesrdbcompression yesrdbchecksum yesdbfilename dump.rdb_7001slave-serve-stale-data yesslave-read-only yesrepl-diskless-sync norepl-diskless-sync-delay 5repl-disable-tcp-nodelay noslave-priority 100cluster-enabled yescluster-config-file nodes_7001.confcluster-node-timeout 15000vim /etc/redis_7001.confbind 0.0.0.0port 7001daemonize yesprotected-mode nodir /var/lib/redis/clusterlogfile /var/log/redis/redis_7001.logpidfile /var/redis/redis_7001.pidcluster-enabled yescluster-config-file nodes_7001.confcluster-node-timeout 15000
#vim /etc/redis_8001.confbind 0.0.0.0port 8001daemonize yesprotected-mode nodir /var/lib/redis/clusterlogfile /var/log/redis/redis_8001.logpidfile /var/redis/redis_8001.pidtcp-backlog 511tcp-keepalive 300timeout 0supervised nologlevel noticedatabases 16save 900 1save 300 10save 60 10000stop-writes-on-bgsave-error yesrdbcompression yesrdbchecksum yesdbfilename dump.rdb_8001slave-serve-stale-data yesslave-read-only yesrepl-diskless-sync norepl-diskless-sync-delay 5repl-disable-tcp-nodelay noslave-priority 100cluster-enabled yescluster-config-file nodes_8001.confcluster-node-timeout 15000
启动Redis实例
redis-server /etc/redis_7001.conf && redis-server /etc/redis_8001.conf创建完实例后我们自动创建cluster集群
redis-cli --cluster create --cluster-replicas 1 192.168.149.128:7001 192.168.149.128:8001 192.168.149.129:7001 192.168.149.129:8001 192.168.149.130:7001 192.168.149.130:8001cluster会自动为master分配slave,分配后信息如图

我们也可以手动指定主从节点,不需要系统给我们自动分配
手动配置主节点(系统会自动分配slot,master必须大于等于三个)
redis-cli --cluster create --cluster-replicas 0 192.168.149.128:7001 192.168.149.129:7001 192.168.149.手动配置从节点
redis-cli --cluster add-node 192.168.149.129:8001 192.168.149.128:7001 --cluster-slaveredis-cli --cluster add-node 192.168.149.130:8001 192.168.149.129:7001 --cluster-slaveredis-cli --cluster add-node 192.168.149.128:8001 192.168.149.130:7001 --cluster-slave
验证
#redis-cli -c -p 7001127.0.0.1:7001> CLUSTER NODESdb93ccf1d9ec043032b2a5c8a559f0aa0b77377b 192.168.149.129:7001@17001 master - 0 1660126817807 3 connected 5461-109226ebbefdc950de1b003ce49fdf5a6e8e853f4099a 192.168.149.129:8001@18001 slave e88d4393194f8990dfb9f6a958953e8a7a174a55 0 1660126819000 1 connected9355eadf652557747690155b8acb2bd5a1fb7a8d 192.168.149.128:8001@18001 slave 8a36ec13af914d629df215bdf97e690167e3b67f 0 1660126818824 5 connected8a36ec13af914d629df215bdf97e690167e3b67f 192.168.149.130:7001@17001 master - 0 1660126820857 5 connected 10923-16383e88d4393194f8990dfb9f6a958953e8a7a174a55 192.168.149.128:7001@17001 myself,master - 0 1660126820000 1 connected 0-5460eef9afb0222d6fc66bceddd1e95eaee64f2c4eb7 192.168.149.130:8001@18001 slave db93ccf1d9ec043032b2a5c8a559f0aa0b77377b 0 1660126820000 3 connected
可以看到192.168.149.128:7001是主,192.168.149.129:8001是其从
#在192.168.149.128:7001 写入数据[root@master ~]# redis-cli -c -p 7001127.0.0.1:7001> set name python-> Redirected to slot [5798] located at 192.168.149.129:7001OK#在192.168.149.129:8001查看[root@slave1 ~]# redis-cli -c -p 8001127.0.0.1:8001> get name-> Redirected to slot [5798] located at 192.168.149.129:7001"python"
缩容案例
创建了四台master打算将其中一台master(192.168.149.128:8001)转换成slave
然后再分别为三台master分配slave 变成三主三从架构
#master:192.168.149.128:7001192.168.149.128:8001192.168.149.129:7001192.168.149.130:7001
首先我们将192.168.149.128:8001上的哈希槽(12288-16383)全部分配给192.168.149.128:7001
redis-cli --cluster reshard 192.168.149.128:7001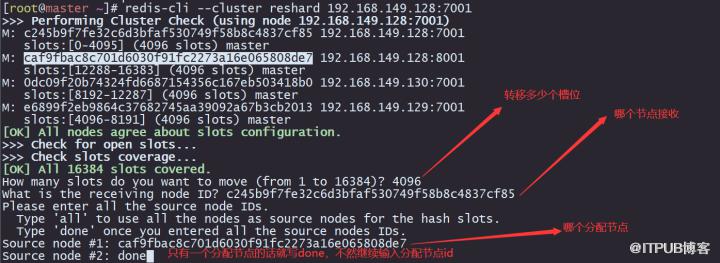

分配后把192.168.149.128:8001节点删除
redis-cli --cluster del-node 192.168.149.128:8001 caf9fbac8c701d6030f91fc2273a16e065808de7现在只有三台主,我们添加从节点,每台主分配一台从
redis-cli --cluster add-node 192.168.149.129:8001 192.168.149.128:7001 --cluster-slaveredis-cli --cluster add-node 192.168.149.130:8001 192.168.149.129:7001 --cluster-slaveredis-cli --cluster add-node 192.168.149.128:8001 192.168.149.130:7001 --cluster-slave
将槽位重新分配一下
redis-cli --cluster rebalance 192.168.149.128:7001验证
#在192.168.149.129:7001写数据[root@minion1 ~]# redis-cli -c -p 7001127.0.0.1:7001> set age 18-> Redirected to slot [741] located at 192.168.149.128:7001OK#重定向到192.168.149.128:7001了。而192.168.149.128:7001的从是192.168.149.129:8001192.168.149.129:8001> get age-> Redirected to slot [741] located at 192.168.149.128:7001"18"
扩容案例
将192.168.149.128:8001转换成master,然后分配slot
#master:192.168.149.128:7001192.168.149.129:7001192.168.149.130:7001#slave:192.168.149.129:8001192.168.149.130:8001192.168.149.128:8001
首先我们删除192.168.149.128:8001节点。因为是 slave,删除的时候不需要执行移除槽位操作
redis-cli --cluster del-node 192.168.149.128:8001 caf9fbac8c701d6030f91fc2273a16e065808de7然后升级成master节点
redis-cli --cluster ass-node 192.168.149.128:8001 192.168.149.128:7001 升级之后重新分配槽位
redis-cli --cluster rebalance --cluster-use-empty-masters 192.168.149.128:8001
原文作者:咸鱼运维杂谈;如有侵权,请联系管理员删除。

