好沮丧,大语言模型 不懂我 怎么办,
怎么也搜不到想要的答案 ( ㄒ o ㄒ )
当当当当, Redis VSS 闪亮登场,不必微调模型,
也能轻松驾驭大语言,快速解答你的疑虑,满足你
的求知欲,你的 AI 好伙伴!
在这个简短的教程中,我们 将 使用 Relevance AI、Redis VSS、OpenAI GPT 和 Cohere Wikipedia 嵌入创建一条 LLM 链 ,这 使得 我们 能够 使用Redis向量搜索向百科提问,根据我们的问题 搜索 最 相似的 文章。对于嵌入 向量 , 它们 是 表示各种 类型数据的数字列表, 在这里, 我们使用Cohere多语言模型 生成的嵌入向量 。
为了按照本教程进行操作 ,您需要一个支持JSON文档数据结构 ,且 内置实时搜索和查询功能的Redis数据库。您可以 选择 在Redis Enterprise Cloud上创建 , 或者 在 Docker中 使用Redis Stack创建。
一、 设置Redis作为向量数据库
运行 Redis 之后 ,我们从HuggingFace上导入Cohere的多语言维基百科嵌入数据集 , 这 只 需要几个简单的步骤 , 您可以在这个jupyter笔记本中查看完整的代码。
步骤 1 . 安装redis和datasets的Python库。
pip install redis datasets
步骤 2 . 创建一个客户端连接。
|
import redis redis_client = redis.from_url( 'redis://connection-string' ) |
步骤
3
.
下载样本数据集。
|
from datasets import load_dataset
docs = load_dataset( "Cohere/wikipedia-22-12-simple-embeddings" , split = "train" ) |
步骤 4 . 使用 JSON 将每个文档导入 Redis 。
|
pipe = redis_client.pipeline()
index = 0 for doc in docs: pipe.json(). set (f "wiki:{doc['id']}" , '$' , doc) if index % 500 == 0 : pipe.execute() index += 1
pipe.execute() |
步骤 5 . 创建一个向量搜索索引
|
redis_client.execute_command( "FT.create wikipedia ON JSON PREFIX 1 wiki: SCHEMA $.id AS id NUMERIC $.title AS title TEXT $.text AS text TEXT $.wiki_id as wiki_id NUMERIC $.views as views NUMERIC $.emb as emb VECTOR HNSW 6 DIM 768 DISTANCE_METRIC L2 TYPE FLOAT32" ) |
此命令指定索引Wikipedia,该索引在JSON中存储数据,其中所有键都使用前缀wiki:进行索引。在模式中,我们 使用 $.field_name引用JSON中的每个字段, 并用名称及其数据类型为其添加一个友好的标签 。向量字段 “ emb ” 是向量类型,并使用HNSW作为索引类型,L2作为距离度量 方式 。
命令运行后,您 就 拥有 了 支持向量相似性搜索的Redis索引。
二、建立 LLM链
接下来,就可以 进入Relevance AI笔记本开始构建我们的 LLM 链了。
步骤 1 . 如有必要,请注册Relevance AI的免费帐户。登录后,选择“构建AI链”并点击“创建新链” , 您将进入 到一个笔记 本界面。
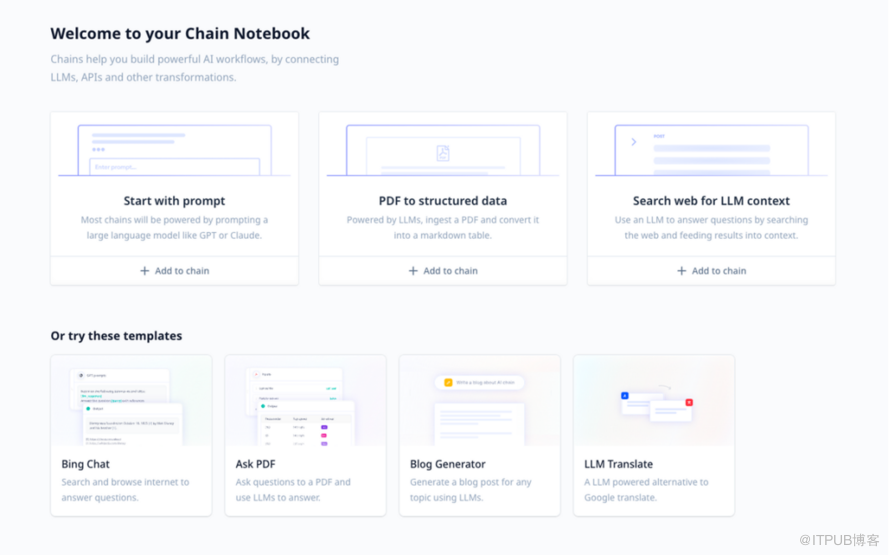
Relevance AI链笔记本
步骤 2 . 在执行 LLM 链之前,您需要配置 您的 OpenAI API密钥和Redis 链接 字符串。请从侧边栏选择 “API keys”,然后提供您的Redis 链接 字符串和OpenAI API密钥。
步骤 3 . 选择“ 从 Prompt开始 ” , 为 “向量搜索(Redis)”添加新的转换。使用以下详细信息填写表格:
· 索引名称:您在Redis中创建的索引,即wikipedia。
· 向量字段:存储嵌入的字段 , 对于维基百科数据集,这 里填 emb。
· 模型 Model : cohere-multilingual-22-12 , 生成搜索查询的向量嵌入 。
· 搜索查询 : 我们 快速 为 LLM 链定义一个输入。按{}并输入{{params.question}}将其更改为变量模式。
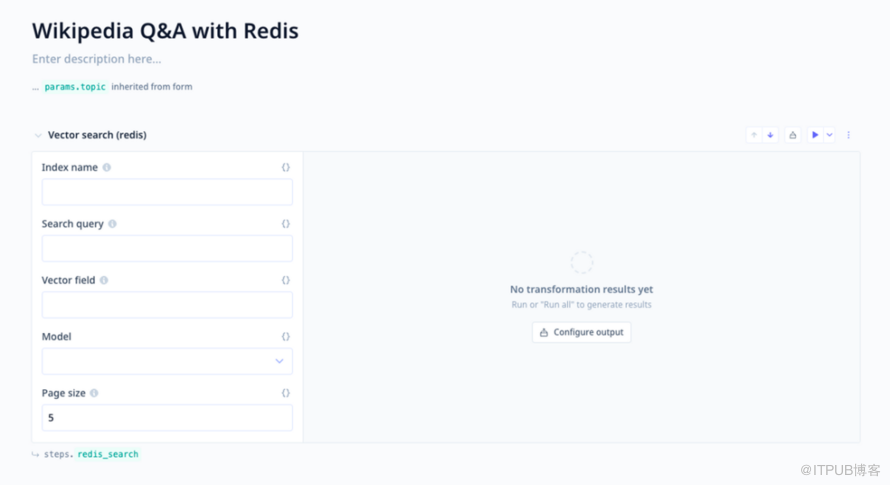
Redis 向 量搜索步骤及其输入的示例。
步骤 4 . 配置LLM Prompt 以 使用 向量搜索 向 Prompt 中注入上下文并提问。您可以根据自己的需要自定义 Prompt 。
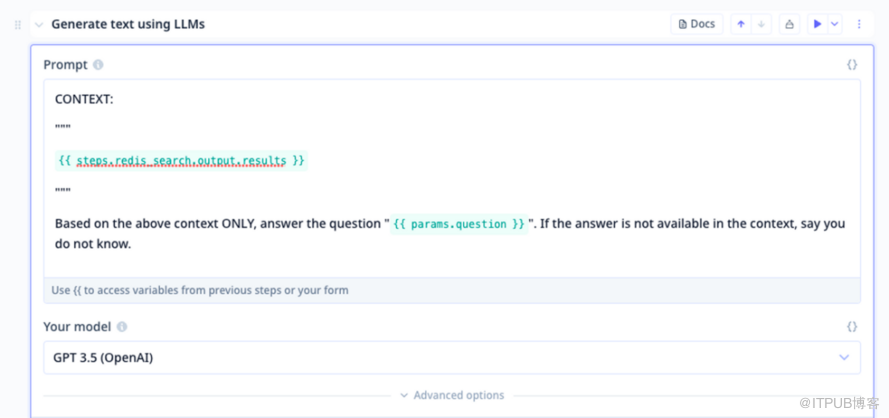
LLM 步骤的示例,该步骤从 Redis 搜索和查询中获取上下文并提出问题。
这是 为了 帮助人们查询大量的信息。比如 ,你 最喜欢 周杰伦的《夜曲》 ,你想知道: “ 这首歌的吉他前奏是谁弹奏的? ”有了LLM链, 你就 可以 把这个问题扔给结合了 AI的维基百科 进行 搜索,它会迅速 给出答案 。
这不仅仅是 实践新技术 , 更 是 快速地加深你 的理解 并 满足 你 的好奇心。我们的 LLM 链 就像 位 知识渊博的朋友 ,热情地与你清茶淡话 , 它 随时准备 同你 对话, 这 为 知识搜索增添了一丝人情味 。
三、部署链
Relevance AI提供了两种部署链的方法:作为可嵌入的应用程序或作为API端点。应用程序也可以通过链接直接与用户共享,用户可以看到表格,填写并运行 LLM 链 , 这些现在已经 可以用于 生产中 了 。
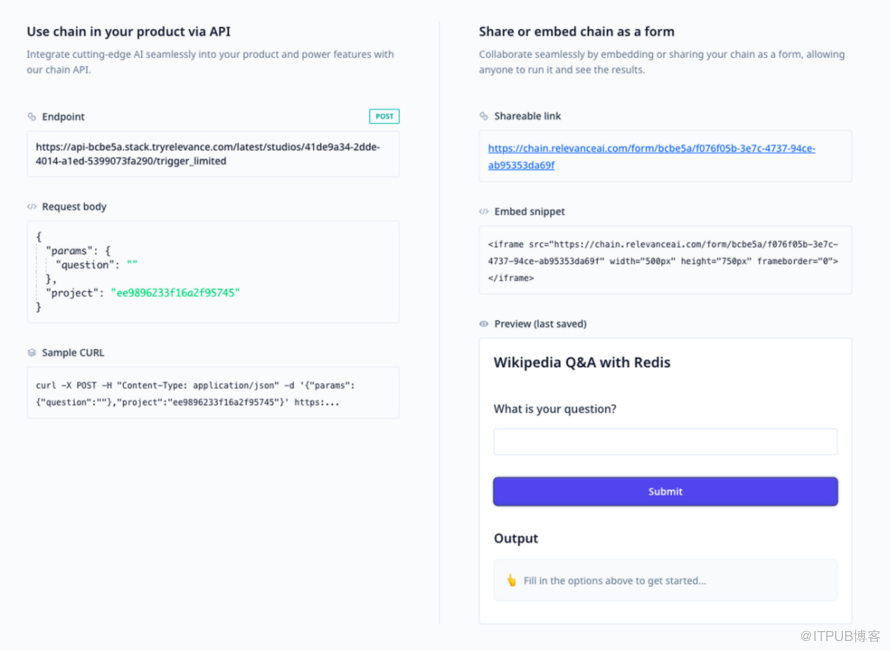
带有 可用于生产的 API 端点或可共享 URL 表单的 LLM 链的部署页面
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70026953/viewspace-2987329/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 破解上下文陷阱,MCP Gateway筑牢企业AI基础设施护城河
- Redis 8.10 HIMPORT:更高效地批量写入 Hash 数据
- ReAct Agent 是什么:从推理—行动循环到生产环境实践
- LLM API 选型与集成:从模型调用到生产架构的实践指南
- Redis 安全公告:CVE-2026-81934 TLS 处理漏洞及修复建议
- 32条指导意见发布,金融AI进入“强治理”阶段:艾体宝Qdrant为何成为关键底座?
- 艾体宝Allegro Packets 正式发布网络万用表 AI 助手:让网络排障进入智能时代
- 艾体宝干货 | Qdrant如何从多层导航图搭建生产级向量检索?
- 从 UN R155 到 ISO 21434:汽车供应链为何正在要求 SBOM?
- 图数据库 + 大模型:连接型数据如何重塑企业AI应用范式
