
我们先回忆在上文《大数据基础-3行代码实现最基本的路由分片(附代码)》的主要内容,我们介绍了哈希分片的第一类常见套路,hash取模法(即基础轮询),并在一定程度上进行延伸,引出加权轮询的概念。最后我们对基础轮训和加权轮询的优缺点进行考量,其虽然逻辑清晰、复杂度低,但是灵活性较差。当节点发生变化时,会导致映射关系全部打乱,已经分配的数据也需要根据新的映射关系重新分配。
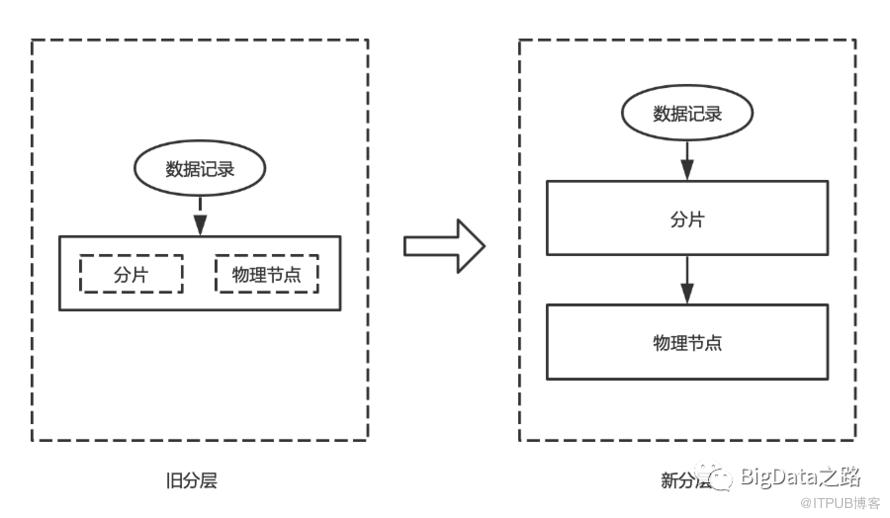
分片层和物理节点层重合。
hash取模的方法对取模数值非常敏感,牵一发而动全身。
解决层次模糊的问题
在通用的路由分片模型中,存在着Key-Patition映射和Partition-Machine映射,其代表着数据记录、分片、物理节点3个角色存在其中,因此对于基础轮询而言,其分层方式是有悖于通用的路由分片模型。我们需要对其进行层次拆分。如下图所示,将原本强耦合的两层拆分成弱耦合的三层,这样就满足通用模型的定义。
解决hash取模敏感度高
-
固定分片数量
<1>对于hash取模来说,其对取模的数值的大小是依赖性非常高。
那么是否可以保证取模的数值固定不变呢?
此时你可能会想:对于分布式服务来说,日常节点的扩容、缩容肯定都是都是非常正常的事情。的确,过去确实是不可以,但是此时我们已经解决了路由分片模型中的分层问题,那么保证数值不变就不是一个难题了。
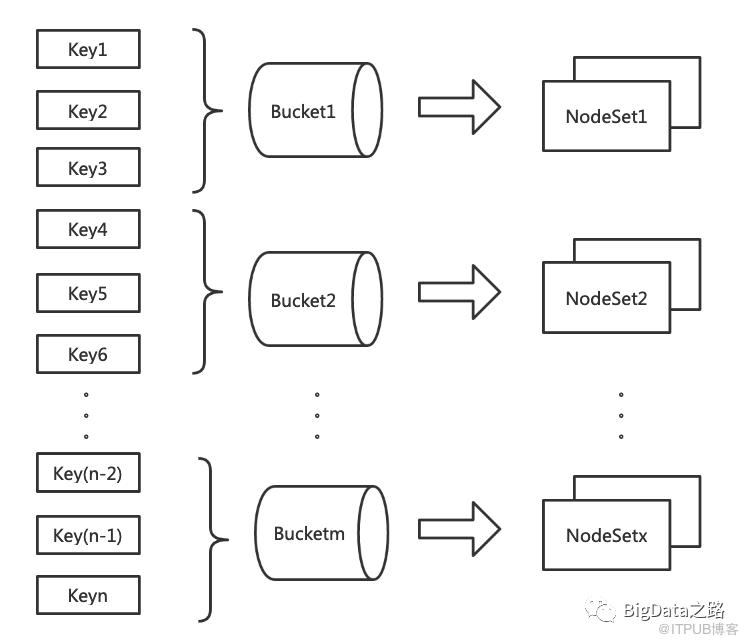
我们可以保证分片数量是固定的,那么此时物理节点的增加或者减少就并不影响分片的数量了,无论何时通过将Key 进行hash取模的数值都不会变了,这样就解决了节点变化。
-
弱化重分配成本
当我们将分片进行数量固定后,每当物理节点变化(上线、下线)时,都会通过维护Partition-Machine之间的映射关系,将物理节点的最新变动同步给分片层进行新旧节点间的数据迁移,从而实现各个节点上的分片数量、物理数据相对均衡。
当有节点上线时,老节点上的部分数据会逐渐迁移到新节点上,同时更新路由信息。
节点下线时,迁移方向相反。这样就解决了hash取模,节点变动后,全量重新分配的问题。
-
消息体大小线性增长
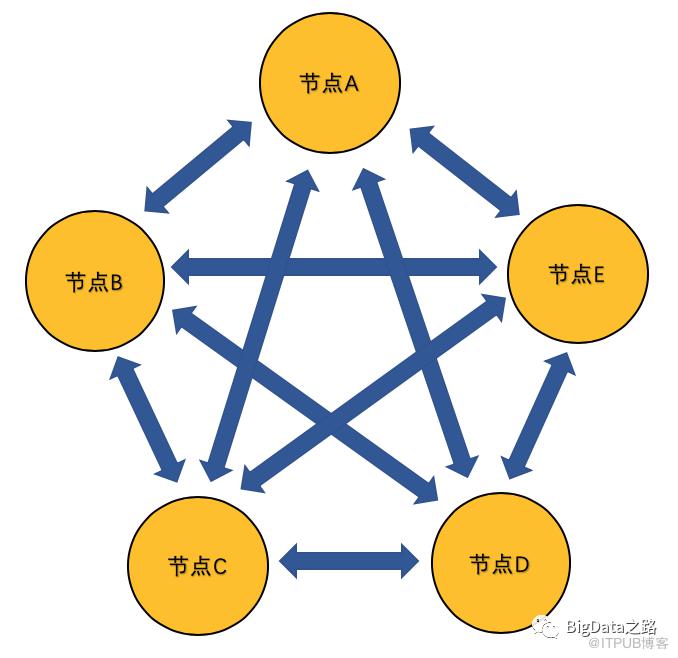
如果slot的数量为16384,那么根据redis的消息数据结构来看,其消息头是大小为16384/8个字节的char类型数组,这个bitmap存放当前节点和slot的对应关系(redis数据结构与本篇主题关系不大,暂不详细展开)。此外还包括其他节点的信息,集群节点越多,其消息体越大。
-
快速维护全局唯一拓扑
为了保证集群内节点信息数据的一致性,redis集群内部心跳的时间也非常短,因此节点越多,会把消息体同步所占用的网络带宽不断放大,直到集群无法负担,由于无法实际测试具体多少节点才最大限制,最后查了redis作者的回答,他建议是小于1000节点,实际上据我所知,redis集群上百节点就已经很大了,
-
数据结构压缩效率
此外节点不变,slot越多,那么bitmap的压缩率就越低。
---------------------------------------------------------
B:不知道为啥,过去就这个值。我过去接这个服务时,我也问过,上一个人也不知道为啥。
C:我联系下过去负责这个服务的同学,我有他微信,我问问。
。。。。
C:他说当时是2010年,四舍五入就2000了。
A:WHAT?
抛开尴尬不谈,很多人都在问为啥前人留的坑不好填呢?因为当一个逻辑你绞尽脑汁都想不出来答案时,可能仅仅是前人一个拍脑袋的决定而已。
原创不易,觉得有点用的话,就请你为本文点个在看或者无情转发吧。
你的支持是我写作的动力。
原文作者:BigData之路;如有侵权,请联系管理员删除。

