导读:本文将从OLAP和OLTP的本质出发,向读者揭示OLAP和OLTP分类的关键因素,从而引出ClickHouse的核心理念及优化方向。
现代工程界普遍认为,数据库系统可以在广义上分为联机事务处理(Online Transaction Process,OLTP)和联机分析处理(Online Analyze Process,OLAP)两种面向不同领域的数据库,OLAP数据库也被称为数据仓库。从产品上看,有专门面向OLTP的数据库,例如MySQL、PostgreSQL、Oracle等,也有专门面向OLAP的数据库,例如Hive、Greenplum、HBase、ClickHouse等。还有一种尝试统一两大类型的HATP(Hybird Analyze Transaction Process)系统,例如TiDB、OceanBase等。
表1-1列出了OLAP和OLTP的一些对比。近年来,随着技术的发展,OLAP和OLTP之间的界限也在不断模糊,几年前OLAP数据库都不支持事务,近几年已经出现了一些支持简单事务的OLAP引擎,ClickHouse也将简单的事务支持列入Roadmap。另外,随着分布式技术的发展,部分OLTP数据库也能处理更大的数据,甚至厂商推出的HATP数据库,从而直接打破了两者的界限。
▼表1-1 OLAP和OLTP的对比
OLAP | OLTP | |
用途 | 数据仓库 | 事务数据库 |
数据容量 | 大,PB级 | 小,GB级,部分能达到TB级 |
事务能力 | 弱(或无) | 强 |
分析能力 | 强 | 弱,只能做简单的分析 |
并发数 | 低 | 高 |
数据质量 | 相对低 | 高 |
数据来源 | 各业务数据库 | 各业务系统 |
OLAP和OLTP在功能上越来越趋于一致,使得在有些场景下OLAP和OLTP可以相互取代,这是否意味着原有分类方法失效了呢?是否未来就不再需要数仓或者不再需要事务数据库?ClickHouse的极致性能优化能否推动OLAP和OLTP融合?回答这些问题需要理清OLAP和OLTP分类的本质。
OLTP数据库在进行数据库设计时使用实体-关系模型(Entity-Relationship Model,E-R Model,简称ER模型)。在ER模型的建模过程中有一个非常重要的规范化过程。规范化的目的在于通过一系列手段使得数据库设计符合数据规范化(Normal Form,NF)的原则。简单地说,规范化是将数据表从低范式变成高范式的过程。一般情况下,在OLTP中通常将数据规范化为第三范式(3NF)。
在规范化的过程中经常使用范式的概念,在数据库理论中共有6种范式,下面挑选3种常用的范式做简单介绍以方便读者理解后续内容。
1、第一范式
第一范式指表中的每个属性都不可分割,满足上述条件即满足第一范式。表1-2展示了一个不满足第一范式的例子,由于本例中的标签字还可以细分为性别、年龄、是否为VIP用户等多个属性,因此不满足第一范式。
▼表1-2 不满足第一范式的用户标签表
2、第二范式
第二范式是在第一范式的基础上,当表中的所有属性都被主键的所有部分唯一确定,即为满足第二范式。表1-3展示了一个不满足第二范式的例子,本例中用户ID和标签ID组成了主键,标签名称这两个属性只依赖于标签ID,用户所在地只依赖于用户ID,这两个属性都不依赖由用户ID和标签ID组成的主键。从而不满足第二范式。删除标签名称和用户所在地即可使得表格满足第二范式。
▼表1-3 不满足第二范式的用户标签表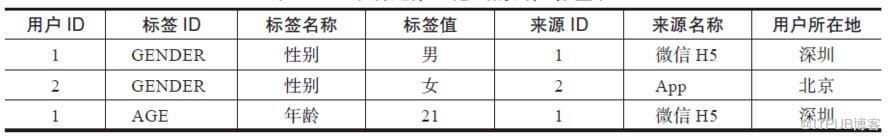
3、第三范式
第三范式是在第二范式的基础上,当表中的属性不依赖除主键外的其他属性,即为满足第三范式。表1-3中,来源名称是不满足第三范式的,因为来源名称依赖于来源ID,所以需要将来源ID删除。表1-3经过规范化之后的合格数据表应该是如表1-4、表1-5所示。
▼表1-4 合格的用户标签表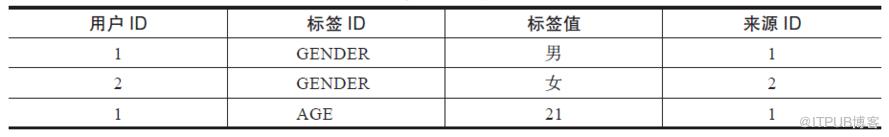
▼表1-5 合格的用户信息表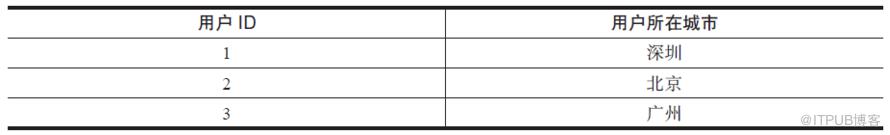
4、第零范式
不满足第一范式的所有情况都被称为第零范式。表1-2所示的是其中一种情况。数据库理论中并没有对第零范式的严格定义,由于作者在本书写作过程中会经常使用第零范式的模型设计,因此在本书中,如果没有特别说明,第零范式特指存在Map或数组结构的一类表。这类“第零范式”的表设计具备一定的实际意义,在作者的工作中,经常会用到这类设计。灵活应用这类第零范式,可能会收获意想不到效果。
一般要求在设计业务数据表时,需要至少设计到第三范式,避免出现数据冗余。从表1-3中不难发现出现了标签名称和来源名称的冗余。冗余不仅增加了数据大小,更重要的是,冗余的存在会影响数据库事务,降低数据库事务性能。
表1-6展示了一个不合格的表设计,请读者关注最后两列,很明显这是不满足第三范式的一种设计。表中的最后一列“需要权限”用于设置数据权限,表格中的数据意味着第一行和第三行需要admin权限才能查看。正常情况下没有问题,如果随着业务的变化,需要将授权级别为“2 – 非公开”的权限改为admin和manager都有权限查看。对于这种需求,如果使用表1-5的设计,就需要进行全表扫描,将数据表中所有的授权级别为2的数据全部进行修改,这会严重降低数据库性能。
▼表1-6 影响事务性能的表结构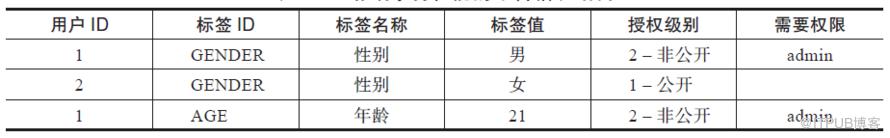
数据库规范化的意义在于通过规范化降低冗余,提高数据库事务性能。正是基于这个考虑,在数据库表设计中,会要求将对数据表进行规范化。
任何架构在有优势的情况下,一定也会有其局限。对于规范化的数据表,这句话也同样适用。规范化的数据表能够降低冗余,进而提高事务性能。同时,规范化的数据表无法支撑分析。
以表1-3~表1-5为例,表1-4和表1-5为表1-3进行规范化后的合格用户标签表。如果需要按照用户所在城市来统计年龄分布,是无法单独使用表1-4完成的。必须对表1-4和表1-5进行连接(join)操作,得到的新表才能用于分析。而在绝大多数数据库系统中,join操作的过程相对于查询来说比较慢。
通过前文的分析,我们可以得出一个推论:高范式的表适合事务处理,而低范式的表适合分析处理。从中我们可以得出数仓建模的本质:逆规范化。数仓建模本质上就是一个逆规范化的过程,将来自原始业务数据库的规范化数据还原为低范式的过程,从而用于快速分析。
在实际建模过程中,数仓经常提到的宽表本质上就是一个低范式的表。宽表将所有相关联的列全部都整合到一张表中,用于未来的分析,这样做的好处就是所有相关信息都在这张宽表中,理论上在进行分析时就不需要进行任何join操作了,因为可以直接进行相关的分析,所以提高了分析速度。这样做的缺点就是数据冗余,从而难以支持事务能力。
大部分数据仓库都是基于低范式数据集进行优化的,读者在使用OLAP引擎时一定要时刻记住这一点,避免将OLTP数据库中的原始高范式数据直接用于OLAP分析,否则分析效果可能会差强人意。而应该通过逆规范化的过程将高范式数据集还原为低范式数据集,再由OLAP进行分析。
OLAP和OLTP的本质区别在于底层数据模型的不同。OLAP更适合使用低范式的数据表,而OLTP则更适合使用高范式的数据表。无论它们之间的功能是否越来越相似,只要其底层数据模型不同,那么它们之间的区别就永远存在,结构决定功能。
ClickHouse是一个面向OLAP的数仓,很多的优化都是面向低范式数据模型的,并没有对高范式数据模型进行很好的优化。甚至在有些场景下,ClickHouse的join能力会成为整个系统的瓶颈。
ClickHouse更适合处理低范式数据集,特别是第零范式的数据集。ClickHouse对第零范式的数据集进行了比较多的优化。
在使用OLAP进行数据分析时,需要对原始数据进行维度建模,之后再进行分析。维度建模理论中,基于事实表和维度表构建数据仓库。在实际操作中,一般会使用ODS(Operational Data Store,运营数据存储)层、DW(Data Warehouse,数据仓库)层、ADS(Application Data Service,应用数据服务)层三级结构。
1、ODS层
ODS层一般作为业务数据库的镜像。在项目中,数仓工程师通常通过数据抽取工具(例如Sqoop、DataX等)将业务库的数据复制到数仓的ODS层,供后续建模使用。ODS层的数据结构和业务数据库保持一致,建立ODS的原因在于,通过复制一份数据到ODS层,可以避免建模过程直接访问业务数据库,从而对业务数据库带来影响,避免影响线上业务。
2、 DW层
将数据导入ODS层后,即可对ODS层的数据进行清洗、建模,最终生成DW层的数据。其中生成DW层的本质即为本章提到的逆规范化的过程。由于ODS中的数据本质上是业务数据库的副本,因此ODS中的数据是高范式的数据,不适合进行OLAP分析。这也导致了在进行OLAP分析前需要将高范式的ODS数据通过一些手段逆规范化到低范式的数据。低范式的数据作为DW层的数据,对外提供分析服务。
在逆规范化时,可能会产生一些中间结果,这些中间结果也可以存储于DW层中,因此在DW中有时会再次进行细分,划分成DWD(Data Warehouse Details,数据仓库明细)层、DWM(Data Warehouse Middle,数据仓库中间)层、DWS(Data Warehouse Service,数据仓库服务)层三个更细分的层次。
ODS层的数据通过清洗后存储到DWD层,DWD层本质上是一个去除了脏数据的高质量的低范式的数据层。DWD层的数据通过聚合,形成宽表并保存到DWM层中。DWM层已经是低范式的数据层了,可以用于OLAP分析。在某些场景中,可以对DWM层的数据进行业务重新聚合,以支持更复杂的业务,此时需要生成的数据保存到DWS层中。
在这3个细分的DW层中,并不是所有场景下都需要齐备的。DW层的本质就是对高范式的数据进行逆规范化,生成低范式数据的过程。读者只需要把握住这个核心即可,在实际的维度建模过程中,根据业务的实际需求进行建模,不需要在所有的场景下都机械地遵循DWD层、DWM层、DWS层的三层架构。
3、ADS层
ADS层保存供业务使用的数据的结果,DW层的数据可以用于OLAP分析,但分析过程通常比较慢,无法支撑实时的业务需求,因此需要引入ADS层作为缓存,向上支撑业务。同样的,ADS层也不是必须的,需要根据业务实际来选择,ClickHouse的高性能计算引擎可以在一定程度上取代ADS层。
ADS层数据本质上面向业务的,高度业务化的数据。可以认为是基于DW层分析的结果,很多情况下是指标、标签等计算结果。本书在后续内容中使用ADS名词时,如无特殊说明,均指基于DW层分析后的业务化的结果。
本文摘编自《ClickHouse性能之巅:从架构设计解读性能之谜》,经出版方授权发布。
推荐语:滴普合伙人兼首席架构师/资深ClickHouse专家撰写,从架构剖析ClickHouse底层逻辑,总结大量性能调优方法。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70024922/viewspace-2931144/ ,如需转载,请注明出处,否则将追究法律责任。

