来源:mikechen的互联网架构
Thrift分布式通信是分布式架构的核心组件,也是大厂经常考察的内容,下面我就全面来详解Facebook开源的Thrift框架
Thrift框架
Thrift是一个RPC框架(RPC是远程过程调用),与Dubbo类似,最初由Facebook开发,后面进入Apache开源项目,其主要特点是可以跨语言使用。
Thrift架构
Thrift架构,如下图所示:
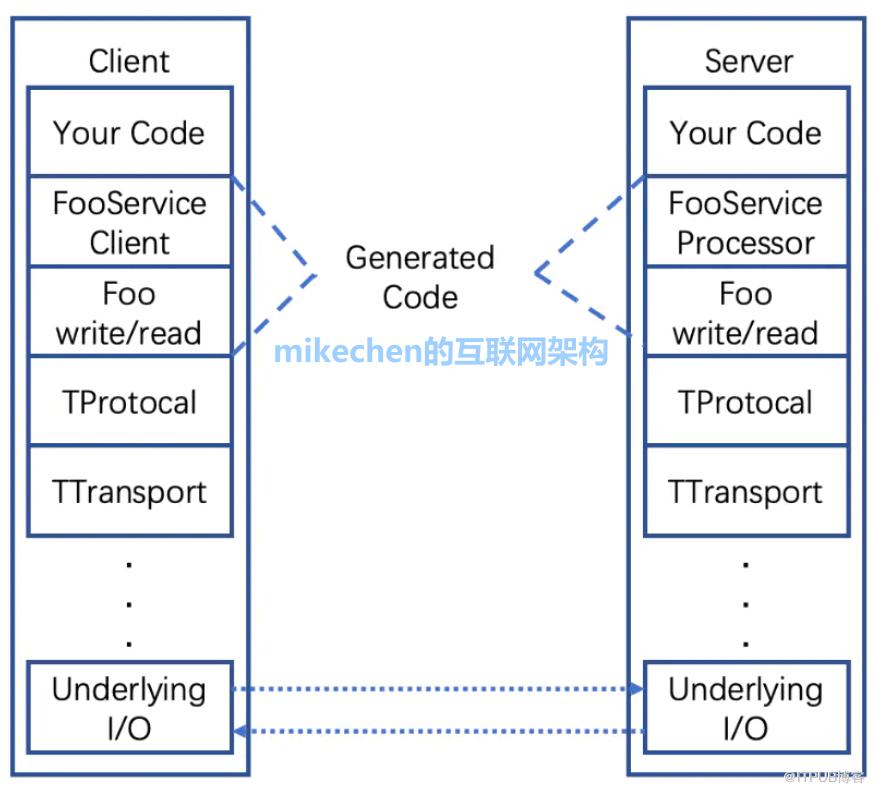
Thrift的整体架构,分为如下部分:
You Code:你的业务逻辑实现,属于业务逻辑层;
Service :客户端和服务端对应的服务 ;
TProtocol:传输协议规范,属于协议层;
TTransports :传输数据标准,负责以字节流的方式接收和发送消息体,属于传输层 ;
I/O通信:负责实际的数据传输,包括socket,文件和压缩数据流等;
Thrift原理
要理解Thrift的原理,主要是要理解RPC的实现原理,因为本质上Thrift也只是RPC框架的一种实现而已。
RPC的实现原理,分为下图所示:
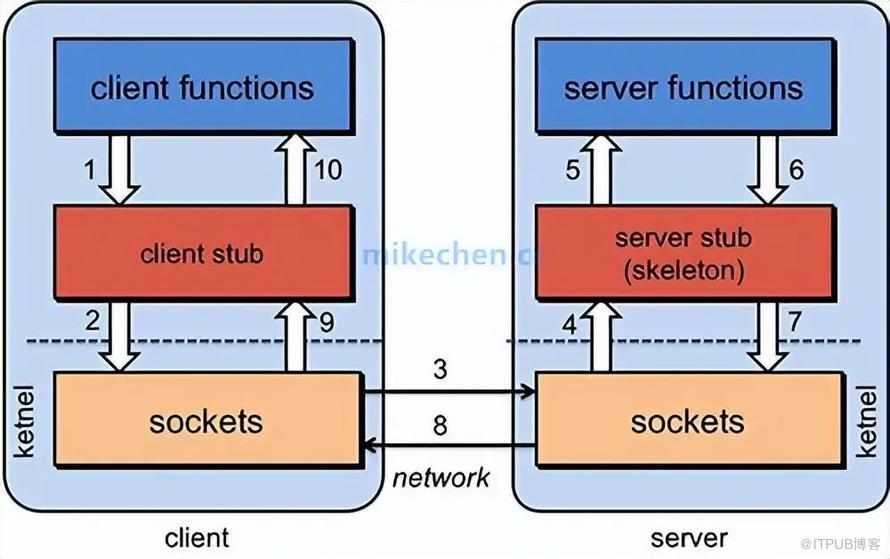
比如说,A服务器想调用B服务器上的一个方法。
Employee getEmployeeByName(String fullName)
整个调用过程,主要经历如下几个步骤:
1、建立通信
首先要解决通讯的问题:即A机器想要调用B机器,首先得建立起通信连接。
2、服务寻址
可靠的寻址方式,提供服务的注册与发现是RPC框架的实现基石。
比如:可以采用Zookeeper来注册服务,如下图所示:

关系调用说明:
服务生产者启动时,向服务注册中心注册自己提供的服务;
服务消费者启动时,在服务注册中心订阅自己所需要的服务;
注册中心返回服务提供者的地址信息个消费者;
消费者从提供者中调用服务;
3、网络传输
3.1、序列化
当A机器上的应用发起一个RPC调用时,调用方法和其入参等信息,需要通过底层的网络协议如TCP传输到B机器。
由于网络协议是基于二进制的,所有我们传输的参数数据都需要先进行序列化Serialize,然后通过寻址操作,网络传输将序列化的二进制数据发送给B机器。
3.2、反序列化
当B机器接收到A机器的应用发来的请求之后,又需要对接收到的参数等信息进行反序列化操作(序列化的逆操作),即将二进制信息恢复为内存中的表达方式。
然后再进行本地调用,一般是通过生成代理Proxy去调用,通常会涉及到Java动态代理、CGLIB动态代理、Java字节码技术等。
4、服务调用
B机器进行本地调用之后得到了返回值,此时还需要再把返回值发送回A机器。
通常,经过以上四个步骤之后,一次完整的RPC调用算是完成了。
Thrift使用
1.添加thrift依赖
<dependencies><dependency><groupId>org.apache.thrift</groupId><artifactId>libthrift</artifactId><version>0.13.0</version></dependency><dependency><groupId>org.slf4j</groupId><artifactId>slf4j-api</artifactId><version>1.7.5</version></dependency><dependency><groupId>org.slf4j</groupId><artifactId>slf4j-log4j12</artifactId><version>1.7.5</version></dependency></dependencies>
2.定义接口
定义一个thrift文件,里面写上client想要调用server端的方法,如下所示:
service hello{ string sayHello()}生成client/server接口文件,如下所示:
thrift --gen java hello.thrift
3.方法实现
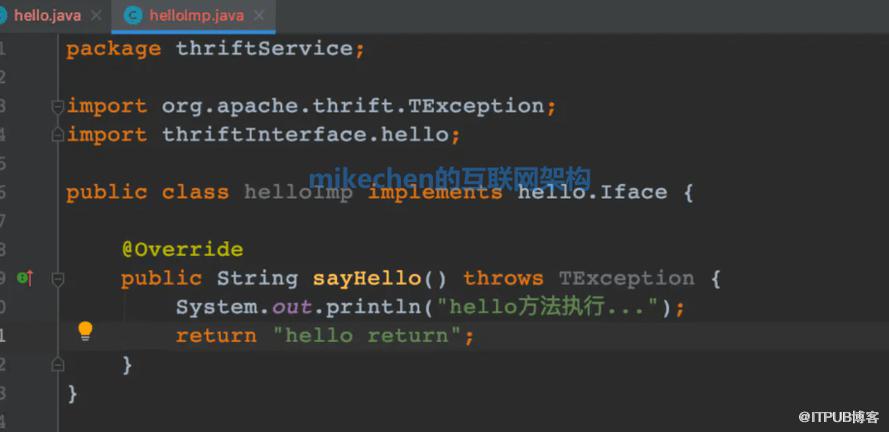
在项目中引入接口文件,并对方法进行实现,如下所示:
4.服务监控
服务端调用thrift中的方法对某一端口进行监控,如下所示:

5.客户端调用

6.执行结果
启动服务端,再启动客户端,最后执行结果,如下图所示:

以上
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70024922/viewspace-3020070/ ,如需转载,请注明出处,否则将追究法律责任。

