目前正在筹备一份更大型的开放大语言模型汇总。但在此期间,先分享一个值得注意的有趣趋势。也就是说,从全注意力向混合注意力的转变似乎仍在继续。
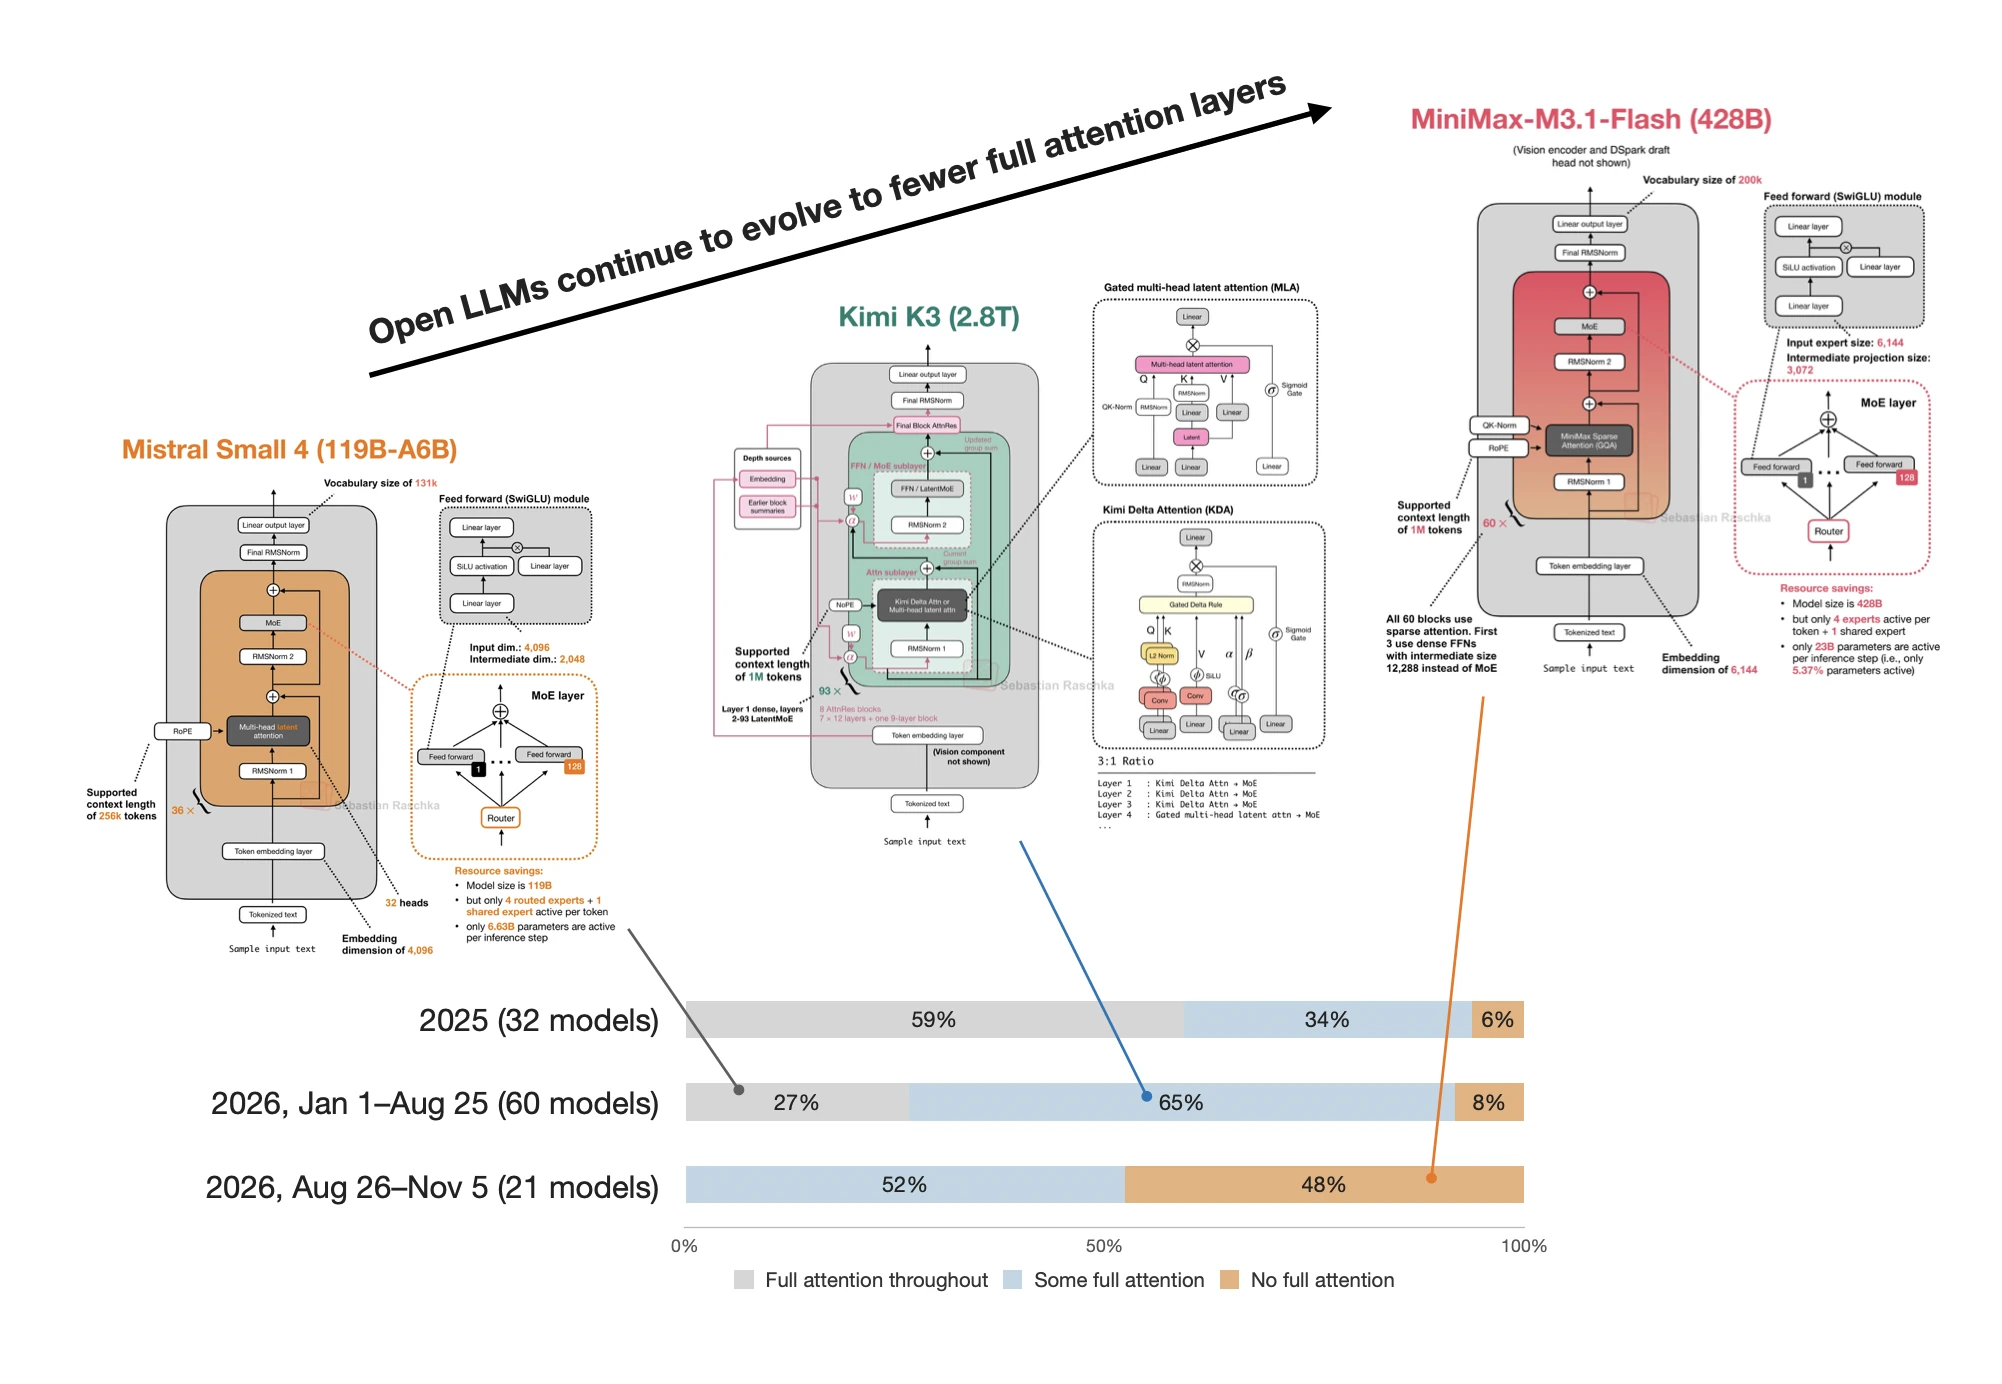
2025年,仍然有大量全注意力模型,同时出现了向“部分全注意力”混合模型转变的趋势。
2026年上半年,向“部分全注意力”混合模型发展的趋势仍在延续。
而到了2026年下半年,“部分全注意力”混合模型与完全不再使用全注意力的模型各占一半。而且,全注意力模型也已经不复存在。
图中图例的含义如下:
全程全注意力 = 每一层都使用 Global MHA、GQA、dense MLA、CCA。
部分全注意力 = 全全局注意力与以下机制混合:sliding-window/chunked attention、Gated DeltaNet、KDA、Mamba-2、Lightning Attention、卷积、稀疏注意力。
无全注意力 = 零个稠密全局层。
主要含义是,趋势正朝着让长上下文的使用成本更低的方向发展。这意味着,它使架构更适合长文档和长对话、大型代码库,当然也适合依赖大量工具调用的智能体用例。
具体来说,这里有两种不同的效率提升:
注意力计算更少,因为稀疏注意力等方法从上下文中选择 token 或块,并仅在该子集上执行昂贵的注意力操作。(请注意,它仍然可以从远处位置检索信息。)
在某些架构中,保留上下文所需的内存更少,这意味着 Gated DeltaNet 等循环层维护固定大小的状态。当然,这节省了内存,但压缩历史会给精确检索带来挑战,因此它们通常与传统注意力方法(稀疏或全注意力)混合使用。
来源:我的 Substack 笔记的网站版本,略作编辑。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/blog/2026/full-to-hybrid-attention.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

