ExecuTorch WebGPU:在浏览器中的图形处理器上运行 PyTorch 模型 - PyTorch
TL;DR
PyTorch 模型现在可以通过 ExecuTorch 在网页浏览器的 GPU(图形处理器) 上运行,无需转换为其他框架的格式。使用 torch.export 导出为 ExecuTorch .pte 文件,同一文件即可通过 ExecuTorch 新的 WebGPU 后端在任何 WebGPU 浏览器中运行。
它适用于广泛的模型:LLM(大语言模型)(如 Llama 3.2、Qwen3、Gemma 3)、视觉语言(如 SmolVLM)、分割、深度、目标检测、超分辨率和语音转文本(如 Whisper)。一切都在标签页本地运行,数据不会离开设备。可在 ExecuTorch WebGPU Playground 中试用。
在同一台机器上,WebGPU 在预填充阶段比 ExecuTorch 的 CPU 路径(Webassembly + XNNPACK)快 4–7 倍,在解码阶段快 2–10 倍。
为什么选择浏览器?
Web 是最大的部署平台,在 Chrome、Firefox 和 Safari 上拥有数十亿用户。浏览器推理通过将用户的提示、模型输入和输出保留在用户设备而非服务器上来确保隐私。这降低了网络延迟,支持离线用例,并降低了服务器端推理成本。借助 ExecuTorch WebGPU 后端,PyTorch 模型在桌面、笔记本电脑和移动设备上支持 WebGPU 的浏览器中获得了一条原生 GPU 加速推理路径。
WebGPU 是 WebGL 的现代继任者,提供原生计算着色器、共享内存、存储缓冲区和屏障,使其可直接在浏览器中进行高性能 ML 推理。如今,在浏览器中运行 PyTorch 模型通常意味着先将其转换为其他框架的格式,如 GGUF、ONNX 或 TFLite。ExecuTorch WebGPU 后端让 PyTorch 模型无需离开 PyTorch 工具链即可到达浏览器。
后端设计
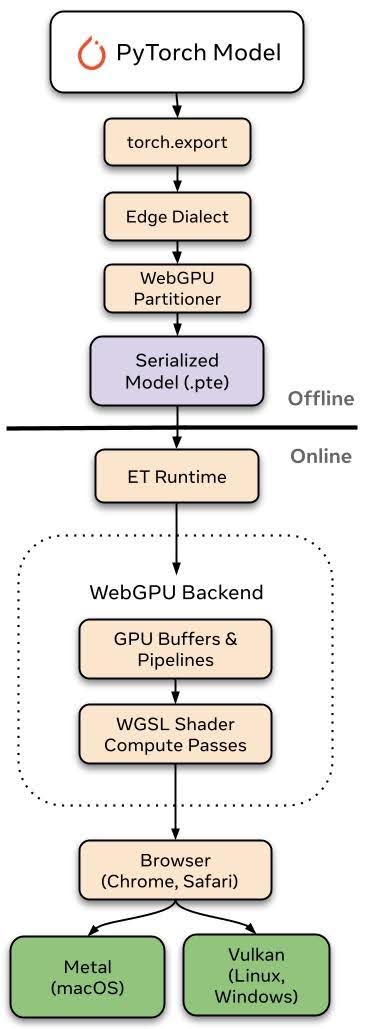
[图 1:ExecuTorch WebGPU 后端设计:PyTorch 模型导出一次为 .pte 文件,并通过 ExecuTorch Wasm 运行时在任何 WebGPU 浏览器中运行]
WebGPU 后端的设计遵循三项原则:
架构、导出和动态运行时。模型通过 ExecuTorch 的 torch.export() 和 WebGPUPartitioner 导出,并通过 WGSL 计算着色器运行。在运行时,WebGPU 运行时分配 GPU 缓冲区并将计算着色器分派到命令缓冲区。动态形状通过按最大值分配缓冲区并在每次分派时重新计算工作组来处理,以支持批量预填充,运行时将形状路由到专门的 WGSL 内核。
跨多设备和浏览器的相同产物。一个模型(.pte 文件)可在 Chrome 和 Safari 等 WebGPU 浏览器中运行,原生支持 Metal(macOS)、Vulkan(Linux/Android)和 D3D12(Windows),根据平台将 WGSL 转换为 Metal Shading Language、SPIR-V 或 HLSL。对于浏览器部署,动态 C++ 运行时通过 Emscripten 编译为 Webassembly,emdawnwebgpu 将其 WebGPU API(应用程序编程接口) 调用桥接到任何浏览器的 WebGPU JavaScript API。
终端用户零摩擦。借助 WebGPU,模型在浏览器沙箱中运行,无需原生安装、后端服务器,数据不会离开设备。对于开发者,部署是通过 CDN 在网页上提供的 .pte 文件。管道编译、内存管理和分派调度均由 WebGPU 后端处理,所有数据保留在浏览器标签页内的 GPU 设备内存中。
性能
我们在同一台机器上,使用量化后的 Llama 3.2 1B 和 Qwen3-0.6B,在 Apple M1 Pro 上的 Google Chrome 中,将 ExecuTorch WebGPU 与 ExecuTorch 自身的 Webassembly(wasm)CPU 后端(XNNPACK,多线程)进行了基准测试。每个数据点是 3 次预热后 5 次运行的中位数,覆盖 128 到 8K token 的上下文,两个后端使用相同的 token ID。两者均使用挂钟时间计时,因为 CPU 执行无法获得 GPU 时间戳。WebGPU 使用 4 位分组权重(组大小 64)和 fp32 激活;CPU 使用 XNNPACK 的 4 位权重和 8 位动态激活。

[图 2:在 Apple M1 Pro 上的 Chrome 中测量,ExecuTorch WebGPU 在预填充阶段比 ExecuTorch Wasm (XNNPACK) 快 4–7 倍,在解码阶段快 2–10 倍]
实践中的模型
我们已在架构差异很大的多个模型上验证了 WebGPU 后端,证明算子覆盖范围可推广到自回归文本生成之外:
Llama 3.2 1B(4 位量化)
Qwen2.5-0.5B(4 位量化)
Qwen3-0.6B(4 位量化)
Gemma 3 1B
视觉-语言理解
SmolVLM:图像问答与图像描述
Depth Anything V2:单目深度估计
SAM 2(SAM 2.1 Hiera Tiny):可提示图像分割
D-FINE:目标检测
Real-ESRGAN:超分辨率
Background Removal (MODNet):前景分割
Whisper (base):语音转文本
Phonon-31M-EN:文本转语音
针对 Llama 3.2 1B、Qwen2.5 0.5B 和 Qwen3 0.6B 的 LoRA 与 DiReFT 微调,面向设备端个性化助手和领域适配

[图 3:ExecuTorch WebGPU 演示]
立即体验:ExecuTorch WebGPU Playground
ExecuTorch WebGPU Playground 运行上述许多模型,全部基于同一套 WebAssembly + WebGPU 运行时。所有提示词、照片、摄像头帧和音频都不会离开你的设备。每个模型的 Hugging Face 仓库都包含 .pte 文件、模型卡以及确切的导出配方。
下一步计划
后端仍处于早期开发阶段。我们将持续提升后端的速度与稳定性,并扩展算子、数据类型和模型覆盖范围。
贡献 / 反馈
ExecuTorch 是开源的,我们非常欢迎您为 WebGPU 后端做出贡献。如果出现问题或您关注的模型不受支持,请提交 issue 或在 ExecuTorch Discord 上联系我们。我们也欢迎各种贡献,无论是新增算子、新增模型还是性能改进。
了解更多:ExecuTorch Documentation | ExecuTorch repo | WebGPU Backend
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PyTorch Blog
原创地址:https://pytorch.org/blog/executorch-webgpu-pytorch-models-on-the-gpu-in-the-browser/
原文作者:bsterling;如有侵权,请联系管理员删除。

