GLM-5.2 结合了大规模混合专家(MoE)架构、稀疏注意力和长上下文处理。在长输入长度下,这种组合会在 GPU(图形处理器) 计算、内存带宽和 GPU 间通信方面造成瓶颈。仅调优单个内核是不够的;并行化策略、KV 缓存布局、集合通信、内核和服务框架必须协同优化。
本研究聚焦于三个面向生产的基准测试选择。首先,我们使用 EvalScope 而非框架原生的基准测试客户端。其次,64K 和 128K 工作负载采用 90% 共享前缀配置,以代表前缀缓存密集型的服务场景。第三,我们将评估扩展到 100 万 token 输入。与常用的无缓存 1K 或 8K 输入形态相比,这些工作负载更贴近长上下文部署的服务级别目标(SLO)。
在本博客中,我们通过在推理栈上进行端到端优化,在八块 AMD Instinct™ MI355X GPU 上加速 GLM-5.2 FP8 推理。工作包括预填充上下文并行(CP8)、AITER 稀疏注意力(DSA)内核、PyHIP MoE 调优、自定义 all-reduce、FP8 KV 缓存优化、注意力内核调优、小内核融合、GEMM 调优以及 EAGLE 多 token 预测(MTP)。EvalScope 测量显示,64K 下峰值吞吐量从 163K 提升至 629K tok/s,128K 下从 137K 提升至 553K tok/s。在 100 万 token 输入长度和并发度为 1 时,吞吐量从 22K 提升至 157K tok/s,提升 7.16 倍。GSM8K 验证表明,优化后的栈保持了模型精度。
GLM-5.2 优化概览 #
GLM-5.2 使用 64 个注意力头和 6,144 的隐藏维度。在每一层,多头潜在注意力(MLA)将每个 token 压缩为 512 维的潜在表示和一个 64 维的旋转位置嵌入(RoPE)分量。MoE 块包含 256 个路由专家和一个共享专家,每个 token 激活八个路由专家。
我们在八块 AMD Instinct MI355X GPU 上使用 SGLang 部署 FP8 模型,面向具有高前缀缓存命中率的长上下文请求。该工作负载在推理的不同阶段对稀疏注意力、KV 缓存容量与带宽、MoE 通信和稠密矩阵乘法构成压力。仅解决单个内核会使执行路径的其他部分成为瓶颈。
优化配置使用以下核心设置:
| 领域 | 配置 |
| --- | --- |
| 预填充并行 | CP8 |
| 每 rank 注意力头数 | 64 |
| 注意力后端 | AITER DSA |
| KV 缓存 | FP8( fp8_e4m3 ) |
| MoE | PyHIP 和 AITER 优化执行 |
| 投机解码 | EAGLE:4 步,top-k = 1,5 个草稿 token |
DSA 的上下文并行 #
在张量并行(TP8)下,每个 rank 仅处理模型 64 个注意力头中的八个。然而,Lightning Indexer 为每个查询 token 选择一组 KV 索引,并在所有头之间共享,因此每个 rank 加载相同的选定 KV 条目。此路径使用的 AITER 内核还要求支持的注意力头数为 16 的倍数,这意味着八头输入必须复制到 16 头。
Prefill 上下文并行划分的是查询 token,而不是注意力头。因此,每个 rank 在处理八分之一 token 的同时保留全部 64 个头。这消除了冗余的 KV 加载和头复制,并让 MI355X 直接使用其原生 gqa:64 汇编优化的 MLA kernel。
在一个 CP rank 上处理的查询可以选择完整历史中的任意 KV 位置,包括其本地 token 分区之外的缓存前缀。我们为 CP 元数据、KV 重建与收集、张量布局以及数值边界情况添加了所需的 SGLang 支持。这些改动使 CP8 prefill 能够可靠运行,同时向下游 FP8 注意力 kernel 提供 64 头(H64)输入形状。
FP8 KV Cache 与融合查询量化 #
使用 fp8_e4m3 作为 KV cache 可减少其内存占用,并为长上下文启用 FP8 注意力 kernel。查询投影仍产生 BF16 输出,因此查询张量必须在注意力之前进行量化。
原始动态量化路径会启动多个算子并生成中间张量。我们将量化流水线融合到单个 Triton kernel 中,并复用持久设备缓冲区,从而减少 kernel 启动、临时分配和内存流量。在捕获的模型数据上进行的算子级比较验证了数值行为,本文后面的 GSM8K 验证则确认了端到端精度。
64 头 FP8 持久化 MLA #
CP8 在每个 rank 上保留全部 64 个注意力头。对于使用 FP8 查询和 FP8 KV cache 的 A8W8 执行,AITER 通过其持久化 MLA 实现处理此 H64 形状。我们提供所需的调度元数据和缓冲区生命周期管理,使原生 H64 FP8 MLA kernel 在 MI355X 上可靠运行。
MoE 执行与通信 #
使用 CP8 时,每个 GPU 最初持有八分之一的 token。标准 MoE 路径会收集 BF16 隐藏状态,然后在每个 GPU 上对完整 token 集重复执行 router 和 top-k 计算。
优化的 PyHIP 路径将 router/top-k 和激活量化移到集合通信操作之前。它收集 FP8 隐藏状态、scale 和路由结果,而不是 BF16 隐藏状态,将每个 token 的通信负载从 12,288 字节减少到 6,408 字节,并避免对非本地 token 重复执行路由工作。不支持的形状会回退到标准路径。MoE 路径还使用 AITER 的 block-scale FP8 kernel 和自定义集合通信实现来减少通信开销。
GEMM 调优 #
模型架构和并行配置会产生一组可预测的稠密 GEMM 形状。我们使用离线基准分别调优 block-scale FP8 A8W8 和 BF16 路径,并将最佳配置存储在 AITER 的调优表中。运行时,AITER 根据矩阵形状和量化类型选择调优后的 kernel。
EAGLE 多 Token 预测 #
长上下文 prefill 主要受计算和通信限制,而 decode 通常是内存受限的。优化后的技术栈支持 EAGLE 多 Token 预测(MTP),并具备请求级数据并行和专家并行,以提升 decode 效率。
为使 EAGLE 在稀疏数据并行下保持可靠,我们在各 rank 之间同步 CUDA Graph 重放与 eager 执行决策,跳过空闲 rank 的元数据生成,并按实际活跃行数设置 draft-token 后处理缓冲区的大小。这些改动可防止发散的集合通信序列和填充行影响 token、隐藏状态或位置。
8× MI355X 上的端到端性能 #
测试环境 #
| 组件 | 版本 / 配置 |
| --- | --- |
| 硬件 | 8× AMD Instinct™ MI355X GPU(gfx950) |
| ROCm | 7.2.4 |
| 基线服务器镜像 | lmsysorg/sglang-rocm:v0.5.13.post1-rocm720-mi35x-20260618 |
| 优化服务器镜像 | sabreshao/sglang:glm_0831 |
| 模型 | zai-org/GLM-5.2-FP8 |
| 基准测试框架 | EvalScope |
| API | OpenAI 兼容的 /v1/completions |
| 数据集 | EvalScope 随机数据集 |
| ISL / OSL | 64K / 1、128K / 1 和 1M / 1 |
python3
-m
pip
install
evalscope
evalscope
--version
本节使用的启动脚本和基准测试脚本已随本博客一同发布:launch_baseline.sh、launch_optimized.sh 和 run_evalscope.sh。请将它们下载到工作目录旁的 scripts/ 目录中,并在运行以下命令前使其可执行。
复现基线 #
基线使用 lmsysorg/sglang-rocm:v0.5.13.post1-rocm720-mi35x-20260618。将 MODEL_PATH 设置为准备好的 zai-org/GLM-5.2-FP8 模型目录,然后启动服务器:
MODEL_PATH
=
/path/to/GLM-5.2-FP8
./scripts/launch_baseline.sh
针对端口 30000 运行三个基准测试配置:
MODEL_PATH
=
/path/to/GLM-5.2-FP8
./scripts/run_evalscope.sh
64k
30000
MODEL_PATH
=
/path/to/GLM-5.2-FP8
./scripts/run_evalscope.sh
128k
30000
MODEL_PATH
=
/path/to/GLM-5.2-FP8
./scripts/run_evalscope.sh
1m
30000
复现优化技术栈 #
优化技术栈使用 sabreshao/sglang:glm_0831。使用相同模型启动它:
MODEL_PATH
=
/path/to/GLM-5.2-FP8
./scripts/launch_optimized.sh
对端口 30001 运行相同的配置文件:
MODEL_PATH
=
/path/to/GLM-5.2-FP8
./scripts/run_evalscope.sh
64k
30001
MODEL_PATH
=
/path/to/GLM-5.2-FP8
./scripts/run_evalscope.sh
128k
30001
MODEL_PATH
=
/path/to/GLM-5.2-FP8
./scripts/run_evalscope.sh
1m
30001
基准测试脚本会应用测试环境表中所示的、针对特定配置文件的输入长度和并发设置。它在每个用例前都会刷新前缀缓存。
性能结果 #
以下表格报告了零请求失败用例的 EvalScope 总吞吐量。它们重点关注 prefill,在此 SLO 下 prefill 主导端到端时间。
64K 吞吐量 #
| 并发数 | 基线 (tok/s) | 优化后 (tok/s) | 加速比 |
| --- | --- | --- | --- |
| 1 | 97,998 | 167,839 | 1.71× |
| 2 | 152,796 | 281,523 | 1.84× |
| 4 | 162,559 | 397,922 | 2.45× |
| 8 | 157,990 | 478,381 | 3.03× |
| 16 | 157,298 | 569,362 | 3.62× |
| 32 | 158,977 | 618,794 | 3.89× |
| 50 | 158,201 | 628,866 | 3.97× |
峰值吞吐量从基线在并发数 4 时的 163K tok/s 提升到优化后技术栈在并发数 50 时的 629K tok/s。如下方图 1 所示,基线在并发数 4 之后趋于平缓,而优化后技术栈持续扩展至并发数 50。
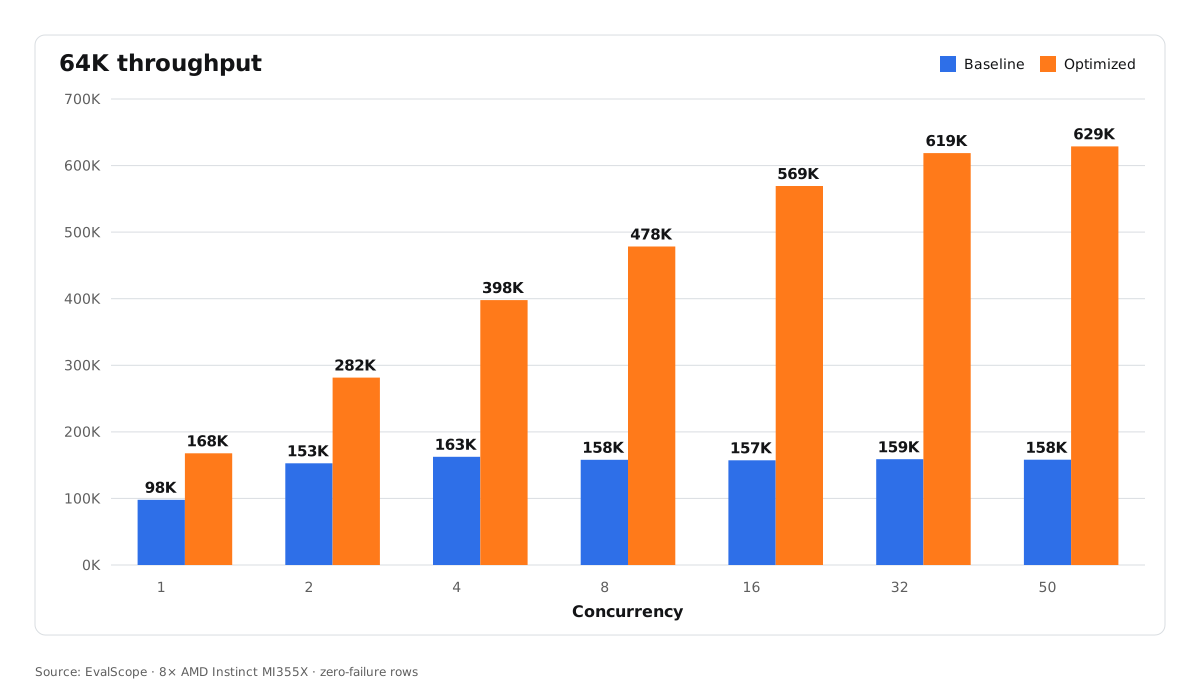
图 1. 在 64K 输入长度下,基线与优化后 GLM-5.2 在不同并发级别下的吞吐量。根据上表绘制;图片来源:glm52-prefill-throughput-64k.svg 。
128K 吞吐量 #
| 并发数 | 基线 (tok/s) | 优化后 (tok/s) | 加速比 |
| --- | --- | --- | --- |
| 1 | 106,036 | 215,096 | 2.03× |
| 2 | 136,726 | 304,338 | 2.23× |
| 4 | 124,239 | 455,493 | 3.67× |
| 8 | 130,170 | 552,896 | 4.25× |
| 16 | 130,413 | 535,466 | 4.11× |
| 32 | 131,037 | 553,018 | 4.22× |
| 50 | 130,591 | 528,439 | 4.05× |
峰值吞吐量从并发数 2 时的 137K tok/s 提升到并发数 32 时的 553K tok/s。下方图 2 显示了与 64K 时相同的模式,随着并发数增长,两个技术栈之间的差距不断扩大。
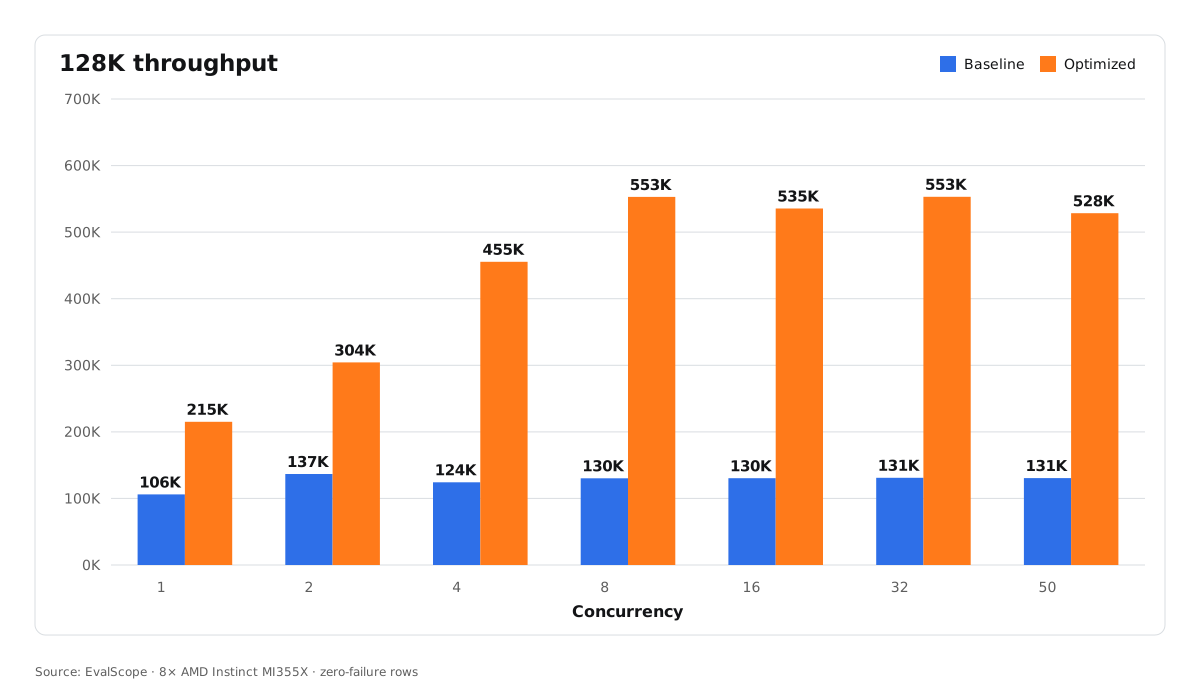
图 2. 在 128K 输入长度下,基线与优化后 GLM-5.2 在不同并发级别下的吞吐量。根据上表绘制;图片来源:glm52-prefill-throughput-128k.svg 。
1M 吞吐量与延迟 #
| 配置 | 总吞吐量 (tok/s) | 平均 TTFT (ms) |
| --- | --- | --- |
| 基线 | 21,877 | 45,660 |
| 优化后 | 156,598 | 6,340 |
在并发数为 1 时,优化后的技术栈在 1M token 输入长度下实现了 7.16 倍的吞吐量提升。下图 3 将该提升与平均 TTFT 的相应下降并列展示,从 45,660 ms 降至 6,340 ms。
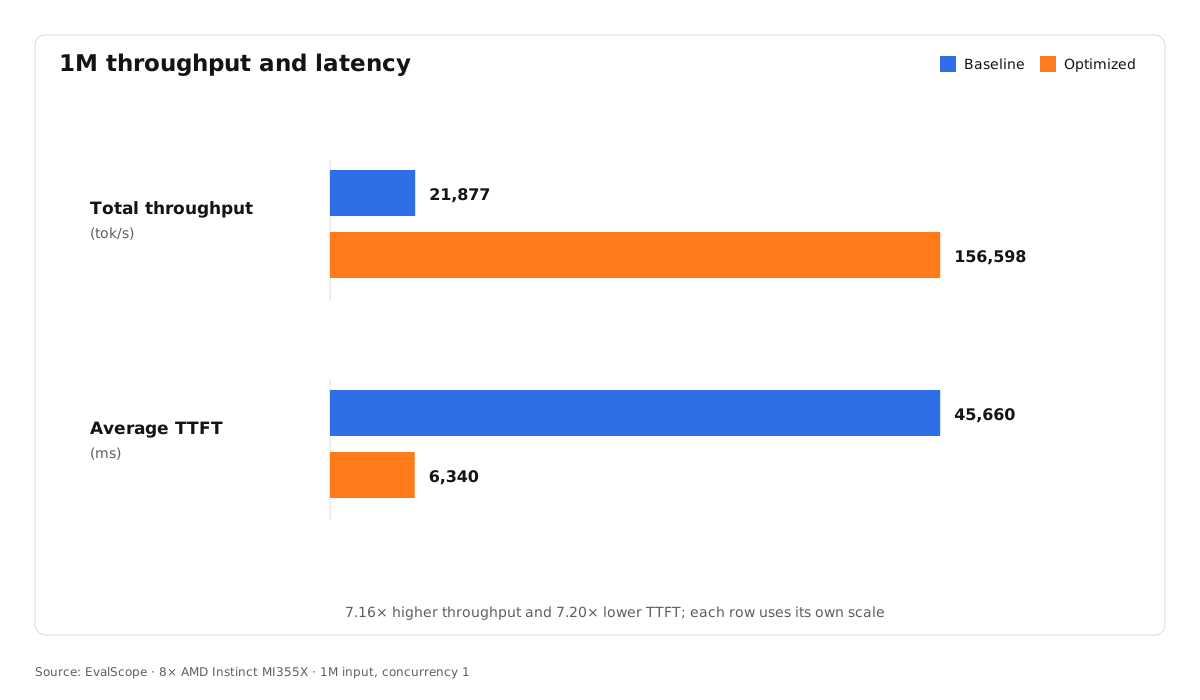
图 3. 在 1M 输入长度和并发数为 1 时,基线版与优化版 GLM-5.2 的吞吐量和平均 TTFT。数据取自上表;图片来源:glm52-prefill-throughput-1m.svg。
精度验证 #
GSM8K(5-shot,完整 1,319 样本测试集)显示,启用优化后的技术栈后精度没有回退。
| 配置 | 正确 / 总数 | 精度 |
| --- | --- | --- |
| 基线 | 1242 / 1319 | 94.16% |
| 优化后(本工作) | 1252 / 1319 | 94.92% |
两种配置均使用确定性采样的顺序 /v1/completions 请求。优化后的运行以零请求错误完成。
总结 #
本博客演示了如何在八块 AMD Instinct MI355X GPU 上优化 GLM-5.2 FP8 推理,以面向生产环境的长上下文工作负载。EvalScope 基准测试在 64K 和 128K 输入长度下使用 90% 共享前缀,并额外评估了 1M token 输入。
峰值预填充吞吐量在 64K 下从 163K 提升至 629K tok/s,在 128K 下从 137K 提升至 553K tok/s。在 1M token 输入和并发数为 1 时,吞吐量从 22K 提升至 157K tok/s,提升 7.16 倍。优化后的技术栈还实现了 94.92% 的 GSM8K 精度,而基线为 94.16%。
这些收益源于对完整推理路径的优化:CP8 预填充、AITER DSA 和持久化 MLA 内核、FP8 KV 缓存、融合查询量化、PyHIP MoE 和通信调优、调优后的 GEMM 配置以及 EAGLE MTP。这些技术共同为在保持模型质量的同时,以长输入和频繁复用前缀的方式服务 GLM-5.2 提供了可扩展的基础。
免责声明 #
本文档中提供的信息仅供参考,可能包含技术不准确之处、遗漏和排版错误。本文所含信息可能会发生变化,并可能因多种原因而变得不准确,包括但不限于产品和路线图变更、组件和主板版本变更、新模型和/或产品发布、不同制造商之间的产品差异、软件变更、BIOS 刷新、固件升级等。任何计算机系统都存在无法完全预防或缓解的安全漏洞风险。AMD 不承担更新或以其他方式更正或修订此信息的义务。但是,AMD 保留修订此信息并随时更改其内容的权利,且无义务通知任何人此类修订或更改。此信息按“原样”提供。AMD 不对本文档内容作出任何陈述或保证,也不对本文信息中可能出现的任何不准确、错误或遗漏承担任何责任。AMD 明确否认任何关于不侵权、适销性或特定用途适用性的默示保证。在任何情况下,AMD 均不对任何人因使用本文所含任何信息而导致的任何依赖、直接、间接、特殊或其他后果性损害承担责任,即使 AMD 已明确被告知此类损害的可能性。
第三方内容由拥有该内容的第三方直接向您授权,而非由 AMD 向您授权。所有链接的第三方内容均按“原样”提供,不附带任何形式的保证。使用此类第三方内容完全由您自行决定,在任何情况下 AMD 均不对任何第三方内容向您承担责任。您承担所有风险,并对因使用此类第三方内容而可能产生的任何损害承担全部责任。
AMD、AMD Arrow 标志、AMD Instinct、ROCm 及其组合是 Advanced Micro Devices, Inc. 的商标。本出版物中使用的其他产品名称仅用于识别目的,可能是其各自公司的商标。© 2026 Advanced Micro Devices, Inc. 保留所有权利。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:AMD ROCm Blog
原创地址:https://rocm.blogs.amd.com/artificial-intelligence/glm5.2-mi355x-kvcache/README.html
原文作者:Qili Huang, Sabre Shao, Lily Liang, Diwakar Das, R;如有侵权,请联系管理员删除。

