JavaScript 框架的 AI 成本
发布于 2026 年 10 月 28 日,作者 Nolan Lawson,分类:Web、AI。
我对 Web 开发社区的一大不满是,我们做出的许多决定都基于感觉。框架“快如闪电”,工具会“超级增强”你的开发,正确的抽象会让开发者和用户都受益(DX 和 UX 一举两得!)。所有这些大言不惭的吹嘘通常都没有任何证据。Alex Russell 称之为“前端失去的十年”,Baldur Bjarnason 称编程是一种流行文化,而我则试图在自己的博客中用事实和基准测试来对抗这一趋势(至少在我状态最好的时候)。
很长一段时间里,我们社区对证据的过敏似乎是由对更高 DX 的渴望驱动的。换句话说,开发者就是喜欢在 React 中敲 JSX 的感觉,而推崇 React 或相关工具(“虚拟 DOM 很快!”)的论调,很大程度上是为这些最初的直觉感受辩护的事后合理化。(Jonathan Haidt 很可能会同意这个判断。)
但在智能体时代,开发者不再手写代码,因而受 DX 的约束更少,我仍然看到感觉主导一切(而且不只是“氛围编程”意义上的)。前端被重写,是因为某个框架“对智能体更友好”。(有人想过问问智能体吗?)重写后的代码“更快”,智能体“犯的错误更少”,等等。同样,这些说法往往没有证据。每当我读到这类说法时,我都会想:“基准测试在哪里?”
好吧,我很好奇,所以我写了一个基准测试。这个基准测试的结构相当直接:
- 使用 PokéAPI 设计一个小巧但不简单的 Pokémon 应用(关注我作品的人不会感到意外)
- 指示智能体用特定的 JavaScript 框架/元框架(例如 Next.js、Nuxt、SvelteKit 等)构建该应用
- 用规范符合性测试套件测试输出(以防智能体作弊)
- 从开发时间、消耗的 token 数、代码行数以及 Lighthouse 中的性能和可访问性得分来评估结果
这个应用相当简单:你有一个 Pokémon 列表,包含它们的属性、招式以及来自各游戏的数据。你可以搜索、筛选等:
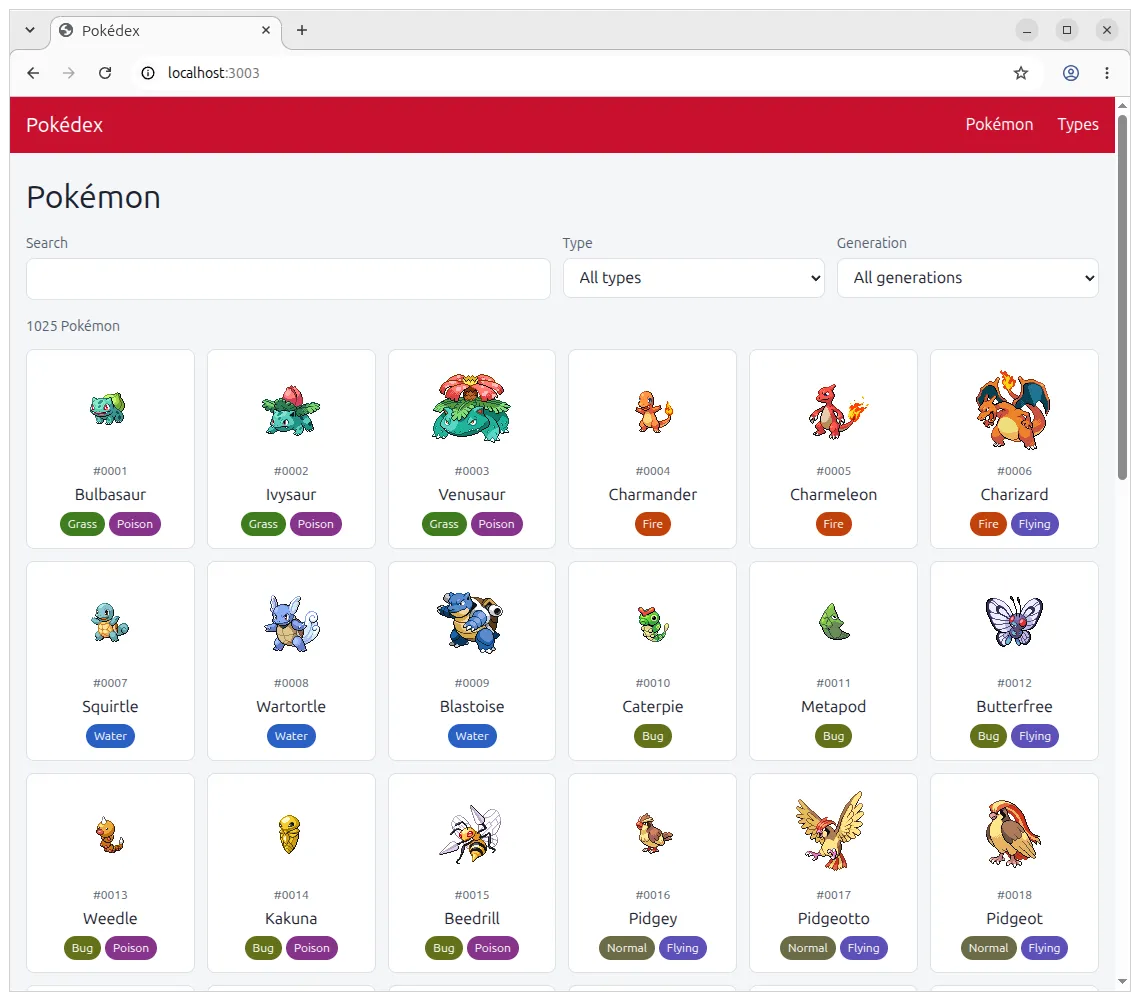
我应该先说明一些注意事项:这不是一个完美的实验。这个应用只代表一种原型——它是一个相对以内容为主的网站,交互性很少,更接近 Wikipedia 而不是 Figma、GMail 等。话虽如此,我总得选一个应用来构建,而这个应用至少在高层次上容易理解,并且相对容易编写规范和测试。
为了尽量公平,我让每个框架/元框架使用该工具的官方 MCP 或 skills。我想避免被指责“这个框架在训练数据中代表性不足,这就是我们构建 MCP 的原因,我们期望人们使用它”等等。我也没有过度指定要使用的确切架构(例如 SSR 与 CSR),也没有指定应用应尽可能高性能。我只是把规范交给 Opus 5.5,并设置高 effort,告诉它使用给定框架的最新版本。每个智能体都在沙箱中运行,并且不知道它将在 Lighthouse 中接受性能和可访问性测试,尽管它获得了符合性测试套件。
注意,我也没有强制任何 CSS 方法论,只是避免使用 Tailwind、Bootstrap 或任何其他组件框架,并基于一组规范 token 进行设计,以强制实现一定的视觉一致性。我不想让这个测试完全围绕 CSS,而是围绕 JS 框架、CSR 与 SSR、SPA 与 MPA 等。生成的应用基于可访问性树而非原始 DOM 的符合性套件进行测试,以避免强制任何特定的 HTML 结构——有一个框架使用了依赖 shadow DOM 的 Web Components,所以这是必需的。
我从这个实验中学到的一件事是,我所测量的一切都非常随机。大语言模型是随机词生成器,所以有时你会掷出低点数,智能体就会跑偏到某个奇怪的思路上,浪费大量 token,而这并非框架或其工具的过错。Lighthouse 本身也可能给出不一致的结果:最大内容绘制(LCP)可能判定某张图片是“最大”元素,然后在下次运行时又选择另一张。很难有一个完全公平的实验,但运行多次迭代确实有帮助,我也尽量对方差保持诚实。
废话少说,让我们来看结果。
结果
我将从多个维度来拆解:构建成本、质量和可维护性。对于每个框架/元框架,我取 5 次运行的中位数:换句话说,我在同一框架中构建了同一个应用 5 次。(是的,这就是如今用编码智能体可以做的疯狂事情。)
例外是 Angular,它两次未能创建可用的应用,所以我改用了 3 次迭代。(下文会解释。)
成本
| 框架 | 成本($) |
| --- | --- |
| Hono+htmx | $2.67 (2.23–3.19) −0.44 +0.52 |
| Astro | $2.76 (2.16–3.63) −0.60 +0.87 |
| Nuxt | $2.82 (2.39–4.25) −0.43 +1.43 |
| Vanilla | $2.98 (2.24–3.37) −0.74 +0.39 |
| Next.js | $3.14 (2.58–4.13) −0.56 +0.99 |
| Qwik | $3.27 (2.35–3.80) −0.92 +0.53 |
| TanStack Start | $3.54 (3.11–3.96) −0.43 +0.42 |
| SolidStart | $3.79 (2.84–4.81) −0.95 +1.02 |
| React Router | $3.81 (2.82–3.97) −0.99 +0.16 |
| SvelteKit | $4.28 (3.59–4.65) −0.69 +0.37 |
| Gracile+Lit | $4.65 (3.92–5.07) −0.73 +0.42 |
| Angular | $4.97 (3.19–6.82) −1.78 +1.85 |
|  | 0 2 4 6 8 |
请注意,这里直接引用了 Claude Code 的 API(应用程序编程接口) 价格,并不代表我实际花了多少钱。我使用的是 Max 套餐,所以这只是我每月 100 美元总支出的一部分。
还要注意方差:React Router 的中位数比 Hono+htmx 大约贵 1 美元,但 React Router 最便宜的版本($2.82)仍然比 Hono+htmx 最贵的版本($3.19)便宜。不过,一些可靠的模式确实浮现了出来。
最明显的是,SvelteKit、Gracile+Lit 和 Angular 的构建成本高于其他框架。对于 SvelteKit,这可能是因为智能体在每次运行中都阅读了 SvelteKit v3 迁移指南,很可能是因为它太新,不在 Opus 5.5 的训练数据中。Gracile 类似,智能体对该框架不太了解,要么克隆了 Gracile 仓库,要么从 node_modules 读取其编译后的源码。对于 Angular,这似乎是总代码量的函数(见下文)。
我还应该提到,并非每个智能体都使用了 MCP/skill/Claude Code 插件,也并非每个框架都有这样的插件:
| 框架 | 已安装 | 智能体是否使用? |
| --- | --- | --- |
| Angular | Angular MCP 和 Angular agent skills | 3/5 次运行使用 MCP,4/5 次运行使用 skill 工具,2/5 次使用 skill 文件 |
| Astro | Astro MCP server | 2/5 次运行使用 MCP |
| Gracile+Lit | 不适用 | 不适用 |
| Hono+htmx | Hono skills | 5/5 次运行使用 Skill 工具 |
| Next.js | next-devtools-mcp 和 next-dev-loop skill | 1/5 次运行使用 skill 文件,2/5 次运行使用 AGENTS.md |
| Nuxt | Nuxt MCP | 不适用 |
| Qwik | 不适用 | 不适用 |
| React Router | React Router skill | 5/5 次运行使用 Skill 工具,5/5 次运行使用 skill 文件 |
| SolidStart | 不适用 | 不适用 |
| SvelteKit | Svelte Claude Code plugin | 5/5 次运行使用 MCP |
| TanStack Start | 不适用 | 2/5 次运行使用 skill 文件 |
| Vanilla | 不适用 | 不适用 |
例如,TanStack Start 的智能体只在 2/5 次运行中发现了其 skill 文件(它们随项目的 node_modules 一起提供)。对于 Nuxt,MCP 从未被智能体使用。对于 Next.js,智能体只在 1/5 次运行中阅读了 skill 文件,在 2/5 次运行中阅读了 AGENTS.md。结果范围很广,这又指向了 LLM(大语言模型) 的随机性。不过,我仍然认为这是一个有效的实验,因为我怀疑没有多少 vibe-coder 会用全大写字母对智能体大喊要使用 MCP(而且很多人可能完全跳过了它)。
另外,如果你想知道我是怎么想到 Hono+htmx 的:基本上,我想以某种方式代表 htmx,而 Hono 似乎是一个不错的搭配(即作为 Rails/Django 等的 JavaScript 替代品)。至于 Gracile+Lit,我想通过其标准承载框架(Lit)来代表 Web Components,并且只知道 Gracile 是一个元框架。如果有更好的候选者,那么它们将非常适合后续实验。
对于“Vanilla”,请注意,智能体被要求使用“vanilla JavaScript 或 TypeScript 配合 Vite,不使用 UI 框架”。令人惊讶的是,它的表现不如几个框架,这似乎表明拥有一些框架总比没有好(或者至少比原始 Vite 好)。选择 Vite 是因为它支撑了许多框架,并且代表了相当标准和通用的 JavaScript 基础设施。
总时间和 token 数量与成本密切相关:
| 框架 | 时间(分钟) |
| --- | --- |
| Astro | 8.2 分钟 (6.2–9.7) −2.0 +1.5 |
| Hono+htmx | 8.6 分钟 (5.9–9.6) −2.7 +1.0 |
| Nuxt | 9.0 分钟 (8.0–17.6) −1.0 +8.6 |
| Vanilla | 10.1 分钟 (6.9–18.6) −3.2 +8.5 |
| TanStack Start | 10.3 分钟 (8.3–13.9) −2.0 +3.6 |
| Qwik | 10.7 分钟 (7.1–12.9) −3.6 +2.2 |
| SvelteKit | 10.8 分钟 (8.6–13.8) −2.2 +3.0 |
| Next.js | 10.9 分钟 (8.3–11.9) −2.6 +1.0 |
| SolidStart | 11.2 分钟 (8.2–15.9) −3.0 +4.7 |
| Gracile+Lit | 12.1 分钟 (10.8–12.9) −1.3 +0.8 |
| React Router | 12.5 分钟 (8.4–13.6) −4.1 +1.1 |
| Angular | 17.2 分钟 (9.8–23.7) −7.4 +6.5 |
|  | 0 5 10 15 20 25 |
从智能体视角的挂钟分钟数。3-5 次运行的中位数。
| 框架 | Token 数(百万) |
| --- | --- |
| Nuxt | 3.85 M (3.16–8.18) −0.69 +4.33 |
| Astro | 4.13 M (3.03–7.57) −1.10 +3.44 |
| Hono+htmx | 4.26 M (3.40–5.61) −0.86 +1.35 |
| Next.js | 4.99 M (3.54–8.82) −1.45 +3.83 |
| Vanilla | 5.00 M (3.44–6.32) −1.56 +1.32 |
| Qwik | 5.64 M (3.41–7.03) −2.23 +1.39 |
| TanStack Start | 7.07 M (5.85–7.99) −1.22 +0.92 |
| SolidStart | 7.13 M (5.02–10.07) −2.11 +2.94 |
| React Router | 7.58 M (4.55–8.18) −3.03 +0.60 |
| SvelteKit | 8.53 M (6.79–9.29) −1.74 +0.76 |
| Gracile+Lit | 9.04 M (7.36–11.10) −1.68 +2.06 |
| Angular | 9.76 M (4.92–14.94) −4.84 +5.18 |
|  | 0 5 10 15 |
缓存读取、未缓存输入和输出。3-5 次运行的中位数。
顺便说一下,token 数是由 Claude Code 报告的。持续时间只是总挂钟时间。
质量
当然,因为我认为结果很重要,所以我也用 Lighthouse 测试了这些智能体。作为软件开发者,我认为我们不仅要低成本地构建东西,还要保证性能和可访问性,这一点很重要。
我首先应该说明关于我的基准测试的两个注意事项:
- Pokémon 应用很小,不能代表大型、复杂的真实世界应用程序。
- Lighthouse 和 Core Web Vitals 总体上对 SPA 有偏见,因此 MPA 框架几乎肯定会在总阻塞时间(TBT)、JavaScript 字节数等指标上获胜。我考虑过添加一些应用内性能指标,但放弃了,因为它增加了基准测试的复杂性和可变性,而且这些指标是我自己发明的,而不是行业标准。
为简单起见,我只报告首页的分数。还有其他页面,但它们的得分都相当相似,或者像 LCP 这样的指标波动很大,所以包含它们只会让事情复杂化。
简而言之:Lighthouse 在性能、可访问性和 CLS(累积布局偏移)方面的得分几乎饱和,且不同框架之间差异不大:
| 框架 | CLS | 性能 | 可访问性 |
| --- | --- | --- | --- |
| Angular | 0.000 | 98 | 100 |
| Astro | 0.000 | 100 | 100 |
| Gracile+Lit | 0.000 | 100 | 100 |
| Hono+htmx | 0.000 | 100 | 100 |
| Next.js | 0.000 | 99 | 100 |
| Nuxt | 0.000 | 100 | 100 |
| Qwik | 0.000 | 100 | 100 |
| React Router | 0.000 | 100 | 100 |
| SolidStart | 0.000 | 100 | 100 |
| SvelteKit | 0.000 | 100 | 100 |
| TanStack Start | 0.000 | 99 | 100 |
| Vanilla | 0.111 | 97 | 100 |
因此,要获得更有意义的数字,我们需要查看其他指标。最可靠的指标是发送的 JavaScript 字节数,这很大程度上反映了客户端框架的大小:
| 框架 | JS (KiB) |
| --- | --- |
| Astro | 0 KiB (0–1) −0 +1 |
| Vanilla | 7 KiB (6–7) −1 +0 |
| Gracile+Lit | 8 KiB (1–13) −7 +5 |
| Hono+htmx | 18 KiB (18–18) −0 +0 |
| SvelteKit | 36 KiB (35–36) −1 +0 |
| SolidStart | 40 KiB (38–40) −2 +0 |
| Qwik | 40 KiB (40–41) −0 +1 |
| Nuxt | 84 KiB (83–85) −1 +1 |
| Angular | 93 KiB (81–102) −12 +9 |
| React Router | 115 KiB (115–119) −0 +4 |
| TanStack Start | 118 KiB (112–119) −6 +1 |
| Next.js | 142 KiB (136–143) −6 +1 |
|  | 0 50 100 150 |
数据由 Lighthouse 报告。取 3-5 个应用的中位数。
总阻塞时间(TBT)的有趣之处在于,它并非纯粹由 JavaScript 字节数决定;有些应用在主线程上花费的时间比其他应用更多。尽管如此,这些数字都相当小:
| 框架 | TBT (ms) |
| --- | --- |
| Astro | 0 ms (0–0) −0 +0 |
| Gracile+Lit | 0 ms (0–0) −0 +0 |
| Hono+htmx | 0 ms (0–0) −0 +0 |
| SvelteKit | 0 ms (0–1) −0 +1 |
| Vanilla | 0 ms (0–0) −0 +0 |
| TanStack Start | 1 ms (0–36) −1 +35 |
| Qwik | 3 ms (0–30) −3 +27 |
| SolidStart | 11 ms (0–12) −11 +1 |
| React Router | 17 ms (0–52) −17 +35 |
| Nuxt | 40 ms (14–54) −26 +14 |
| Next.js | 71 ms (66–121) −5 +50 |
| Angular | 103 ms (93–123) −10 +20 |
|  | 0 25 50 75 100 125 |
数据由 Lighthouse 报告,模拟移动端节流。每个应用取 5 次 Lighthouse 运行的中位数,然后再取 3-5 个应用的中位数。
最大内容绘制(LCP)由于上述指标本身的问题而高度可变。不过,正如预期的那样,它总体上对 SPA 不利,对 MPA 有利:
| 框架 | LCP (ms) |
| --- | --- |
| Astro | 810 ms (792–1662) −18 +852 |
| Gracile+Lit | 956 ms (796–980) −160 +24 |
| Hono+htmx | 978 ms (977–1662) −1 +684 |
| Qwik | 979 ms (954–1278) −25 +299 |
| SvelteKit | 1130 ms (1129–1131) −1 +1 |
| SolidStart | 1204 ms (1203–1278) −1 +74 |
| Vanilla | 1667 ms (764–1676) −903 +9 |
| Nuxt | 1727 ms (1427–1844) −300 +117 |
| React Router | 1729 ms (1729–1770) −0 +41 |
| Angular | 1954 ms (1351–1955) −603 +1 |
| TanStack Start | 2028 ms (1805–2104) −223 +76 |
| Next.js | 2090 ms (1028–2187) −1062 +97 |
|  | 0 500 1000 1500 2000 2500 |
数据由 Lighthouse 报告,模拟移动端节流。每个应用取 5 次 Lighthouse 运行的中位数,然后再取 3-5 个应用的中位数。
请注意,Next.js 数字的巨大差异可以解释为:其中一个应用避免了图片懒加载,而其他四个没有。Astro 和 Vanilla 也有类似的波动,似乎是由优先级或 LCP 的怪癖引起的。
不过总的来说,这个指标倾向于奖励那些用 HTML 快速完成绘制的 MPA,而不是在客户端 JavaScript 运行后才完成绘制的 SPA(后者可能还需要多次受节流的往返请求来获取 Pokémon 数据),这并不令人意外。忽略方差的话,这里的 LCP 主要取决于 JavaScript 包的大小。(Qwik 在这里是个明显的例外:从技术上讲,它是一个使用客户端路由的 SPA,但它的得分却处于 MPA 框架之列。)
不过要注意,一些框架在更侧重客户端还是服务端上存在差异,甚至是否使用客户端框架也各不相同。例如,Gracile 智能体在两次运行中甚至根本没有使用 Lit。对于“Vanilla”,智能体拥有完全的自由(除了被要求使用 Vite),但它在全部 5 次运行中仍然选择构建 SPA。
SSR 与 CSR 的差异也部分地解释了 Angular 遇到的问题:在 2 次运行中,智能体构建了一个 SSR 应用,但该应用拒绝非 localhost 的请求(尽管指令中明确说明该应用会位于反向代理之后)。我认为这属于未遵循规范的合理失败,并决定不重新运行这 2 次失败的迭代。
可维护性
衡量可维护性的方法有很多(包括圈复杂度之类的高级指标),但我决定保持简单,报告一个久经考验的指标:代码总行数。
| 框架 | 代码行数 |
| --- | --- |
| Hono+htmx | 1370 (1264–1489) −106 +119 |
| Nuxt | 1415 (1382–1458) −33 +43 |
| Astro | 1461 (1379–1503) −82 +42 |
| Vanilla | 1492 (1437–1742) −55 +250 |
| Next.js | 1539 (1452–1627) −87 +88 |
| React Router | 1564 (1421–1621) −143 +57 |
| SvelteKit | 1611 (1503–1816) −108 +205 |
| SolidStart | 1630 (1528–1894) −102 +264 |
| TanStack Start | 1697 (1506–1771) −191 +74 |
| Gracile+Lit | 1717 (1412–1748) −305 +31 |
| Qwik | 1744 (1646–1827) −98 +83 |
| Angular | 2009 (2003–2051) −6 +42 |
|  | 0 500 1000 1500 2000 2500 |
非空源文件行数。取 3-5 个应用的中位数。
对我来说,这是比较有趣的图表之一。从某种意义上说,框架的全部意义就在于减少你需要维护的代码量。用 Rich Harris 令人难忘的话来说:
“框架不是用来组织代码的工具,而是用来组织思维的工具。”——Rich Harris,《重新思考响应式》
在智能体时代,这一点更加重要,因为代码规模最终会影响 token 数量,包括在未来的编辑中,这意味着它会影响随着时间推移维护代码库的实际成本。这并不意味着简洁是唯一重要的价值,但看到 Hono+htmx 能用约 70% 的代码完成与 Angular 大致相同的事情(而且速度还更快),这确实很有趣。
结论
有很多方法可以改进这个基准测试。例如,你可以要求智能体使用 Service Workers 进行离线缓存,或者优化 Pokémon 图片文件,或者使用懒加载、fetchpriority、Speculation Rules API 等。尽管我知道很多这类性能技巧,但我故意没有引导智能体使用其中任何一种,因为这不是一个典型的 vibe-coder 会做的事情。
另一方面,整个基准测试可以通过将所有 HTML 文件预生成为静态资源来作弊(宝可梦的数量是有限的)。我在说明中明确禁止了这种做法,并在测试框架中将其设为显式检查,因为我认为这不符合基准测试的精神。(我的目标是模拟大量可能动态变化的数据,这比纯静态站点更具挑战性。)
你也可以通过运行更多迭代、使用不同的编码智能体、尝试不同的努力程度、使用不同的框架或框架的不同版本、尝试使用和不使用 MCPs/skills、在 Chromium 之外的更多浏览器中测试、构建不同类型的应用等方式来改进我运行基准测试的方式。我主要出于时间考虑没有做这些事情。不过,如果有人想自己运行基准测试或 fork 它,它在 GitHub 上,所以我鼓励你尽情发挥。我很乐意在这里报告你的结果(以及你可能发现的任何错误或缺陷)。
我在这里的目标不是为“我是个 vibe-coder,我应该选择哪个框架?”编写终极基准测试。这篇文章的重点是证明在 AI 编码时代,仍然有可能基于证据而非感觉来做决策。基准测试本身很大程度上是 vibe-coded 的,尽管我确实审查了代码,所以如果有错误,请视为我的错误。我也非常乐意看到竞争框架尝试改进我在这里所做的工作。
我也不是试图诋毁任何特定框架。在运行基准测试之前,我不知道哪个会“赢”,尽管我确实怀疑 MPA 会优于 SPA(我在整篇文章中欣然承认了这一点)。你当然可以通过将应用做成复杂的仪表盘、视频游戏、生产力应用等来编写一个更偏向 SPA 的基准测试。你也可以选择不同的指标:Lighthouse 和 Core Web Vitals 对 SPA 相当苛刻,所以你可以改为衡量应用内交互性。
我也确信框架作者本身可以改进他们的框架或 AI 工具,并在这个基准测试中做得更好。例如,我强烈怀疑当前这批 MCPs 和 skills 可能弊大于利。所以如果这篇文章是这些框架性能的最终定论,我会非常失望。我也确信有一些新兴框架正迫不及待地想要在这样的基准测试中表现出色。
至少,我希望这篇文章能启发你在这个奇怪的 vibe coding 新时代对 JavaScript 框架的选择进行额外的审视。你真的基于证据来选择技术栈吗?还是只是沿用你已知的东西?这完全可以理解,尤其是如果你仍然自己在阅读、审查和调试代码。但如果你已经基本放手不管,那么你对当年像动物一样逐行敲代码时所做的选择还有什么执念呢?如果你正在重新评估构建软件的整个方式,也许值得重新评估你在 npm install 之后输入的内容?只是说说。
就个人而言,除了我相信我们应该努力为用户构建尽可能好的体验之外,我对上面评估的框架没有任何执念。我认识并尊重上述许多框架的作者,我知道他们正在为我所倡导的相同价值观而不懈努力。我只是希望推动整个社区朝着更好、更快、更易访问的框架方向发展,以驱动下一代 Web 应用。
附录
测试中使用的框架版本(注意 Qwik 在测试中途有一个补丁版本):
| 框架 | 版本 |
| --- | --- |
| Angular | @angular/core 22.2.3 |
| Astro | astro 7.4.2 |
| Gracile+Lit | @gracile/gracile 0.11.0, lit 3.3.3 |
| Hono+htmx | hono 4.13.14, htmx.org 2.0.11 |
| Next.js | next 16.4.3, react 19.3.1 |
| Nuxt | nuxt 4.6.2, vue 3.5.44 |
| Qwik | @builder.io/qwik-city 1.20.2 (第 1 次迭代), 1.20.3 (第 2、3、4、5 次迭代), @builder.io/qwik 1.20.2 (第 1 次迭代), 1.20.3 (第 2、3、4、5 次迭代) |
| React Router | react-router 8.5.0, react 19.3.1 |
| SolidStart | @solidjs/start 2.1.0, solid-js 1.9.17 |
| SvelteKit | @sveltejs/kit 3.1.0, svelte 5.57.2 |
| TanStack Start | @tanstack/react-start 1.169.4, react 19.3.1 |
| Vanilla | vite 8.3.5 |
你可以在 fediverse 上发表评论。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Nolan Lawson
原创地址:https://nolanlawson.com/2026/10/28/the-ai-cost-of-javascript-frameworks/
原文作者:Nolan Lawson;如有侵权,请联系管理员删除。

最新文章
- InfoComm China 视听链接会再次走进上海,直击CIO视角下的AV+AI“规模化落地”
- 北京InfoComm China迈向20周年:领航产业, 打造全年常态化专业视听商贸服务平台
- 智能体作为“数字员工”如何落地,这篇文章帮你破局
- CDIE2026 圆满收官 以AI生产力落地书写数字化转型新答卷
- 倒计时12天!CDIE2026数字化创新博览会上海启幕!共赴AI生产力变革盛会
- 倒计时32天!CDIE2026“将AI,转化为生产力”峰会启幕在即!
- 开源云原生数据库PolarDB PostgreSQL 15兼容版本正式发布
- 去哪儿秒级监控预警落地实践
- 从打点平台谈打点治理
- 这 10 种架构师,不合格!
