支持非内连接重排序的新一代基于代价的连接优化器

TL;DR:ClickHouse 新的基于代价的连接优化器(CBO)基于 DPsub 的高效实现构建,DPsub 是一种穷举式动态规划算法。对于最多 12 张表的查询,它能在现有代价模型下找到最廉价的计划,并将在即将发布的 26.10 版本中默认启用。在此之前,连接重排序仅适用于内连接,其他所有连接类型都会成为优化屏障。新优化器还能对 LEFT、RIGHT 和 FULL 外连接以及 SEMI 和 ANTI 连接进行重排序。冲突检测器保证了这一过程的安全性。它只接受能保持查询结果的重排序(正确性),并在搜索空间中找到所有有效计划(完备性)。这两个性质均已得到证明,并且在超过 90,000 棵连接树和 280 万个候选计划上的测试未发现无效或缺失的计划。
为什么数据库需要查询优化器 #
SQL 是声明式的:查询只说明想要什么结果,而不说明如何计算。查询优化器位于两者之间。它将查询转换为执行计划,即由扫描、过滤、连接和聚合等算子组成的树;对于任何非平凡的查询,都存在许多逻辑等价、计算结果完全相同的计划。过滤可以在连接之前或之后应用,连接可以从任一输入构建哈希表,连接可以按不同顺序、使用不同算法执行。
这些计划返回相同的行,但它们的代价可能相差几个数量级,因为它们在流水线中移动的数据量差异巨大。优化器的工作就是找到一个廉价的计划,为此它需要三样东西:
搜索空间:与查询等价的计划;
代价模型:对每个计划代价的估计,基于对每个算子产生行数的估计(来自表统计信息、索引或启发式规则);
搜索策略:一种无需尝试所有计划就能在该空间中找到廉价计划的方法。
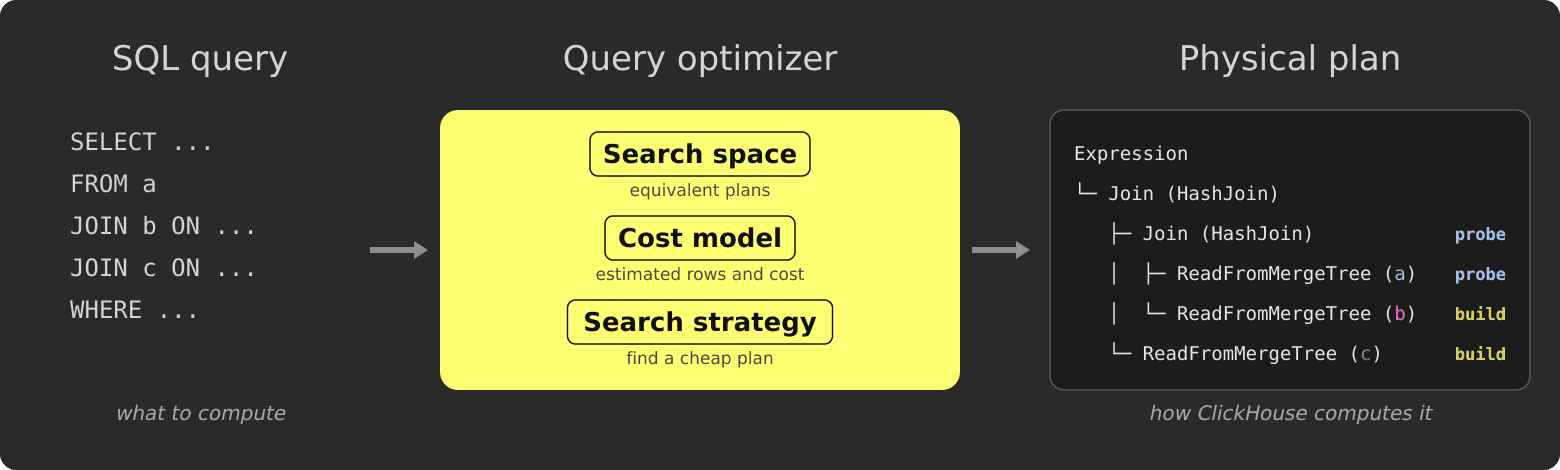
连接顺序:无需尝试所有计划即可搜索数十亿个计划。 #
没有哪个决策比连接顺序更重要。不同的顺序会产生规模差异巨大的中间结果。先连接两个最大的表可能会物化数十亿行,而先将一个大表与一个小而具有选择性的表连接,可能会在昂贵的连接发生之前将其缩减到几千行。更小的中间结果意味着更少的工作量和更少的内存,因此优化器的目标是最小化中间结果的大小。
也没有其他决策拥有更大的搜索空间。依次连接 n 张表已经允许 n! 种顺序。一旦连接可以组合两个中间结果(浓密计划),不同连接树的数量就是 n! · C(n−1),其中 C 是计算树形状的卡特兰数。这可以简化为 (2n−2)! / (n−1)!。对于 10 张表,这是 3,628,800 种左深顺序,但连接树超过 176 亿棵。对于 12 张表,已经约为 28 万亿棵。
有两种经典方法来搜索这个空间。
贪心优化。贪心优化器反复连接结果代价最低的两个输入。它速度快,通常也足够好,但它会过早做出决定且从不重新审视选择,因此一个局部看起来有吸引力的连接可能使其陷入整体较差的计划。ClickHouse 默认使用贪心优化器。
动态规划。基于自底向上 DP 的优化器能精确找到最便宜的连接顺序。它基于一个观察:连接一组表的最佳计划由两个更小的、不相交子集的最佳计划构建而成。它不枚举每个连接树(其数量呈阶乘增长,即使十几张表也会达到数十亿),而是对每个子问题只求解一次并复用答案。该过程按子集大小递增的顺序进行:
基本情况。对于每张单表,最佳计划是扫描该表并应用其过滤条件。
组合。对于每个更大的表子集,考虑将其拆分为两个非空、不相交部分的每种方式。每种拆分产生一个候选计划:将左部分的最佳计划与右部分的最佳计划连接,并根据估计的输出大小和两个子计划的代价估计其代价。
保留胜者。存储该子集最便宜的候选计划。两个部分都小于子集本身,因此它们的最佳计划已经存储。
完成。当到达包含所有表的子集时,其条目即为最优连接顺序。
该家族中的枚举器主要区别在于它们遍历搜索空间的方式。DPsub 是子集驱动的变体。它将每个表子集表示为位掩码,每张表一位,因此每个子集就是 1 到 2ⁿ−1 之间的一个整数。枚举所有子集意味着向上计数这些整数。对于每个子集,拆分的候选左侧是其自身的子子集,可以通过反复减一并与该子集进行掩码运算来生成,这种技巧可以遍历所有子子集而不跳过或重复任何子集。右侧是剩余部分,即与左侧进行一次 XOR 运算。
其吸引力在于枚举本身非常廉价。递增计数器、减一、对两个掩码进行 AND 运算、对两个掩码进行 XOR 运算以及计算置位位数是 CPU 最简单的操作之一。每个操作通常编译为一条指令,大约一个周期完成,而一个子集完全存在于寄存器中。无需跟随指针,无需分配集合,也无需哈希。每个子集的最佳计划可以存储在按位掩码索引的数组中,对于 12 张表只有 4,096 个条目,可以轻松放入 CPU 缓存。搜索空间仍然很大,因为拆分的数量大约以 3ⁿ 增长,对于 12 张表约为五十万,但生成每个拆分的开销只有几个周期。这就是为什么优化器可以穷举检查每个子集和每个拆分,而不是积极剪枝。
这种简单性是有代价的。DPsub 也会生成两侧没有任何连接谓词连接的拆分,因此实际实现会跳过这些以避免笛卡尔积。而且由于工作量呈指数增长,穷举 DP 仅对有限数量的表实用:ClickHouse 中的 DPsub 枚举最多 12 张表的子集。
提示:ClickHouse 的新 Join Reordering 算法基于 DPsub 的高效实现构建。对于最多 10 张表的查询(如果提高 query_plan_optimize_join_order_limit 则最多 12 张),它在现有代价模型下找到最便宜的计划。
让我们使用 TPC-H 数据集回顾一个示例,并比较同一 TPC-H 查询的两种连接顺序的中间结果大小。您可以看到,“选择性表优先”方法为该查询节省了约 100 倍的中间结果大小。
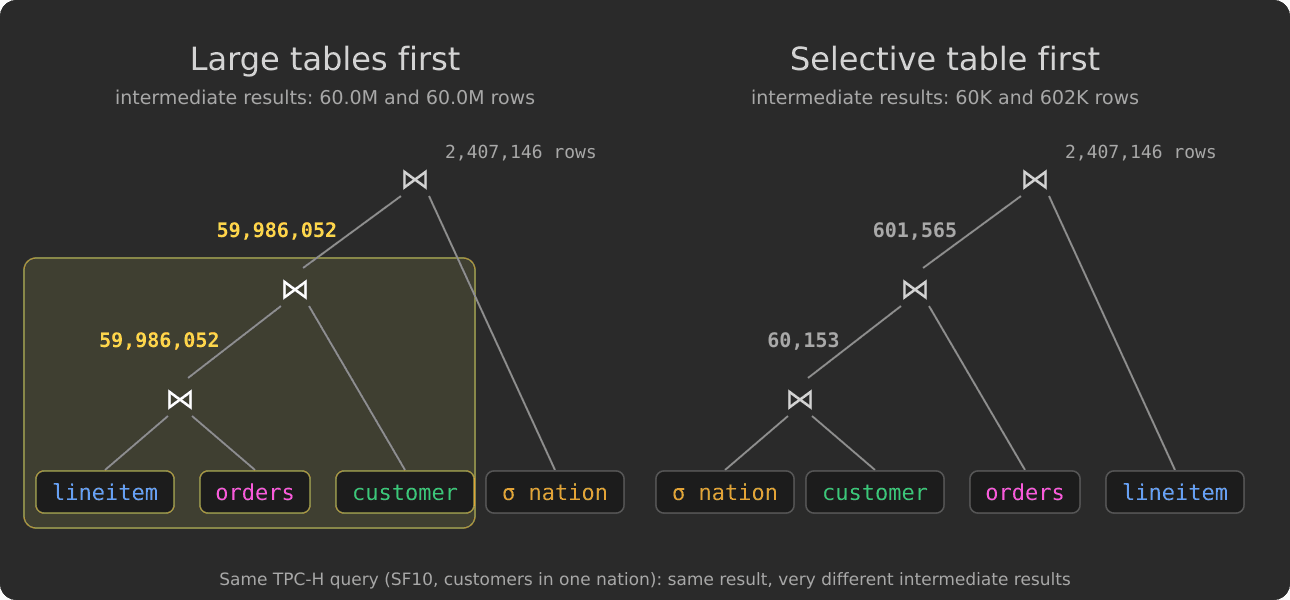
超越内连接:冲突检测器 #
然而,穷举搜索只能和它被允许搜索的空间一样好,而对于大多数真实查询,该空间缺少了一整类连接!
问题 #
连接顺序可以将查询的运行时间改变几个数量级。内连接使这易于利用:它们满足交换律( A ⋈ B 等于 B ⋈ A )和结合律( (A ⋈ B) ⋈ C 等于 A ⋈ (B ⋈ C) ),因此每种顺序都返回相同的结果,优化器只需找到最便宜的一种。
许多实际查询还会使用其他连接类型,其行为取决于哪些行在另一侧没有匹配:
| 连接类型 | 返回内容 |
| --- | --- |
| 左外连接 | 左表的每一行。如果右侧没有匹配,右侧列填充为 NULL(如果 join_use_nulls = 1 ) |
| 全外连接 | 两个表的每一行。没有匹配的行在缺失的一侧填充为 NULL。 |
| 半连接 | 每个匹配的左行返回一次,附带其第一个匹配的右侧列,不包含右侧列且无重复。这等价于 WHERE EXISTS (...) 或 IN (...) 的语义。 |
| 反连接 | 仅返回右侧没有匹配的左行。这等价于 WHERE NOT EXISTS (...) 的语义。 |
左外连接、半连接和反连接不满足交换律:A LEFT JOIN B 保留 A 的所有行,而 B LEFT JOIN A 保留 B 的所有行。它们通常也不满足结合律。以 (A LEFT JOIN B) JOIN C ON B.x = C.x 为例。A 中在 B 里没有匹配的行,其 B.x 为 NULL,因此与 C 的内连接会丢弃这些行。如果优化器改为先计算 B JOIN C,再将 A 左连接到结果上,那么 A 的这些行会保留下来。两种计划返回不同的结果,因此第二种不是有效的重排序。
要对这类连接进行重排序,优化器需要对其考虑的每个候选连接回答一个问题:这个重排序是否有效?回答这个问题的组件称为冲突检测器(conflict detector)。它从两个方向改变搜索空间。与将所有连接视为可自由重排序相比,它使搜索空间变小:它排除的每个无效重排序都是不再需要探索的空间的一部分。与将所有非内连接视为屏障(ClickHouse 此前一直如此)相比,它使搜索空间变大:屏障所隐藏的所有有效重排序都变得可用。优化器探索的计划比之前更多,而且每一个都返回正确的结果。
我们正在填补的空白 #
到目前为止,ClickHouse 在一个单独的阶段中优化半连接和反连接,位于内连接图之外:
优化器将连接树展平为一个可重排序的表图,但只接纳普通连接:半连接或反连接子节点从不会被展平进来。
顶层的半连接或反连接将图限制为两个表:没有重新结合,只能交换其两个输入。
因此每个半连接或反连接都是一个优化屏障。查询被分割成内连接的孤岛,各自独立优化,半连接和反连接被固定在查询写入它们的位置。
后果是:一个选择性的半连接或反连接无法被下推到为其提供输入的内连接之前,因此计划会先构建完整的中间结果。
1
SELECT
sum
(big.v
+
mid.v)
2
FROM
big
3
INNER
JOIN
mid
ON
big.k
=
mid.k
4
LEFT
SEMI
JOIN
tiny
ON
big.k
=
tiny.k
big 和 mid 共享连接键,因此 big JOIN mid 的结果非常大;tiny 只包含少量键,因此半连接会丢弃其中几乎全部内容。当半连接被固定在顶层时,计划会先构建 big JOIN mid。让半连接参与连接顺序搜索,优化器就可以先过滤 big:
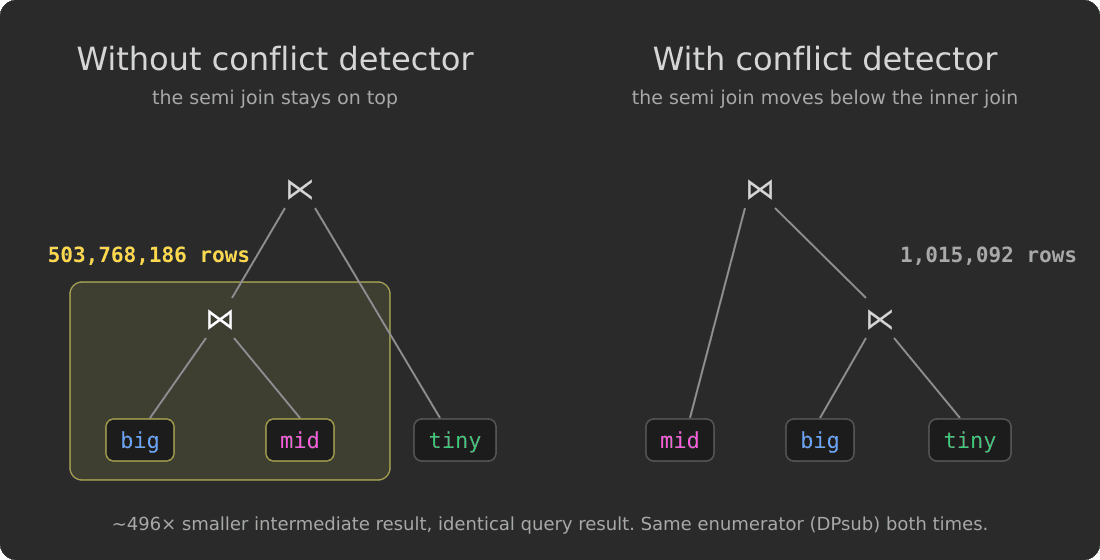
|  | 计划 | 最大中间结果 |
| --- | --- | --- |
| 无冲突检测器 | (big ⋈ mid) ⋉ tiny | 503,768,186 行 |
| 有冲突检测器 | mid ⋈ (big ⋉ tiny) | 1,015,092 行 |
中间结果缩小了约 496 倍,两次使用的是同一个连接枚举器:唯一的区别是半连接参与了搜索。结果完全相同。
基于研究构建 #
我们的冲突检测器基于《On the Correct and Complete Enumeration of the Core Search Space》(SIGMOD 2013)。该论文表明,早期方法可能遗漏有效计划或接受无效计划,并提出了一种可证明既正确又完备的冲突检测器。
该论文定义了核心搜索空间:从原始连接树出发,通过对其算子有效的代数变换可到达的每个计划。其冲突检测器恰好生成该空间,不多也不少。这就是我们实现的检测器,覆盖 inner、left/right/full outer 以及 left/right semi 和 anti join。
检测器如何工作 #
四条规则 #
两个相邻连接能否在不改变结果的情况下交换或重新分组,取决于它们的类型,并且在某些情况下取决于它们的谓词是否拒绝 NULL。检测器检查四个属性来确定哪些变换是安全的。在下面的表达式中,∘ᵃ 和 ∘ᵇ 表示连接算子,e₁、e₂ 和 e₃ 表示它们的输入。comm 属性描述单个算子类型;其他三个属性存储在按算子类型对索引的矩阵中:
comm:该算子是否可交换?(a ⋈ b = b ⋈ a)
assoc:(e₁ ∘ᵃ e₂) ∘ᵇ e₃ = e₁ ∘ᵃ (e₂ ∘ᵇ e₃) ?
l-asscom:(e₁ ∘ᵃ e₂) ∘ᵇ e₃ = (e₁ ∘ᵇ e₃) ∘ᵃ e₂ ?
r-asscom:e₁ ∘ᵃ (e₂ ∘ᵇ e₃) = e₂ ∘ᵇ (e₁ ∘ᵃ e₃) ?
考虑这个对 customers、orders 和 payments 的查询:
1
SELECT
customers.id, orders.id, payments.order_id
2
FROM
customers
3
LEFT
JOIN
orders
ON
customers.id
=
orders.customer_id
4
INNER
JOIN
payments
ON
orders.id
=
payments.order_id
5
SETTINGS join_use_nulls
=
1
当 join_use_nulls = 1 时,未匹配的行用 NULL 填充。下面的 Plan A 遵循查询中写出的连接顺序;Plan B 是一个提议的重排序,检测器必须拒绝它。这些简化的逻辑计划展示了连接和扫描,省略了最终的投影。它们并不等价。
1
Inner join [orders.id = payments.order_id]
2
├── Left outer join [customers.id = orders.customer_id]
3
│   ├── Scan customers
4
│   └── Scan orders
5
└── Scan payments
Plan B — Plan A 的无效重排序
1
Left outer join [customers.id = orders.customer_id]
2
├── Scan customers
3
└── Inner join [orders.id = payments.order_id]
4
├── Scan orders
5
└── Scan payments
对于一个没有订单的客户,Plan A 创建一行带有 NULL 订单字段的记录,然后在 inner join 处丢弃它,因为它无法匹配 payment。Plan B 先将 orders 与 payments 连接,然后在 left join 处保留该客户。检测器必须拒绝 Plan B 作为 Plan A 的替代方案,因为它改变了结果:assoc(⟕, ⋈) 为 false。
现在考虑另一个查询,连接类型的顺序相反:
1
SELECT
customers.id, orders.id, payments.order_id
2
FROM
customers
3
INNER
JOIN
orders
ON
customers.id
=
orders.customer_id
4
LEFT
JOIN
payments
ON
orders.id
=
payments.order_id
5
SETTINGS join_use_nulls
=
1
对于这个查询,Plan C 遵循写出的顺序,Plan D 是一个有效的重排序:
1
Left outer join [orders.id = payments.order_id]
2
├── Inner join [customers.id = orders.customer_id]
3
│   ├── Scan customers
4
│   └── Scan orders
5
└── Scan payments
Plan D — Plan C 的有效重排序
1
Inner join [customers.id = orders.customer_id]
2
├── Scan customers
3
└── Left outer join [orders.id = payments.order_id]
4
├── Scan orders
5
└── Scan payments
Plan C 和 Plan D 只保留有订单的客户,并且保留每个匹配的订单,即使该订单没有支付:assoc(⋈, ⟕) 为 true。因此,检测器可以接受 Plan D 作为 Plan C 的替代方案。
如果两个连接都是左连接,在相同的等值条件下重新分组也是安全的。缺失的订单无法匹配支付,因为 orders.id = payments.order_id 会拒绝 NULL。如果某个条件可能匹配到用 NULL 填充的订单,就会破坏这一保证:assoc(⟕, ⟕) 仅在拒绝 NULL 的条件下成立。这就是为什么这些规则既取决于连接类型,也取决于它们的条件如何处理 NULL。
我们的实现将这些规则存储为静态数据,comm 一行,三个矩阵,让检测器检查每个提议的变换,而不是假设每次重新分组都是安全的。
从矩阵到有效性测试 #
在枚举开始之前,检测器会遍历查询的原始连接树。对于每个算子,它记录左右输入子树、其 ON 子句引用的表,以及该子句拒绝 NULL 的表。然后,对于矩阵禁止变换的每一对算子,它记录一个冲突。
每个算子在其每一侧只要求其 ON 子句在该侧引用的表,并且每个冲突都单独记录为一条规则“如果 T₁ 的任一表已被连接,则 T₂ 的所有表也必须被连接”。例如,在 Plan A 中,内连接得到规则“如果 orders 被连接,customers 也必须被连接”,这拒绝了 Plan B 的 orders ⋈ payments。将冲突保留为单独的、有条件的规则,而不是将它们全部折叠到必需集合中,这正是使检测器完备的原因:只有当冲突实际适用于某个计划时,它才会拒绝该计划。每当枚举器考虑将表集合 S₁ 与集合 S₂ 连接时,都会应用有效性测试:
1
required_left ⊆ S₁  ∧  required_right ⊆ S₂   (or mirrored, with LEFT ↔ RIGHT)
2
∧  every conflict rule of the operator is obeyed by S₁ ∪ S₂
如果测试通过,在该拆分处应用的算子决定结果连接的类型和严格性。该测试只是几个位掩码操作,因此几乎不会给枚举增加任何开销。
将其融入 DPsub #
DPsub 将表的子集枚举为位掩码,并且对于每个子集,找到从两个更小的连通子集构建它的最便宜方式。有了检测器后,整个连接树作为一个表图进入 DPsub:每个外连接、半连接和反连接的两侧,以及 FULL 连接。还需要几个额外的部分:
交叉积。CROSS JOIN 不基于任何条件连接,因此它不会向图中添加边。我们显式地链接它的两侧,作为选择性为 1 的连接,这样图保持连通,DPsub 可以将交叉积移动到最便宜的位置,同时它仍然作为 CROSS JOIN 执行和报告。
构建侧。DPsub 的成本模型对连接的收费无论其输入方向如何都相同,因此在搜索之后,我们将较小的输入放在哈希连接的构建侧,镜像外连接的 LEFT ↔ RIGHT,但绝不用于 ANY、SEMI 和 ANTI 连接,因为它们的含义取决于方向。
有界搜索。带有检测器的 DPsub 可以规划最多 12 个表的连接树,包括半连接、反连接和外连接。更大的连接树留给贪婪优化器。
验证 I:对照理论 #
一个检测器只要出错一次就会返回错误结果,因此我们按照论文中的方式对其进行了验证。对于给定的表数量 n,一个测试框架:
生成所有初始连接树:所有树形 × 所有算子分配 × 所有二元等值谓词;
枚举每棵树的整个核心搜索空间;
并通过三种独立方式检查每个候选计划:已发布的检测器、定义核心搜索空间的独立参考实现,以及在包含 NULL 的随机数据库上执行。
它统计在核心搜索空间之外生成的计划(invalid,必须为 0)、未能生成的核心计划(missing),以及任何执行失败的计划(必须为 0)。
小算子集 #
内连接、左外连接和反连接:
| tables | join trees | core plans | invalid | missing |
| --- | --- | --- | --- | --- |
| 3 | 30 | 94 | 0 | 0 |
| 4 | 495 | 4,696 | 0 | 0 |
| 5 | 11,010 | 377,434 | 0 | 0 |
| 6 | 2,000 | 145,657 | 0 | 0 |
| 7 | 2,000 | 618,710 | 0 | 0 |
大算子集 #
内连接、左/全外连接、半连接和反连接:
| tables | join trees | core plans | invalid | missing |
| --- | --- | --- | --- | --- |
| 3 | 80 | 243 | 0 | 0 |
| 4 | 2,080 | 16,207 | 0 | 0 |
| 5 | 72,320 | 1,615,294 | 0 | 0 |
| 6 | 2,000 | 77,194 | 0 | 0 |
| 7 | 2,000 | 228,662 | 0 | 0 |
(对于 6 张表和 7 张表的行,连接树为采样。)在所有实验中,检测器生成了全部 280 万个核心计划,且没有生成任何一个无效计划,也没有任何计划执行失败。
验证 II:在真实引擎上 #
差分模糊测试 #
模糊测试器生成随机的多路连接查询,混合 INNER、LEFT、RIGHT、FULL、SEMI 和 ANTI 连接,包括仅引用一侧的 ON 子句,并在包含 NULL、重复键和不匹配键的真实数据上运行。每个查询以三种方式执行,并与在 ClickHouse 内部计算出的顺序无关、NULL 安全的校验和进行比较:
base:写入顺序,不重排,作为基准真值;
greedy:现有的默认优化器;
DPsub:带冲突检测器的 DPsub。
1,200 个查询,最多涉及 7 张表:0 个不匹配。
搜索空间 #
在真实优化器上,检测器额外打开了多少搜索空间?统计 DPsub 探索的有效计划数量,针对 1,200 个采样查询,涉及 3 到 7 张表:
| 表数 | 查询数 | 无检测器 | 冲突检测器 | 增益 |
| --- | --- | --- | --- | --- |
| 3 | 389 | 757 | 757 | 1.00× |
| 4 | 403 | 1,283 | 1,583 | 1.23× |
| 5 | 396 | 1,633 | 2,883 | 1.77× |
| 6 | 407 | 3,228 | 8,868 | 2.75× |
| 7 | 405 | 2,678 | 30,816 | 11.51× |
在 7 张表时,冲突检测器让 DPsub 能够考虑的有效计划数量比没有检测器时多 11.5 倍:查询中的连接越多,之前被屏障隐藏的优质计划就越多。
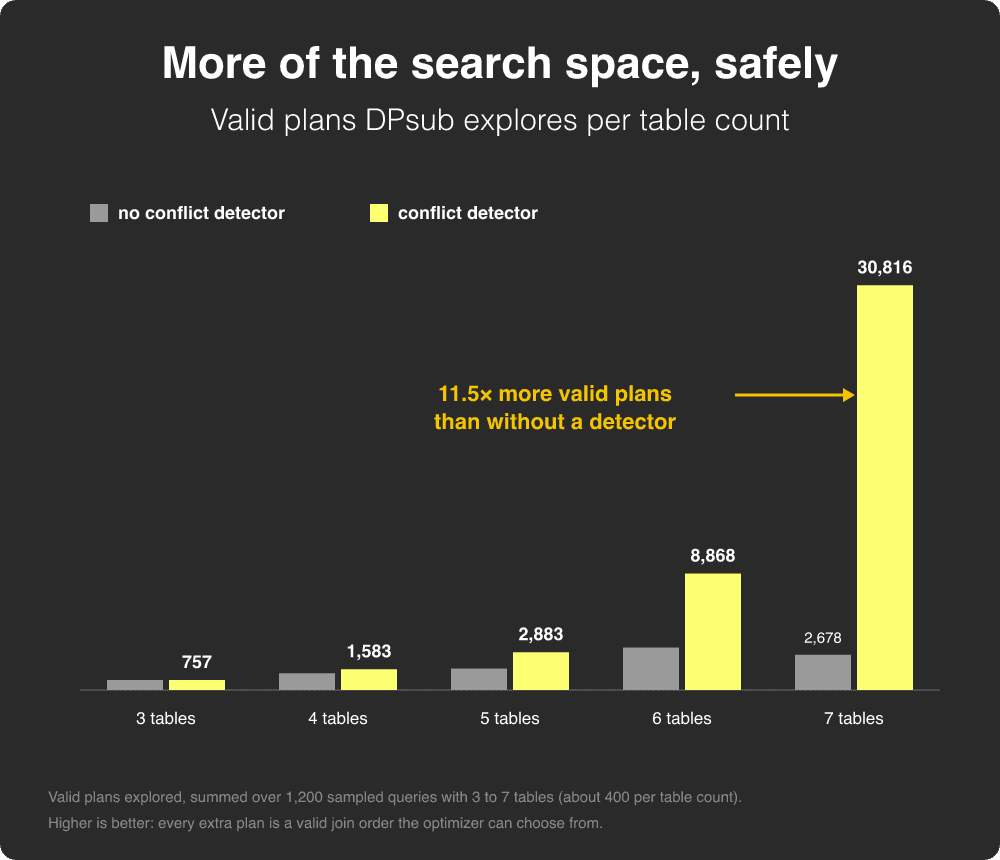
测试 #
CI 中的无状态测试检查(其中包括)每一对连接类型都以一个图的形式到达 DPsub 且结果不变,ANY / SEMI / ANTI 的严格性得以保留,以及 join_use_nulls、退化谓词和交叉积。
结果 #
回到我们的半连接查询:
1
SELECT
sum
(big.v
+
mid.v)
2
FROM
big
3
INNER
JOIN
mid
ON
big.k
=
mid.k
4
LEFT
SEMI
JOIN
tiny
ON
big.k
=
tiny.k
但现在针对之前的默认优化器,即 greedy 优化器进行评估。在一个 big 和 mid 各有 300 万行、tiny 有 100 个键的数据集上,greedy 将半连接保留在 big JOIN mid 之上:
1
Join (left semi)
2
├── Join (inner)
3
│   ├── ReadFromMergeTree (big)
4
│   └── ReadFromMergeTree (mid)
5
└── ReadFromMergeTree (tiny)
带有冲突检测器的 DPsub 将其移动到内连接下方:
1
Join (inner)
2
├── ReadFromMergeTree (mid)
3
└── Join (left semi)
4
├── ReadFromMergeTree (big)
5
└── ReadFromMergeTree (tiny)
|  | greedy | DPsub + 冲突检测器 | 加速比 |
| --- | --- | --- | --- |
| 运行时连接过滤器关闭 | 0.133 s | 0.035 s | 3.8× |
| 运行时连接过滤器开启(默认) | 0.044 s | 0.037 s | 1.2× |
ClickHouse 的运行时连接过滤器会将哈希表的键下推到另一侧的扫描操作,这已经在该查询上部分纠正了糟糕的连接顺序;而更优的执行计划并不依赖于它们。
在我们性能测试的 TPC-DS (SF1) 和 TPC-H (SF1/SF10) 查询上,与默认的 greedy 算法相比:
| 查询 | greedy | DPsub + 冲突检测器 | 变化 |
| --- | --- | --- | --- |
| TPC-H Q2 | 143 ms | 65 ms | −55% |
| TPC-DS Q73 | 260 ms | 143 ms | −45% |
| TPC-H Q5 | 574 ms | 320 ms | −44% |
| TPC-DS Q86 | 93 ms | 57 ms | −39% |
| TPC-DS Q65 | 302 ms | 227 ms | −25% |
使用方法 #
我们新的带有冲突检测器的 DPsub 从 26.10 版本开始成为连接操作的默认基于代价的优化器(CBO):
1
SET
query_plan_optimize_join_order_algorithm
=
'dpsub,greedy'
;
2
SET
query_plan_optimize_join_order_conflict_detector
=
'c'
;
如果你想与之前的行为进行比较,可以按查询将其关闭。要获取更多细节并查看每次连接运行的连接顺序、类型和严格程度,请使用 EXPLAIN actions = 1 :
1
EXPLAIN actions
=
1
2
SELECT
...
3
SETTINGS query_plan_optimize_join_order_algorithm
=
'greedy'
,
4
query_plan_optimize_join_order_conflict_detector
=
''[object Object]

转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:ClickHouse Blog
原文作者:Fisnik Kastrati;如有侵权,请联系管理员删除。

最新文章
- InfoComm China 视听链接会再次走进上海,直击CIO视角下的AV+AI“规模化落地”
- 北京InfoComm China迈向20周年:领航产业, 打造全年常态化专业视听商贸服务平台
- 智能体作为“数字员工”如何落地,这篇文章帮你破局
- CDIE2026 圆满收官 以AI生产力落地书写数字化转型新答卷
- 倒计时12天!CDIE2026数字化创新博览会上海启幕!共赴AI生产力变革盛会
- 倒计时32天!CDIE2026“将AI,转化为生产力”峰会启幕在即!
- 开源云原生数据库PolarDB PostgreSQL 15兼容版本正式发布
- 去哪儿秒级监控预警落地实践
- 从打点平台谈打点治理
- 这 10 种架构师,不合格!
