五百万比一:两块相隔 20 年的 Arduino 开发板
作者:Marcello Majonchi,Arduino 首席产品官
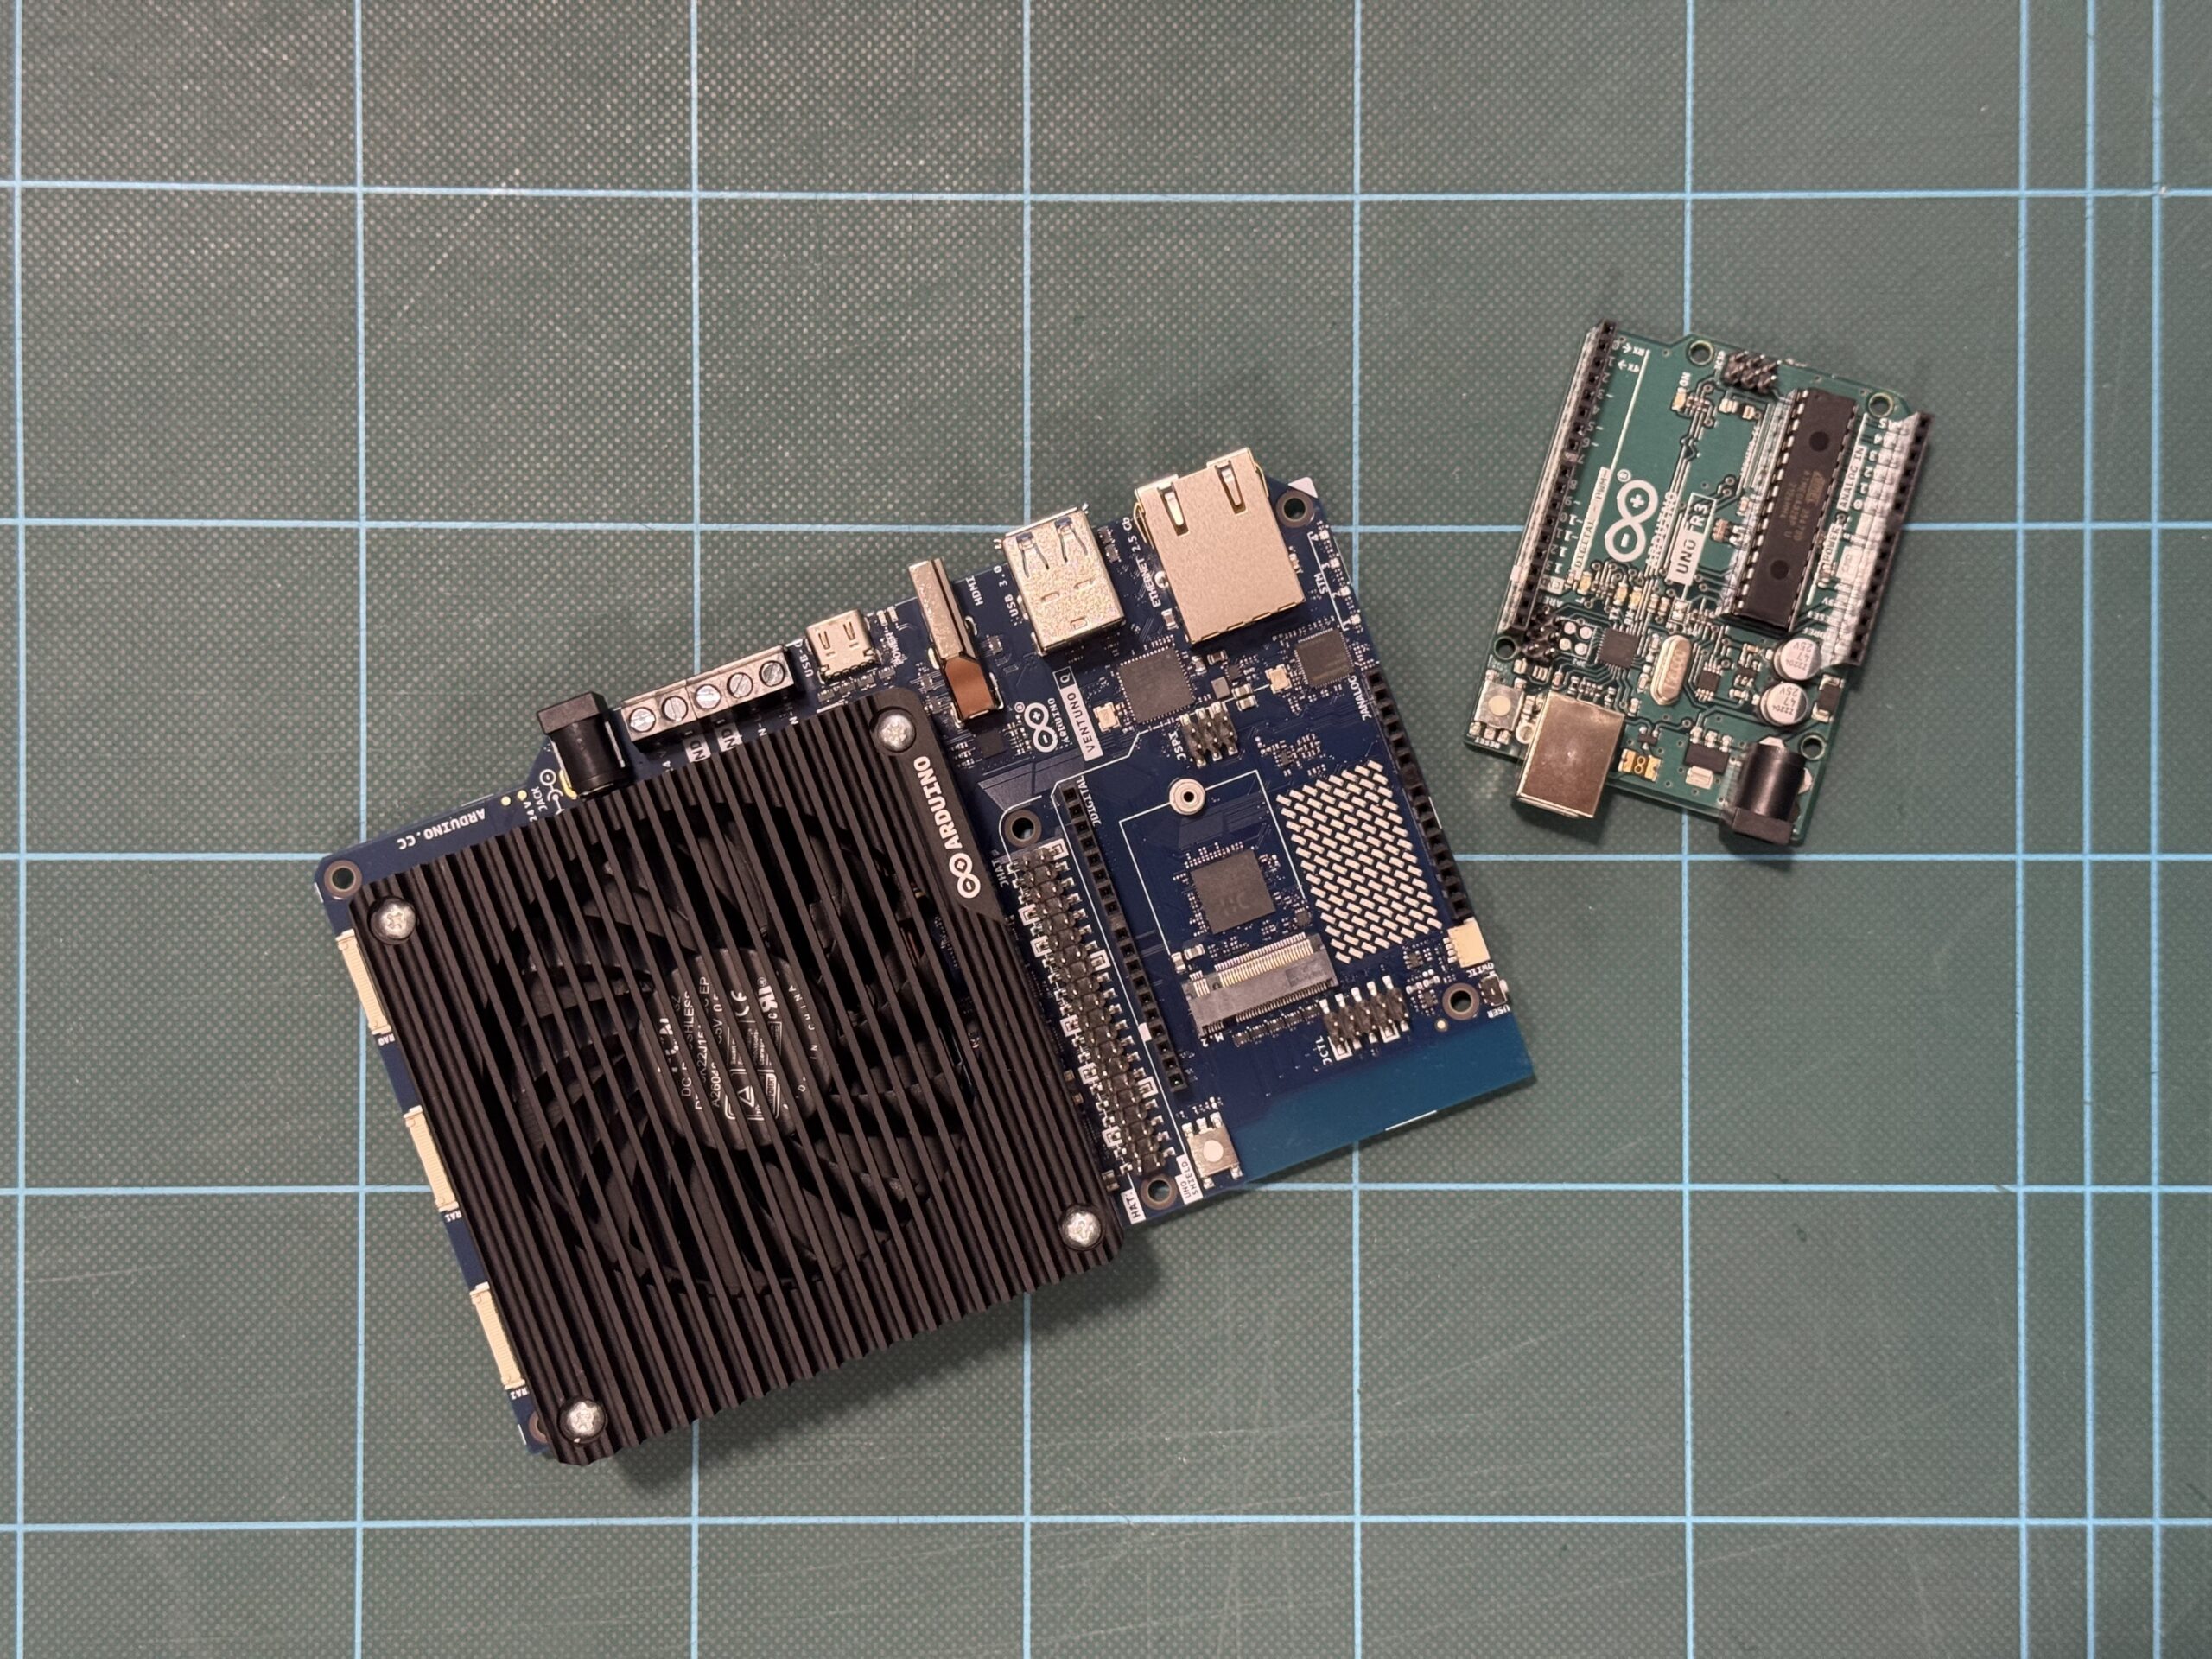
我的桌上放着两块开发板。它们有着相同的标志,名字也颇为相似。它们的技术截然不同,但背后的理念却完全一致。
左边是一块早期的 Arduino ® UNO ™ Rev3 ,搭载 Microchip ATmega328P——一颗可追溯到 2000 年代、指甲盖大小的芯片,正是它推动了最初的 Arduino 革命。右边则是 Arduino ® VENTUNO ™ Q ,搭载 Qualcomm Dragonwing IQ-8 芯片组,配备八核 CPU 和一颗最高可达 40 dense TOPS 的 NPU,是迄今为止 AI 能力最强的 Arduino 开发板。
两者都是 Arduino。两者共享相同的排针。只需几步,你就可以在其中一块上点亮 LED,或者在另一块上部署一个 80 亿参数的大语言模型(LLM(大语言模型)),然后问它如何为最初那块开发板编程来点亮 LED。
过去 20 年技术演进之快令人惊叹,但自然而然,最明显的问题是:究竟快了多少?
嗯,你从标题已经知道答案了,但得出真实数字的过程揭示了性能规格呈现方式中的一个常见陷阱,并提供了一种更好的方法来评估任何性能声明。
规格参数的问题
VENTUNO Q 上的 Dragonwing 芯片组(IQ-8275)标称规格为 40 dense TOPS ,即每秒四十万亿次稠密运算 。
另一方面,2009 年的 ATmega328P 是嵌入式电子领域的主力:单个 8 位 AVR RISC 核心,时钟频率 20MHz,以其在嵌入式应用中的长期使用、简洁的架构和广泛的易用性而闻名。
ATmega 的数据手册上没有性能指标,因为当时没有人追踪这类东西。但是,如果你手动估算它的计算上限,大约会得到每秒 800 万次操作。
用 40 万亿除以 800 万,得到 500 万。结案了?
不完全是。这个简单的除法掩盖了性能数字解读中一个常见的陷阱:操作并不等同。
计算机以不同格式进行数学运算:可以把它们想象成不同的货币。小整数格式(通常用于基本像素亮度)需要的计算资源相对较少。高精度浮点小数(通常用于物理或导航)通常需要更多计算资源。因此,一个针对基本整数高速运算优化的芯片,在被迫处理复杂小数时可能显得平平无奇。
AI 硬件的营销材料通常引用小整数格式,INT8 或 INT16。将这些数字与基于通用时钟周期估算的 ATmega328P 进行比较,类似于比较不同货币而不应用汇率。得出的数字可能看起来很惊人,但并不能提供有意义的同类比较。
因此,有意义的性能比较的第一条规则是:双方必须使用相同的“货币”来衡量。
设计一场公平的竞赛
要进行有意义的比较,两个芯片应对相同数据执行相同操作,并产生等效结果。
该操作的一个代表性工作负载是现代机器学习的数学基础:将两个数相乘,将结果加到累计总和中。这称为乘加运算,或通俗地称为 MAC。
将这个循环重复数百万(或数万亿)次,你就可以实现诸如图像分类(即判断一张照片包含狗、汽车还是生日蛋糕)、语音识别(即在过滤背景噪声的同时持续寻找特定唤醒词),甚至更奇特的东西,如自主导航(即实时评估传感器数据以区分墙壁和人)。
这些任务都是相同的底层数学,即 MAC 操作的聚合,只是规模不同,使它们成为有用的标尺。
实际基准测试
我们选择图像分类,以保持简单。
我们需要测试图像输入到两个系统中,这些图像源自标准数字照片,经过裁剪和调整大小,统一为224 × 224像素、三个RGB颜色通道的分辨率。此预处理将每张照片转换为包含150,528个独立像素值(224乘224乘3)的输入数据数组(又称张量)。图像数据格式为8位量化整数(INT8),将每个颜色值映射到0到255之间的整数,以匹配现代硬件所需的低精度整数格式。
评估一张照片需要将此张量流经一个包含约100兆字节存储参数的视觉模型,产生80亿次总操作(40亿次MAC步骤)的工作负载。VENTUNO Q设计为每秒处理约5,000张照片;按此速率,系统可在一次心跳间整理整个照片档案(或仅千禧一代的一顿丰盛餐食照片)。在相同基准假设下,原UNO Rev3分析同一张照片约需17分钟,所以拍那张提拉米苏照片前请三思。
要处理VENTUNO Q设计在一秒内处理的5,000张照片,按基准吞吐率,UNO Rev3大约需要58天。如果从1月1日开始,要到2月下旬才能完成。
在此基准测试背景下,性能差异仍保持在五百万比一的量级。
为什么这实际上毫无意义
问题在于:UNO Rev3实际上无法执行此基准工作负载,因为模型超出了设备可用的内存资源。
AI视觉模型需要大约100兆字节内存来存储其参数。ATmega328P有32千字节闪存和2千字节RAM,不足以存储该模型。
“58天”指标只是假设连接了无限外部内存。这仅是思想实验,但还有更相关的事情。
2008年与今天的差距不仅在于旧芯片慢。而是一整类工作从早期硬件上不可行,转变为在现代AI平台上常规可实现。再多的耐心也无法将8千字节内存扩展为100兆字节。
真正的技术飞跃很少感觉像“同样的事情,更快”。它们表现为全新类别的能力首次开放。
真正重要的是什么
虽然这一思想实验表明算术能力存在五百万倍的差异,但 VENTUNO Q 的意义远不止于原始计算性能。
该平台的关键贡献之一是降低实验和开发的门槛,从而让边缘智能更易获取。其目标是让开发者更容易从探索 AI 软件过渡到构建物理 AI 系统。
无论是在 8 位 ATmega 上切换 GPIO 引脚,还是在现代 NPU 上部署计算机视觉模型,这两款开发板都遵循相似的开发理念:连接硬件、打开易用的开发环境,然后开始构建。
对开发者易用性的重视才是最重要的。尽管计算能力存在显著差异,这两款开发板都旨在为硬件开发和实验提供一条平易近人的路径。
在保持易用性的同时大幅扩展计算能力,是一项重大的工程成就。对我来说,这才是真正的故事。让 AI 技术更易获取,能帮助更多人从使用 AI 工具转向构建自己的 AI 应用。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Arduino Blog
原创地址:https://blog.arduino.cc/2026/10/20/five-million-to-one-two-arduino-boards-20-years-apart/
原文作者:Arduino Team;如有侵权,请联系管理员删除。

