AMD RDNA™ 3 和 RDNA™ 4 架构上的 FP16 GEMM 优化
AMD RDNA™ 3 与 RDNA™ 4 架构上的 FP16 GEMM 优化 #
在本博客中,你将学习如何为 AMD RDNA™ 3 和 RDNA™ 4 GPU(图形处理器) 编写一个快速的 FP16 GEMM 内核,并逐步进行优化。你将了解哪些技术在各架构上有效,为什么某些技术对一种架构有帮助却对另一种架构有害,以及如何衡量每次改动在时间、寄存器和 LDS 上的影响,从而将同样的方法应用到自己的内核中。这是两部分系列文章的第 1 部分。第 2 部分将把本文的最终内核移植到 RDNA 4 上的 FP8。
计算 C = A × B 是 AI 和 HPC 中使用最频繁的内核之一。在基于 RDNA 架构的 AMD Radeon™ GPU 上,硬件为此提供了 Wave Matrix Multiply-Accumulate(WMMA)指令:这是一条协作指令,一个 wave 中的全部 32 个线程共同完成 16×16×16 矩阵块的乘法,并将结果累加到累加器中。本文从 WMMA 出发,一步一步构建一个 FP16 GEMM 内核。我们从一个基础的 GEMM 内核开始,最终性能与 hipBLASLt(ROCm 的调优 GEMM 库)相比,根据架构和 GEMM 形状的不同,快或慢几个百分点。目标不是打造一个生产级库,而是一次引导式演练:每一步都说明它要解决的问题,展示代码改动,并报告该改动在时间、寄存器和 Local Data Share(LDS,工作组内线程共享的快速片上内存)上的开销或节省。
该内核通过八个步骤逐步演进,编号与后文计时表中的编号一致。第 1 步是一个最小的起步内核,在一个小 tile 上运行一个 wave,让你看到朴素的 WMMA 循环距离目标有多远。第 2 步一次性应用四项标准 GEMM 技术:更大的 tile、宽 128 位内存拷贝、双缓冲和分阶段提交。这是唯一一步同时改动多项内容;这四项改动合在一起,达到一个常规的分块内核,后续每一步都在此基础上构建。第 3 步到第 8 步每次只改动一项:
避免 LDS bank 冲突:tile 的连续行可能映射到同一个 LDS bank 并导致串行化;通过填充或置换布局将访问分散开。
使用 buffer resource descriptor 进行全局加载:越界地址返回零,因此 tile 尺寸无需整除矩阵维度。
加深 K 切片:在 LDS 中同时保存多个 WMMA 步骤的 K,在全局内存拷贝和屏障之间做更多算术。
重排块顺序以复用缓存:以某种顺序启动输出 tile,使并发块读取 A 和 B 的重叠区域。
将预取与 WMMA 交错:在矩阵指令之间发出全局加载,使内存延迟隐藏在 wave 本就要执行的算术之后。
重新审视双缓冲:在交错就位后,测试两个 LDS 缓冲区是否仍值得其占用率代价,或者一个缓冲区和更多常驻工作组是否更快。
注意:AMD CDNA™ 4 架构上的 FP8 GEMM 优化在 CDNA 硬件上以 FP8 覆盖了相同的优化进程。
每一步都在三款 GPU 上测量:AMD Radeon™ PRO W7800(gfx1100,RDNA 3)、AMD Radeon™ RX 9070 XT(gfx1201,RDNA 4)和 AMD Radeon™ 8060S(gfx1151,RDNA 3.5)。后者使用与 RDNA 3 相同的 WMMA 指令,因此一个内核二进制文件可同时服务两者,但它通过系统 RAM 而非专用 GDDR 访问内存,导致即使在优化后 gfx1151 上的绝对吞吐量也较低。若干步骤对一种架构有帮助却对另一种有害;这些情况会在出现时指出。
要完成这些示例,你需要安装 ROCm 及 hipBLASLt 开发包、一块 RDNA 3、RDNA 3.5 或 RDNA 4 GPU,并熟悉 HIP 以及 GEMM 分块的基础知识(大型矩阵乘法如何拆分为块、wave 和 K 切片)。本文中的所有计时数据来自 ROCm 10。
下面大多数代码片段是伪代码,展示结构和控制流。完整 HIP 代码出现在细节重要的地方:WMMA 内建函数、buffer resource descriptor 以及 LDS 置换背后的地址运算。每一步的完整实现及基准测试驱动程序位于配套仓库中。本系列第 2 部分将把相同的进程应用到 RDNA 4 上的 FP8。
我们在计算什么 #
本文中的每个内核都以 FP16 计算 C = A × B。矩阵 A 按行主序存储,矩阵 B 按列主序存储。这种配对是有意为之:K 是乘法求和的维度,采用这些布局后,两个操作数都沿 K 连续。当工作组将 A 或 B 的 tile 拷贝到 LDS 时,每个 lane 都可以用连续地址遍历 K,且无需在传入时转置。本文中每个 LDS tile 都将 K 放在索引的最后,A 和 B 的拷贝循环互为镜像。基准测试直接以这些布局填充 A 和 B;真实数据可能需要先转置以匹配内核的预期。内核以 hipBLASLt 使用的相同列主序布局写入 C,前导维度为 M,因此两个输出逐元素对齐。
hipBLASLt 将这种配对标记为 TN,这个名称在本文后续内容中会反复出现。
除了计时之外,该基准测试还会将每个阶段与 hipBLASLt 进行对比。它将 A 和 B 的每个元素取为 -1 或 +1,并对两者进行精确比较,不设容差:此时每个乘积均为 ±1,每个部分和均为整数。在随机输入下,这些和值保持在 ±√K 附近,完全落在 FP16 可精确表示的范围内,因此无论双方以何种顺序进行归约,都不会发生舍入,正确的内核必须与 hipBLASLt 逐位一致。该测试在两种基准形状下都会运行,因此宽矩阵情形下不可整除的分块也被覆盖。
RDNA 上的波矩阵乘累加 #
第 1 节将 WMMA 介绍为本内核的构建模块。在优化步骤开始之前,本节将介绍该指令对寄存器内容的期望,以及 RDNA 3 与 RDNA 4 在这方面的差异。这些差异会在后续的寄存器压力、LDS 布局选择以及哪种架构能从特定步骤中获益等方面体现出来。
WMMA 是一条波级指令:一个波中的全部 32 个 lane 协同完成一次 16×16×16 的矩阵乘累加。一条指令将 A 的 16×16 分块与 B 的 16×16 分块相乘,并将结果累加到 C 的 16×16 分块中。
两种架构将每个操作数分布到波内寄存器的方式不同。在 RDNA 3 上,WMMA 将 32 lane 的波视为两个协同工作的 16 lane 半波,它们共享操作数数据,但写入 16×16 输出分块的不同部分。因此操作数片段是复制的:lane 0–15 和 lane 16–31 持有相同的数据,每个 lane 都携带其所在行的全部 16 个 K 值。内核必须将这些完整的 K 行加载到每个 lane 中,即使只使用了一半的累加器元素。在 RDNA 4 上,波的两个半波持有不同的数据:lane 0–15 携带 K 值 0–7,lane 16–31 携带 8–15。如图 1 所示,RDNA 3 上的每个 lane 都持有完整的 K 范围,而在 RDNA 4 上,波的每个半波各持有一半。
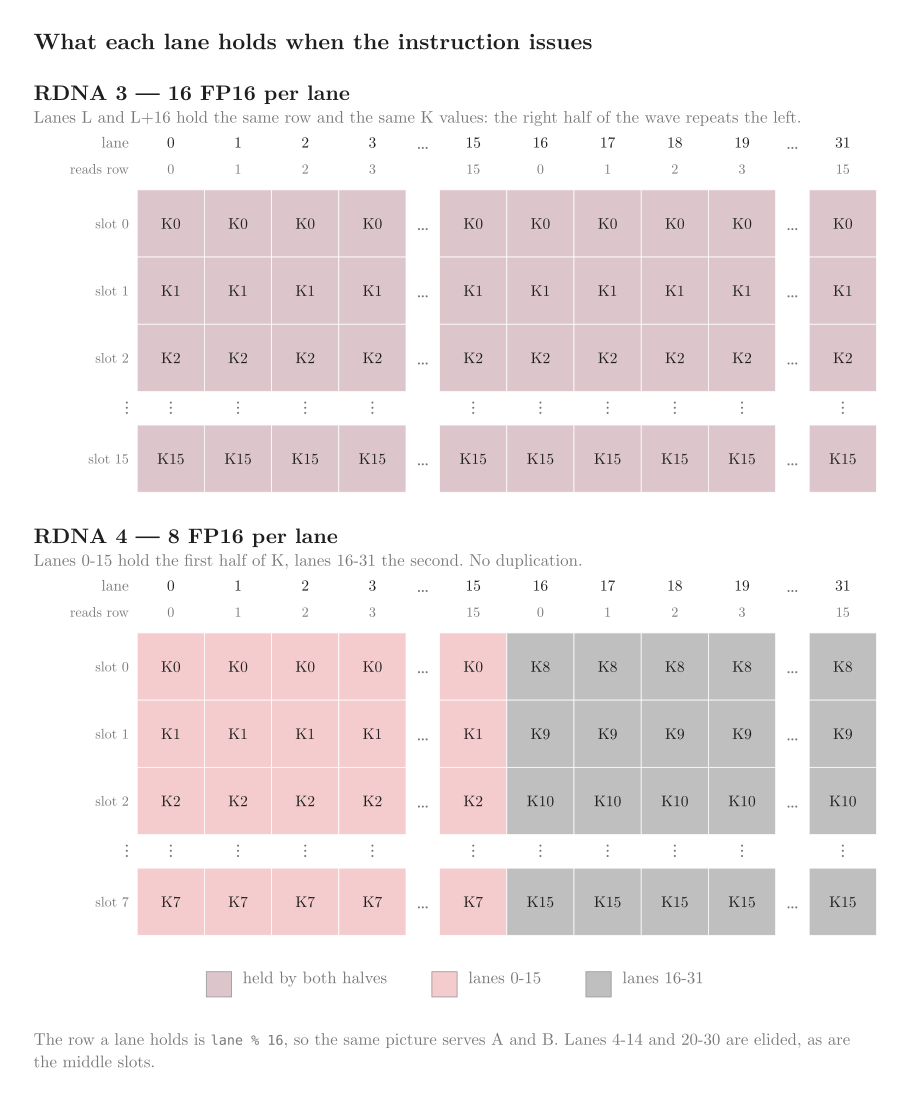
图 1:指令所期望的操作数布局。A 和 B 的布局方式相同。
在指令发射之前,每个 lane 必须持有正确的元素。LDS 中的 A 和 B 分块是 K 连续的,因此每个 lane 可以通过一次地址计算来复制其片段:
// Both operands are read the same way; only the tile pointer differs.
// `row` is the tile row this fragment starts at, `k` the K position within the tile.
const
int
offset
=
(
row
+
lane
%
16
)
*
stride
+
k
+
k_offset
(
lane
);
__builtin_memcpy
(
&
fragment
,
&
tile
[
offset
],
sizeof
(
fragment
));
lane % 16 选择 16 宽分块中的行。k_offset 在 RDNA 3 上为零,在 RDNA 4 上为 8 * (lane / 16),这在 RDNA 4 上将波的两个半波分开。片段类型决定复制宽度,因此相同的 memcpy 在 RDNA 3 上移动 32 字节,在 RDNA 4 上移动 16 字节。
累加器也以相同方式分布在 lane 之间。在 RDNA 3 上,当 OPSEL = false 时,lane L 持有列 L mod 16,累加器元素 2g 持有行 2g + L/16。在 RDNA 4 上,结果是打包的:lane L 持有列 L mod 16,累加器元素 g 持有行 8*(L/16) + g。
有两点后果对本文后续内容很重要:
RDNA 3 的片段宽度是 RDNA 4 片段的两倍。从 LDS 读取它需要两次 128 位加载而不是一次,并且任何 LDS 地址置换可供数据移动的位置都只有一半。
对于相同的输出分块,RDNA 3 的累加器使用两倍的寄存器。因此寄存器压力对两种架构的分块形状限制不同。
代码中出现了三个常量:
/// Size of the WMMA instruction's output tile, and of its K step.
constexpr
int
wmma_tile
=
16
;
/// FP16 values moved by one 128-bit access: 128 bits / 16 bits per value.
constexpr
int
elems_per_b128
=
8
;
/// Lanes in a wave32 wavefront.
constexpr
int
wave_size
=
32
;
elems_per_b128 是单个 lane 能够发出的最宽单次加载,并决定了每次拷贝的粒度:一个 RDNA 4 fragment 就是一次这样的访问,一个 RDNA 3 fragment 则是两次。
代码没有维护两个独立的内核,而是将架构差异隐藏在 policy 之后:一个由类型和静态函数组成的 struct,每个架构一个,内核以该 policy 为模板参数。选择在编译期完成。两个 policy 在四个地方存在差异:
|  | RDNA 3 (gfx11) | RDNA 4 (gfx12) |
| --- | --- | --- |
| Fragment 与累加器宽度 | 16 FP16 | 8 FP16 |
| 每个 lane 读取的 K 值 | 全部 16 个,复制 | 0-7 或 8-15,按 lane 半区 |
| 使用的累加器元素 | 每隔一个使用 | 全部使用 |
| 矩阵指令 | ..._w32(a, b, acc, false) | ..._w32_gfx12(a, b, acc) |
表 1. 两个 policy 的差异点。内核中的其余部分完全共享。
builtin 名称不同,并且 RDNA 3 的调用多一个参数:
// RDNA 3. The trailing false is OPSEL, which selects whether results land in the
// low or high half of each accumulator register. The builtin has no default for it:
// the argument is required, and passing false is what puts the results in the even
// elements described above.
acc
=
__builtin_amdgcn_wmma_f16_16x16x16_f16_w32
(
a
,
b
,
acc
,
/*OPSEL=*/
false
);
// RDNA 4. Same logical operation, different builtin.
acc
=
__builtin_amdgcn_wmma_f16_16x16x16_f16_w32_gfx12
(
a
,
b
,
acc
);
每个 policy 还提供 fragment 读取和累加器写回,因为二者都依赖于上面的 lane 映射。内核的其余部分看不到这些差异。
AMD ROCm Optimization Guide 记录了每种架构的 fragment 和累加器布局,以及对应的 builtin:RDNA3 dense WMMA builtins 和 RDNA4 dense WMMA builtins。关于这些指令的介绍,请参阅 How to accelerate AI applications on RDNA 3 using WMMA 和 Using the Matrix Cores of AMD RDNA 4 architecture GPUs on GPUOpen。编码位于“RDNA 3”和“RDNA 4”ISA 指南中,AMD matrix cores 则涵盖了在 CDNA 上扮演相同角色的 MFMA 指令。
目标 #
演进过程中的每一步都在同一问题上与 hipBLASLt 进行计时对比:A 为行主序、B 为列主序(TN)的 FP16 GEMM,除非另有说明,M = N = K = 8192。吞吐量以 2MNK / t TFLOPS/s 报告,其中 t 为平均内核时间(秒)。
基准测试直接调用 hipBLASLt,而不是通过 rocBLAS。启发式方法要么返回一个解决方案,要么运行停止。我们的内核和基线都使用 FP16 累加(HIPBLAS_COMPUTE_16F),与本文中的 WMMA 指令一致。请求 HIPBLAS_COMPUTE_32F 则会改用 FP32 累加。在较长的 K 上这更精确,但不是这里所测量的内容。
M = N = K = 8192 时的 hipBLASLt [ 1 ]:
| GPU | 平均毫秒 | 平均 TFLOPS/s |
| --- | --- | --- |
| Radeon PRO W7800 (gfx1100) | 19.34 | 56.86 |
| Radeon 8060S (gfx1151) | 28.14 | 39.07 |
| Radeon RX 9070 XT (gfx1201) | 8.05 | 136.58 |
表 2. `M=N=K=8192` 时 hipBLASLt 的吞吐量,每一步都以该基线进行测量对比。
这些数值是目标范围。下文每个优化步骤都会报告其相对于这些数值的耗时。hipBLASLt 会针对每种形状和架构进行调优;除非某一步骤另有说明,我们的内核在整个优化过程中使用同一套配置。
W7800 的 FP16 峰值吞吐量为 90.4 TFLOPS/s,8060S 为 59.4,9070 XT 为 195。hipBLASLt 达到该峰值的 63% 到 70%。
CU 模式与 WGP 模式 #
本文中的所有内核均运行在 CU 模式下,该模式在编译时通过传入 `-mcumode` 编译器选项启用。若不传入该选项,编译器默认使用 WGP 模式。使用 HIP 运行时编译时,请在传给 `hiprtcCompileProgram()` 的选项数组中包含 `-mcumode`。配套仓库中的基准测试在构建时向 `amdclang++` 传入相同的标志。我们未对 WGP 模式进行基准测试,因此 CU 模式是固定设置的一部分,而非可调参数。
在 RDNA 上,两个计算单元(CU)组成一个工作组处理器(WGP),每个 CU 包含两个 SIMD32 单元。该模式决定了一个块中有多少波前一起执行,以及它们获得多少 LDS:
WGP 模式:一个块的四个波前在 WGP 的全部四个 SIMD32 上执行,共享一块连续的 LDS。
CU 模式:一个块的两个波前在一个 CU 的两个 SIMD32 上执行,使用 WGP LDS 的一半。
WGP 模式可以提高占用率,但对于依赖原子操作或大量波前间通信的内核,可能会损失性能。CU 模式保持两个 CU 相互独立,适合避免大量波前间通信的工作负载。无论哪种模式,一个工作组最多可共享 64 KB 的 LDS,依据“RDNA 3”ISA 指南,这也是表 9 所依据的预算。更多细节请参阅 HIP 文档中的 CU 模式与 WGP 模式对比,以及 AMD ROCm 优化指南中的 LDS bank 冲突分析,其中解释了每种模式如何将工作组映射到 LDS bank 上。
步骤 1:从简单开始,一个波前和一个瓦片 #
步骤 1 是其他所有步骤进行测量对比的基线。一个波前负责一个 32×32 的输出瓦片,即一个 2×2 的 16×16 WMMA 瓦片网格,保存在四个累加器中。每次 K 迭代将 A 和 B 的一个切片复制到 LDS,从 LDS 中取出并相乘,然后重复。
三个瓶颈主导了耗时:每个块只运行一个波前,每个 lane 一次只复制一个元素,并且循环每处理 16 个 K 值就要付出两次屏障的代价。
for
(
int
k_tile
=
0
;
k_tile
<
num_k_tiles
;
++
k_tile
)
{
// One element per lane per step.
for
(
int
i
=
lane
;
i
<
block_m
*
block_k
;
i
+=
wave_size
)
{
tile_a
[
i
/
block_k
][
i
%
block_k
]
=
A
[(
block_row
+
i
/
block_k
)
*
K
+
k_tile
*
block_k
+
i
%
block_k
];
}
// ... the same for B ...
__syncthreads
();
typename
Policy
::
FragmentA
a
[
tiles_m
];
typename
Policy
::
FragmentB
b
[
tiles_n
];
// load_a/load_b are a memcpy from LDS into a vector register: a fixed address calculation
// per architecture (see the WMMA section above).
for
(
int
m
=
0
;
m
<
tiles_m
;
++
m
)
{
Policy
::
load_a
(
a
[
m
],
&
tile_a
[
0
][
0
],
m
*
wmma_tile
,
0
,
lane
,
block_k
);
}
for
(
int
n
=
0
;
n
<
tiles_n
;
++
n
)
{
Policy
::
load_b
(
b
[
n
],
&
tile_b
[
0
][
0
],
n
*
wmma_tile
,
0
,
lane
,
block_k
);
}
for
(
int
m
=
0
;
m
<
tiles_m
;
++
m
)
{
for
(
int
n
=
0
;
n
<
tiles_n
;
++
n
)
{
// Policy::mma calls the architecture's WMMA built-in (Table 1) directly, with no
// inline assembly.
Policy
::
mma
(
acc
[
m
][
n
],
a
[
m
],
b
[
n
]);
}
}
// The next iteration overwrites the tiles, so every lane must be done reading.
__syncthreads
();
}
tile_a[m][k] 和 tile_b[n][k] 均以 K 为最后一维进行索引,与前面的行主序 A 和列主序 B 布局相匹配。两个拷贝循环互为镜像。性能数据如下 [ 1 ] :
| GPU | 平均 ms | hipBLASLt (ms) |
| --- | --- | --- |
| gfx1100 | 148.26 | 19.34 |
| gfx1151 | 334.95 | 28.14 |
| gfx1201 | 150.12 | 8.05 |
表 3. 步骤 1:每个 block 一个 wave,32×32 输出 tile。
即 150 ms,而 hipBLASLt 的目标为 8 到 28 ms。后续步骤将逐一消除上述开销。
测量资源 #
除计时外,每个步骤还报告 block 所需的 LDS 以及由此得出的占用率。占用率是指一个 SIMD 可以保持驻留的 wave 数量,由编译器根据寄存器和 LDS 需求推导得出:
amdclang++
-O3
-std
=
c++17
--offload-arch
=
gfx1100
-mcumode
\
-Rpass-analysis
=
kernel-resource-usage
-c
your_kernel.hip
-o
/dev/null
HIP 性能指南涵盖了占用率能带来什么、不能带来什么。AMD ROCm 优化指南深入讨论了如何提高占用率,并在一个 GEMM kernel 中分析了寄存器压力和占用率。
要对照硬件实际启动的情况确认这些数字,请使用 rocprofv3 进行 kernel 跟踪:
rocprofv3
--kernel-trace
--output-format
csv
-d
resources
-o
trace
--
./your_benchmark
生成的 kernel_trace.csv 中每次 kernel 调度占一行。LDS_Block_Size 列给出每个 block 分配的 LDS 字节数——除以 1024 即得到千字节数。它与编译器的数字完全一致,从而确认了占用率的计算。
步骤 2:为复用而分块,以及软件流水线 #
步骤 1 每产生 32 个输出就要从全局内存读取 16 个 A 和 B 的值。步骤 2 同时应用四种标准 GEMM 技术,以达到常规的分块 kernel。这是唯一一个同时改变多项内容的步骤。
更大的 tile。每个 block 现在通过 4×4 的 wave 网格计算 C 的 256×256 块。每个 wave 拥有 4×4 的 WMMA tile 网格,即 16 个累加器。该 block 在 LDS 中保存 A 的 256×16 切片和 B 的 16×256 切片,每个元素读取一次即可产生 256 个输出,而非读取一次仅产生 32 个输出。
更宽的拷贝。每个 lane 每次访问移动八个 FP16 值而非一个,充分利用 128 位加载路径。
双缓冲。每个操作数使用两个 LDS tile,使 wave 从一个缓冲区进行乘法运算,同时下一个 K 切片拷贝到另一个缓冲区。
分阶段提交。传入的 tile 在寄存器中等待,仅在当前 tile 被读取后才到达 LDS,从而消除了每个 K 步骤的第二个屏障。
第一个改动建立了后续内容所使用的 tile 层级结构。图 2 展示了 block tile 如何划分为 wave tile 和 WMMA tile,以及它读取哪些操作数切片:
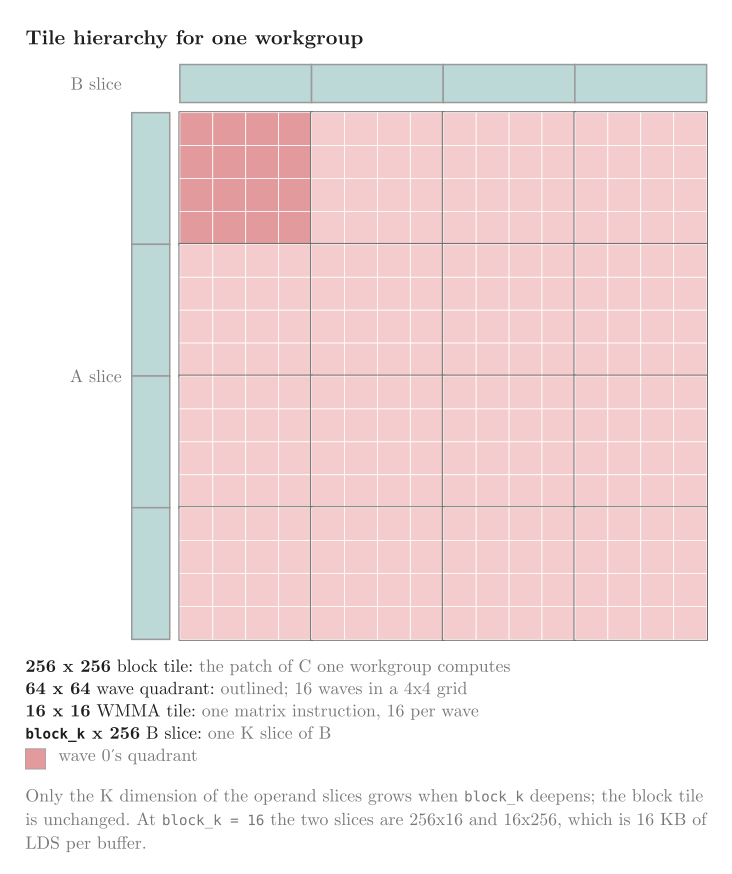
图 2:一个 workgroup 所拥有的内容。block tile 是它计算的 C 的区块;操作数切片是它保存在 LDS 中的内容。
这四个改动定义了后续每一步都保持的循环:预取、乘、提交、一个 barrier。
// Two LDS buffers per operand: one is read while the other is filled.
LdsTile
tile
[
2
];
int
current
=
0
,
next
=
1
;
load_tile_to_lds
(
tile
[
current
],
/*k_tile=*/
0
);
block_sync
();
for
(
int
t
=
0
;
t
<
num_k_tiles
-
1
;
++
t
)
{
// Issue the next tile's global reads into registers. They have the whole
// multiply below to complete in.
staged
=
load_tile_to_registers
(
/*k_tile=*/
t
+
1
);
multiply_from_lds
(
tile
[
current
],
acc
);
// Only here do those reads have to have landed.
store_registers_to_lds
(
tile
[
next
],
staged
);
block_sync
();
swap
(
current
,
next
);
}
// The loop stops one tile short. The last tile is already in LDS and has
// nothing left to overlap with, so it is multiplied on its own.
multiply_from_lds
(
tile
[
current
],
acc
);
仅靠双缓冲并不能解决所有问题。如果没有分阶段提交,循环会在传入 tile 到达时立即将其写入 LDS,这会迫使 wave 立即等待该全局读取:
global_load next
wait for global_load          # stall: nothing else was issued to overlap it
ds_write next LDS buffer
ds_read current LDS buffer
wait for ds_read
WMMA
将读取暂存在寄存器中,直到当前 tile 完成乘法之后,就把这个等待移到实际工作之后,而不是之前:
global_load next
ds_read current LDS buffer
wait for ds_read
WMMA                          # the global load's latency overlaps this
wait for global_load          # much of it is already hidden
ds_write next LDS buffer
wait for ds_write
四个改动合并后的计时,与 Step 1 [ 1 ] 对比:
| GPU | Step 1 (ms) | 平均 ms | 对比 step 1 | hipBLASLt (ms) |
| --- | --- | --- | --- | --- |
| gfx1100 | 148.26 | 36.89 | 4.0x | 19.34 |
| gfx1151 | 334.95 | 88.24 | 3.8x | 28.14 |
| gfx1201 | 150.12 | 30.25 | 5.0x | 8.05 |
表 4. Step 2:256×256 输出 tile、宽拷贝、双缓冲和分阶段提交。
资源报告显示了更大 tile 的代价。每个 wave 现在累加 16 个 WMMA tile 而不是四个,两个 LDS 缓冲区占用 32 KB:
|  | LDS | Waves/SIMD |
| --- | --- | --- |
| RDNA 3 | 32 KB | 8 |
| RDNA 4 | 32 KB | 12 |
表 5. Step 2 资源使用情况。对于相同的 tile,RDNA 3 保持更少的常驻 wave,因为其累加器宽度是两倍。
相同的 kernel 和相同的 tile,但 RDNA 3 更宽的累加器提高了其寄存器压力。在 32 KB 下,LDS 预算允许更多 wave,因此寄存器在这里成为瓶颈,使 RDNA 3 损失四个常驻 wave。
步骤 3:避免 LDS Bank 冲突 #
当每个 lane 从 LDS tile 的不同行读取其 WMMA fragment 时,行步长决定了每次访问命中哪个 LDS bank。LDS 有 32 个 bank,每个 bank 四字节。如果步长将行对齐到相同的 bank,这些访问就会串行化。关于其机制以及下面两种修复方法的详细信息,请参阅 Avoiding LDS Bank Conflicts on AMD GPUs with CK-Tile 以及 AMD ROCm Optimization Guide 中的 LDS bank 冲突分析。
填充(Padding)为每一行添加未使用的元素,使连续的行从不同的 bank 开始:
/// Padded row stride: the fix in this step.
constexpr
int
padded_stride
=
block_k
+
lds_pad
;
// 16 + 8
置换(Permutation)保持 tile 大小不变,并打乱每块元素在行内的落位。有两个量来设定它。unit 是必须保持在一起的元素连续段,即 Policy::fragment_elems:在 RDNA 3 上为 16,在 RDNA 4 上为 8。任何更小的值都会将一个 fragment 拆分到两个位置。blocks 是这样一段连续元素在一行中能容纳的数量,即 block_k / unit。元素 (row, k) 随后移动到块 (k / unit) XOR (row % blocks):
/// Offset of element (row, k) once the row's blocks have been permuted.
auto
swizzle
=
[](
int
row
,
int
k
)
{
return
row
*
block_k
+
((
k
/
unit
)
^
(
row
%
blocks
))
*
unit
+
(
k
%
unit
);
};
在 block_k = 16 时,RDNA 3 的 fragment 为 16 个元素,恰好一行,因此 blocks = 1,置换在 gfx1100 上不起作用。这就是表 7 中两列计时在那里一致的原因。
| block_k | RDNA 3 blocks | RDNA 4 blocks |
| --- | --- | --- |
| 16 | 1 | 2 |
| 32 | 2 | 4 |
| 64 | 4 | 8 |
表 6. 每个 LDS 行中可用于置换的块数。一个块意味着置换是恒等变换。
两种布局的计时 [ 1 ]:
| GPU | Padded (ms) | Permuted (ms) | hipBLASLt (ms) |
| --- | --- | --- | --- |
| gfx1100 | 37.02 | 36.71 | 19.34 |
| gfx1151 | 88.90 | 88.08 | 28.14 |
| gfx1201 | 30.25 | 30.37 | 8.05 |
表 7. 步骤 3:在 256×256 输出 tile 下,填充与 XOR 置换的对比。
资源报告显示了填充的代价:
|  | LDS | Waves/SIMD |
| --- | --- | --- |
| RDNA 3, padded | 48 KB | 8 |
| RDNA 3, permuted | 32 KB | 8 |
| RDNA 4, padded | 48 KB | 8 |
| RDNA 4, permuted | 32 KB | 12 |
表 8. 步骤 3 资源使用情况。填充使 tile 增大一半,这使 RDNA 4 损失四个常驻 wave。
填充增加了 16 KB 的 LDS。在 48 KB 时,64 KB 预算内只能容纳一个 block,这使 RDNA 4 从 12 个常驻 wave 降至 8 个。置换使 tile 保持在 32 KB 并保持该占用率,但在该 tile 尺寸下对 RDNA 3 没有任何作用。
两种修复方法在此 tile 形状下均未改变计时:表 7 中填充和置换后的数值与表 4 的 36.89 ms/88.24 ms/30.25 ms 在测量噪声范围内一致。这可能是因为此处 block_k 仍为 16,因此每个屏障只有一片 K 位于 LDS 中,几乎没有并发 LDS 流量可供 bank 冲突影响。我们未在更深的 block_k 下确认这一点;一旦步骤 5 加深 K,任一修复方法可能都会更加重要。
本文其余部分使用填充。置换是特定于 fragment 尺寸的:不同的 WMMA tile 宽度将需要不同的置换模式,而填充只是添加未使用的列,并且在任何为 fragment 尺寸倍数的宽度下都有效。更重要的是,占用率并不是性能的唯一杠杆。步骤 5 有意将填充增加的 16 KB 换回更深的 K 切片——全局拷贝之间更多的算术运算——而不是将其用于更多常驻 block。更高的占用率隐藏延迟;更深的 K 减少需要隐藏的延迟量。数据表明,在此处 K 深度权衡是更好的选择。
步骤 4:用于全局加载的缓冲区资源描述符 #
步骤 1 到 3 假设 block 读取的每个全局地址都在边界内。这迫使 tile 尺寸必须整除矩阵:对于 M = 8192,A 的 96 宽条带在尾部 block 中会读取超出分配末尾的位置。
步骤 4 将全局加载切换为缓冲区资源描述符。硬件知道分配的大小,并对越界地址返回零而不是触发错误:
/// A plain untyped buffer whose reads are bounds-checked against the size it is given.
/// The field layout is in the ISA guides, under the buffer resource descriptor.
constexpr
unsigned
buffer_config_word
=
0x31004000
;
/// Loads issued against this descriptor return zero for out-of-bounds addresses instead
/// of faulting, which is what allows block tiles that do not divide the matrix evenly.
__device__
__forceinline__
__amdgpu_buffer_rsrc_t
make_buffer
(
const
void
*
ptr
,
unsigned
bytes
)
{
return
__builtin_amdgcn_make_buffer_rsrc
(
const_cast
<
void
*>
(
ptr
),
/*stride=*/
0
,
bytes
,
buffer_config_word
);
}
bytes 是整个分配的大小,因为这是硬件进行钳制所依据的。与矩阵边缘重叠的尾部 block 读取零,对结果没有任何贡献。缓冲区资源描述符的字段布局记录在“RDNA 3”ISA 指南和“RDNA 4”ISA 指南的缓冲区资源描述符部分中。
此步骤在相同 tile 尺寸下不改变计时:输出 tile 仍为 256×256,LDS 保持 48 KB 不变。它为步骤 5 创造了条件,步骤 5 选择一个 128×96 的输出 tile,该 tile 既不能整除 M 也不能整除 N。
步骤 5:以 tile 面积换取 K 深度 #
步骤 1 到 4 在 LDS 中一次只保留一个 WMMA 步骤的 K:沿 K 方向 16 个值,每个累加器一条矩阵指令,然后一个屏障和一次新的全局拷贝。步骤 5 改为在 LDS 中保留四个 WMMA 步骤的 K。这将屏障减少四倍,并使每个 wave 每次拷贝有四轮算术运算,代价是更宽的操作数切片。
加深 K 会加宽两个操作数 tile,而输出 tile 保持不变,如图 3 所示,block_k 为 16、32 和 64:
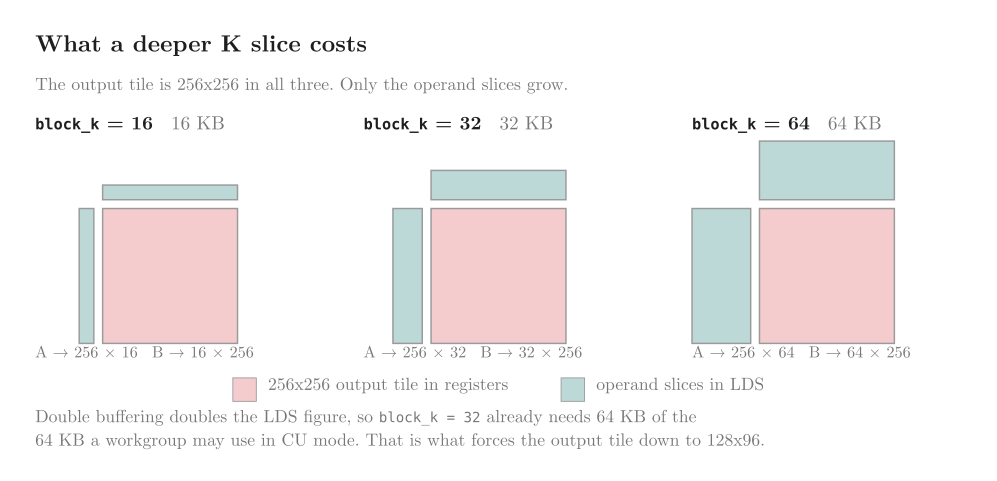
图 3:加深 K 会拓宽操作数切片,而输出瓦片保持不变。
在 256×256 的输出瓦片下,64 KB 的 LDS 预算会立刻耗尽,因此必须缩小输出瓦片来换取深度:
| 输出瓦片 | block_k | A 瓦片 | B 瓦片 | 缓冲区 | LDS |
| --- | --- | --- | --- | --- | --- |
| 256×256 | 16 | 256×16 | 16×256 | 2 | 48 KB |
| 256×256 | 32 | 256×32 | 32×256 | 2 | 80 KB(过大) |
| 128×128 | 64 | 128×64 | 64×128 | 2 | 72 KB(过大) |
| 128×96 | 64 | 128×64 | 64×96 | 2 | 63 KB |
表 9. 操作数瓦片及每个 block 所需的 LDS。64 KB 的预算排除了中间两行。
这些数字包含了第 3 步中每行八元素的填充,因此最后一行是 63 KB,而不是仅按元素数量计算得出的 56 KB。
96 宽的输出瓦片之所以可行,完全是因为第 4 步:96 既不能整除 8192 也不能整除 28672,因此如果没有越界钳制,末尾的 block 会读到 A 的末尾之外。
与第 3 步填充版本 [ 1 ] 的耗时对比:
| GPU | 平均 ms | 对比第 3 步填充版本 | hipBLASLt (ms) |
| --- | --- | --- | --- |
| gfx1100 | 35.44 | 1.04x | 19.34 |
| gfx1151 | 72.40 | 1.23x | 28.14 |
| gfx1201 | 20.81 | 1.45x | 8.05 |
表 10. 第 5 步:每个瓦片四个 WMMA 的 K 步,在 128×96 的输出瓦片上。对比基准为第 3 步填充版本,因为第 4 步只改变了读取的发起方式。
这是整个演进过程中最大的一次资源变化。63 KB 的瓦片只留下每个计算单元一个 block 的空间,因此占用率从每个 SIMD 八个常驻 wave 降到两个。两种架构在此瓦片尺寸下也都接近寄存器上限。尽管占用率下降,耗时仍然有所改善,但改善幅度取决于架构:RDNA 4 收益最大(1.45x),RDNA 3.5 较小(1.23x),RDNA 3 几乎没有改善(1.04x)。每个 wave 在屏障之间持有四倍的算术量,而更大的瓦片在每次迭代中从全局内存搬运的数据也成比例增加。寄存器上限正是阻止瓦片进一步增大的原因。
第 6 步:面向缓存复用的 Block 调度 #
第 6 步只改变 block 被分配输出瓦片的顺序。内核在其他方面与第 5 步相同。GPU 启动的 block 数量远超其能同时运行的数量,并按索引顺序派发,因此连续的 block 索引会一起常驻。这些 block 在输出网格中的位置决定了它们共享多少 A 和 B:如果它们的读取有重叠,后到达的 block 会在 L2 中找到数据,而不必回到内存。图 4 比较了本步尝试的两种调度方式,展示了在每种方式下 16 个并发 block 读取 A 和 B 的哪些条带。
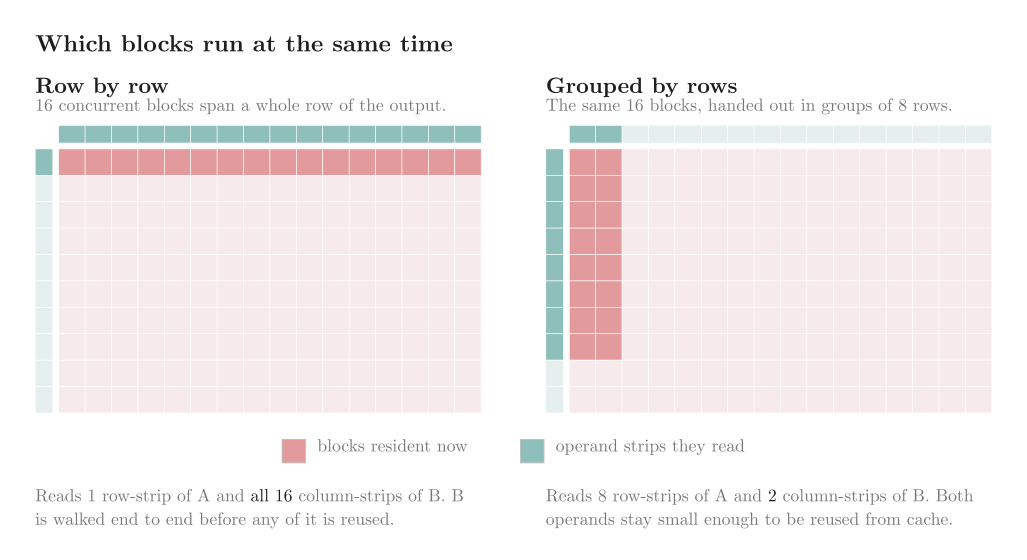
图 4:两种调度下的相同 16 个块,以及它们之间读取的操作数条带。
逐行分配将并发块分散到输出的一整行上。它们会触及 A 的一个条带,但在 B 的任何部分被复用之前,会触及 B 的所有列条带。将块分组为高区域可使并发读取在两个操作数上重叠,因此 A 和 B 的更多部分能在整个组内保留在 L2 中。
该映射只需几行索引运算。这里的 tiles_m 和 tiles_n 统计输出网格中的块数,而不是本文前面使用的每个 wave 的 WMMA 瓦片数:
// tiles_m, tiles_n: the number of output tiles the grid is divided into, in each dimension.
const
int
index_n
=
block
%
tiles_n
;
const
int
index_m
=
block
/
tiles_n
;
// The last group is short when the rows do not divide evenly.
const
int
group_rows
=
(
index_m
<
tiles_m
-
tiles_m
%
GroupSize
)
?
GroupSize
:
tiles_m
%
GroupSize
;
const
int
group
=
index_m
/
GroupSize
;
const
int
local
=
index_n
+
(
index_m
%
GroupSize
)
*
tiles_n
;
*
tile_row
=
(
local
%
group_rows
+
group
*
GroupSize
)
*
BlockM
;
*
tile_col
=
(
local
/
group_rows
)
*
BlockN
;
这与 Composable Kernel 的 block_to_ctile_map.hpp 中的 BlockToCTileMap_M00_N0_M01Adapt 相匹配,其中 GroupSize 设置为 8。
与 Step 5 的计时对比 [ 1 ]:
| GPU | 平均 ms | 对比 step 5 | hipBLASLt (ms) |
| --- | --- | --- | --- |
| gfx1100 | 21.66 | 1.64x | 19.34 |
| gfx1151 | 43.19 | 1.68x | 28.14 |
| gfx1201 | 11.94 | 1.74x | 8.05 |
表 11. Step 6:按行组而非逐行将瓦片分配给块。
资源使用情况与 Step 5 相比没有变化:两种架构上均为 63 KB LDS 和每个 SIMD 两个常驻 wave。每个 GPU 都获得了 64% 到 74% 的提升。该收益仅来自缓存复用。
Step 7:将预取与 WMMA 交错 #
对于 LDS 中持有的每个 K 瓦片,wave 会运行消费它所需的所有 WMMA 矩阵指令。在此内核中,共有 48 条这样的指令:跨四个 K 切片的 4×3 输出瓦片网格。这与 Step 7 在它们之间交错的预取和片段读取指令是分开的,如下所述。实现将这一固定、有序的序列称为 fold,而展开它的结构体也因此命名为 FoldStep。
直到 Step 6,下一个 K 瓦片的所有全局读取都在 fold 开始之前发出。这使它们脱离了关键路径,但将它们集中成一次突发。每个线程需要为其下一个瓦片份额发出 14 次读取。当这些读取在序列早期完成时,fold 的大部分运行期间没有其他操作使内存系统保持忙碌。
Step 7 则将这些预取分散到整个 fold 中,每两条 WMMA 指令发出一次,并交替操作数。图 5 对比了之前和之后的指令顺序:
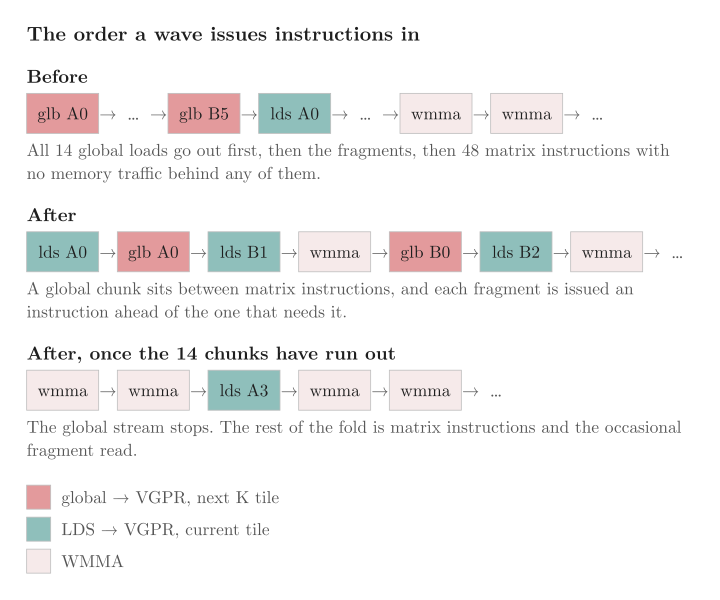
图 5:同一个 K tile 的相同指令,以两种不同顺序发出。A0 和 B5 这样的标签命名的是 14 个预取块——来自 FoldContext 的 chunks_a = 8(对应 A)、chunks_b = 6(对应 B)——而不是 WMMA 片段。省略号表示更多相同内容。
每次读取都提前于其消费者一条指令发出。如果读取紧挨在使用它的指令之前,就会使 wave 停顿;若中间隔一条矩阵指令,延迟就能与 wave 本来就要执行的算术重叠。
交错只改变全局预取。来自 LDS 的片段读取仍然稀疏,因为遍历以 n 为最快维度:A 的一个片段对 wave tile 网格的每一行读取一次,而 B 的一个片段只在 K 切片的第 1 行读取,然后在其余行中复用。
14 个预取块在 48 条指令中的第 14 条完成,因此 fold 的后三分之二仍然在没有全局流量的情况下运行。突发是错开的,而不是被移除:
// Step 0:  acc[0][0] += A0 * B0
prefetch_a_chunk
(
0
);
// one chunk of the next K tile
read_fragment
(
b
[
1
]);
// for step 1
matrix_multiply
(
acc
[
0
][
0
],
a
[
0
],
b
[
0
]);
// Step 1:  acc[0][1] += A0 * B1
prefetch_b_chunk
(
0
);
read_fragment
(
b
[
2
]);
matrix_multiply
(
acc
[
0
][
1
],
a
[
0
],
b
[
1
]);
// Step 2:  acc[0][2] += A0 * B2
prefetch_a_chunk
(
1
);
read_fragment
(
a
[
1
]);
matrix_multiply
(
acc
[
0
][
2
],
a
[
0
],
b
[
2
]);
// ... 45 more steps.
这是一种标准的软件流水线技术,也用于 hipBLASLt 等库中,其中在途内存操作与计算重叠。这里具体的指令级交错调度受 HipKittens: Fast and Furious AMD Kernels 启发,该工作将整个 wave 分配给内存或数学运算。RDNA 上的 32 lane wave 和较小的寄存器文件使得逐指令交错比 wave 级特化更自然。
prefetch_a_chunk / prefetch_b_chunk 将每个块从全局内存带入向量寄存器(真实代码中为 staged_a / staged_b),并与 fold 交错,如上所示。从这些寄存器写入下一个 K tile 的 LDS 缓冲区是一个单独步骤:它在整个 fold 之后作为一次批量提交运行,位于交换缓冲区的屏障之前。使用两个缓冲区时,该写入进入 fold 未读取的缓冲区,因此之前不需要屏障。使用一个缓冲区时(步骤 8),它会覆盖 fold 刚刚读取的缓冲区,因此需要在提交前加屏障,以确保每个 wave 先完成读取。
要使其工作,需要两件事。
fold 必须在编译时完全展开。序列中的每一步都在向量寄存器中选择一个片段和一个累加器,这些在运行时无法动态索引而不溢出到 scratch。下面的递归模板将步骤索引作为编译时常量提供:
template
<
typename
Policy
,
int
Step
,
/* tile shape... */
>
struct
FoldStep
{
using
here
=
FoldPosition
<
Step
,
tiles_m
,
tiles_n
>
;
using
next
=
FoldPosition
<
Step
+
1
,
tiles_m
,
tiles_n
>
;
__device__
static
void
run
(
const
Context
&
ctx
)
{
constexpr
int
chunk
=
Step
/
2
;
if
constexpr
(
Step
%
2
==
0
&&
chunk
<
Context
::
chunks_a
)
{
ctx
.
reader_a
.
template
prefetch
<
chunk
>
(
ctx
.
staged_a
);
}
else
if
constexpr
(
Step
%
2
==
1
&&
chunk
<
Context
::
chunks_b
)
{
ctx
.
reader_b
.
template
prefetch
<
chunk
>
(
ctx
.
staged_b
);
}
if
constexpr
(
Step
+
1
<
Context
::
steps
)
{
if
constexpr
(
next
::
a_index
!=
here
::
a_index
)
{
ctx
.
reader_a
.
template
read_fragment
<
next
::
m
,
next
::
slice
>
(
ctx
.
a
[
next
::
a_index
]);
}
if
constexpr
(
next
::
b_index
!=
here
::
b_index
)
{
ctx
.
reader_b
.
template
read_fragment
<
next
::
n
,
next
::
slice
>
(
ctx
.
b
[
next
::
b_index
]);
}
}
__builtin_amdgcn_s_setprio
(
1
);
Policy
::
mma
(
ctx
.
acc
[
here
::
m
][
here
::
n
],
ctx
.
a
[
here
::
a_index
],
ctx
.
b
[
here
::
b_index
]);
__builtin_amdgcn_s_setprio
(
0
);
if
constexpr
(
Step
+
1
<
Context
::
steps
)
{
FoldStep
<
Policy
,
Step
+
1
,
/* ... */
>::
run
(
ctx
);
}
}
};
上面的代码片段是简写。完整的 FoldStep 以及 FoldContext 和 FoldPosition 位于随附仓库的 stage07_interleave.hip 中。地址提升位于 gemm_common.hpp 中的 OperandReader。
地址在使用点也必须开销低廉。来自 LDS 的片段读取和来自全局的预取块都有一个线程相关部分和一个位置相关部分。较早的步骤在每次读取时重建两者,而前置突发会用自己的停顿将其隐藏。这里读取位于两条矩阵指令之间,因此每次地址计算都要竞争发射槽。我们在循环前将线程相关部分提升为指针,并将其余部分折叠为模板参数。
交错将预取和片段读取与矩阵指令放入同一发射窗口,因此两者现在竞争 wave 的发射槽。在 WMMA 前后提高 wave 的调度器优先级,使硬件倾向于先发射矩阵指令,让交错的读取填充它留下的发射槽,而不是取代它:
__builtin_amdgcn_s_setprio
(
1
);
Policy
::
mma
(
ctx
.
acc
[
here
::
m
][
here
::
n
],
ctx
.
a
[
here
::
a_index
],
ctx
.
b
[
here
::
b_index
]);
__builtin_amdgcn_s_setprio
(
0
);
s_setprio 是一个运行时提示:当同一 SIMD 上驻留的多个 wave 准备发射时,它影响哪个 wave 赢得共享执行端口的仲裁,这在这里很重要,因为该内核在此 tile 大小下每个 SIMD 持有 2 到 4 个 wave(表 13)。我们没有发现为编译器添加显式调度约束(例如 __builtin_amdgcn_sched_barrier)有帮助或必要:编译器已经保持了源代码布局的交错顺序。
两种架构上的寄存器使用量均有所下降,RDNA 3 上从 252 降至 205 VGPR,RDNA 4 上从 245 降至 138,但两者均未改变占用率,63 KB 的 tile 已将其固定在每 SIMD 两个 wave(表 13 列出了步骤 6 至 8 的数据)。
与步骤 6 的计时对比 [ 1 ]:
| GPU | 平均 ms | 对比步骤 6 | hipBLASLt (ms) |
| --- | --- | --- | --- |
| gfx1100 | 17.10 | 1.27x | 19.34 |
| gfx1151 | 31.21 | 1.38x | 28.14 |
| gfx1201 | 9.85 | 1.21x | 8.05 |
表 12. 步骤 7:全局预取在 fold 内部发出,而非在 fold 之前集中发出。
三款 GPU 均获得 21% 至 38% 的提升。交错执行暴露了地址运算,而提升则将其从调度竞争的发射槽中移除。
步骤 8:重新审视双缓冲 #
步骤 2 为每个操作数引入了两个 LDS 缓冲区,以便在乘法运算当前 K 切片的同时,将下一个 K 切片复制进来。步骤 7 将全局预取与 WMMA 在整个 fold 中交错执行。步骤 8 提出了一个独立的问题:在 63 KB 的 tile 下,第二个 LDS 缓冲区是否仍然值得其占用率代价?
该内核与步骤 7 相同,但使用一个缓冲区而非两个,因此该对比隔离了这一选择。交错执行保持不变。变化的是步骤 2 中的双缓冲流水线:使用单缓冲区时,提交会覆盖 wave 刚刚读取的 tile,因此每次写入前需要额外的屏障。
// With two buffers the commit writes to the tile nobody is reading, so it
// needs one barrier. With one buffer it overwrites the tile just read, so
// every wave has to finish reading first:
block_sync
();
// extra: read-before-write
store_registers_to_lds
(
tile
,
staged
);
block_sync
();
在运行任一变体之前,资源权衡已显而易见。双缓冲区行与步骤 7 一致。步骤 6 仅供参考,因为步骤 7 是寄存器使用发生变化的地方。
| 变体 | 每块 LDS | 每 SIMD 的 wave 数 | VGPR,RDNA 3 | VGPR,RDNA 4 |
| --- | --- | --- | --- | --- |
| 步骤 6 | 64512 B (63 KB) | 2 | 252 | 245 |
| 步骤 7,双缓冲区 | 64512 B (63 KB) | 2 | 205 | 138 |
| 步骤 8,单缓冲区 | 32256 B (31.5 KB) | 4 | 200 | 133 |
表 13. 步骤 6 至 8 的 LDS、占用率和向量寄存器(VGPR)使用情况,输出 tile 为 128×96,操作数 tile 为 128×64 和 64×96。RDNA 3 的数据在 gfx1100 和 gfx1151 上相同。
将 LDS 减半使两种架构上的占用率从每 SIMD 两个 wave 翻倍至四个 wave。寄存器使用量仅略有变化,RDNA 3 和 RDNA 4 上均变化 5 个 VGPR,且不改变该占用率步进。
表 14 展示了单缓冲区变体的 14 倍性能,并将其与步骤 7(表 12)进行对比,后者是最终的双缓冲区内核 [ 1 ]:
| GPU | 平均毫秒 | 对比步骤 7 | hipBLASLt (毫秒) |
| --- | --- | --- | --- |
| gfx1100 | 15.50 | 1.10x | 19.34 |
| gfx1151 | 27.06 | 1.15x | 28.14 |
| gfx1201 | 8.71 | 1.13x | 8.05 |
表 14. 步骤 8:使用一个 LDS 缓冲区而非两个。
所有三款 GPU 均获得 10% 到 15% 的提升。是否保留第二个缓冲区是按目标决定的。此步骤放在最后,因为它反转了步骤 2 中的双缓冲区流水线,而不是步骤 7 中的预取调度。
当前进展 #
在整个进展过程中使用的方形形状下,最终内核与 hipBLASLt 的对比 [ 1 ]:
| GPU | 最终 (毫秒) | hipBLASLt (毫秒) | 最终 (TFLOPS/s) | hipBLASLt (TFLOPS/s) |
| --- | --- | --- | --- | --- |
| gfx1100 | 15.50 | 19.34 | 70.92 | 56.86 |
| gfx1151 | 27.06 | 28.14 | 40.63 | 39.07 |
| gfx1201 | 8.71 | 8.05 | 126.17 | 136.58 |
表 15. 在 `M=N=K=8192` 下最终内核与 hipBLASLt 的对比。
根据架构和 GEMM 形状的不同,该内核比 hipBLASLt 快或慢几个百分点,并且完全用 HIP 编写。
实际工作负载很少是方形的,因此最终内核也在 M = 8192、N = 28672、K = 8192 下运行,这是一种宽大的、N 偏重的形状,类似于 transformer 前馈投影产生的形状 [ 1 ]:
| GPU | 最终 (毫秒) | hipBLASLt (毫秒) | 最终 (TFLOPS/s) | hipBLASLt (TFLOPS/s) |
| --- | --- | --- | --- | --- |
| gfx1100 | 54.55 | 67.81 | 70.55 | 56.75 |
| gfx1151 | 93.33 | 100.52 | 41.23 | 38.28 |
| gfx1201 | 29.55 | 28.54 | 130.24 | 134.82 |
表 16. 在 `M=8192`、`N=28672`、`K=8192` 下最终内核与 hipBLASLt 的对比。
两种形状使用相同的 tile 配置,没有针对形状的专门调优。输出 tile 的 128 边可以整除 M = 8192,但 96 边不能整除 N = 28672;第 4 步的缓冲区描述符使这一点合法,因为在尾部 N 块中越界读取会返回零。
两种形状都很大,一种 tile 配置即可同时服务两者。一个 128×96 的 tile 跨四个 K 步,假定有足够的工作量将 GPU 填满数次。对于瘦 GEMM,或者小到能放入缓存的小型 GEMM,这种形状是错误的,而这里没有任何机制能适应这种情况。要覆盖一系列尺寸,需要一组配置以及在这些配置之间进行选择的方法。
进一步调优 #
整个演进过程在第 5 步固定了 tile 形状,并一直保持到第 8 步,以便后续每项更改都能单独衡量。面向生产的内核会调优这一选择。三个参数相互权衡:
Tile 面积:更宽的 tile 每单位输出读取更少的 A 和 B,但消耗 LDS,而 LDS 决定一个计算单元能容纳多少个 block。
K 深度:更深的切片将屏障开销分摊到更多算术上,但同样消耗 LDS。
Wave 网格:每个 block 更多的 wave 意味着每个 wave 更少的累加器和更少的寄存器,但给每个 wave 更少的算术来隐藏延迟。
第 1 步的资源报告在运行任何内容之前就缩小了搜索范围,排除了无法驻留的组合。
Wave 网格与 WMMA 部分的 fragment 宽度相互作用。在 128×96 且使用 2×2 网格时,每个 wave 持有 4×3 的累加器网格;4×2 网格将其减半为 2×3。在 RDNA 4 上,这释放了足够的寄存器以提高占用率。在 RDNA 3 上,每个累加器的宽度是两倍,同样的更改从更高的寄存器计数开始,无法达到下一个占用率台阶。
结合该报告、用于确认的内核跟踪以及少量计时运行,这里的搜索空间小到可以手动遍历。
在 gfx1201 上扫描这些参数,可以找到比演进过程最终确定的 128×96 表现更好的 tile。在 4×2 wave 网格上使用 192×224 的 tile,在相同 K 深度下采用单缓冲,以 58.5 KB 适应 64 KB 预算,并在两种形状上都优于第 8 步 [ 1 ]:
| 形状 | 第 8 步 128×96 (ms) | 调优后 192×224 (ms) | hipBLASLt (ms) | 调优后 (TFLOPS/s) |
| --- | --- | --- | --- | --- |
| M=N=K=8192 | 8.71 | 7.73 | 8.05 | 142.30 |
| M=8192, N=28672, K=8192 | 29.55 | 26.64 | 28.54 | 144.46 |
表 17. 在 gfx1201 上,调优后的 tile 与第 8 步及 hipBLASLt 的对比。
演进过程保留 128×96,因为它是前面步骤所构建的 tile,也是本文解释其资源权衡的 tile;而更大的 tile 是在掌握这些推理后,按架构扫描所确定的。第 8 步的单缓冲使其得以适应:192×224 的 tile 在四个 K 步下使用两个缓冲区将需要 117 KB,只有使用一个缓冲区才能降到 64 KB 预算以下。
同一个问题,上升一个层次 #
本文中的每一步都选择了一种配置,而其中若干选择在每块 GPU 上得到的结果各不相同。一个库需要在调用者可能请求的每一种形状、数据类型和布局上,在每一个受支持的架构上面对这一问题。
hipBLASLt 针对每种架构在多种尺寸上调优并提供了解决方案,并在运行时从中选择,这也是本文通篇将其作为基线的原因。这些解决方案还可以针对特定尺寸进一步离线调优,并在运行时应用。
离线扫描所搜索的参数,正是上文手工调优的那些参数。以下文章介绍了相关工具:
GEMM Tuning within hipBLASLt - Part 1 和 Part 2,介绍了如何使用 hipblaslt-bench 对问题尺寸进行调优,并在运行时应用结果。
hipBLASLt Online GEMM Tuning,介绍如何在运行中的框架内部进行调优。
总结 #
在本博客中,你为 AMD RDNA 3 和 RDNA 4 GPU 构建了一个 FP16 GEMM 内核,从一个最小的单波 WMMA 内核(第 1 步)开始,并在第 2 步达到一个常规的分块 GEMM。随后你在另外六个步骤中对其进行了改进:通过填充避免 LDS bank 冲突(第 3 步)、使用缓冲区资源描述符实现有界全局加载(第 4 步)、更深的 K 切片(第 5 步)、用于缓存复用的块排序(第 6 步)、与 WMMA 交错的预取(第 7 步),以及重新审视双缓冲以提高占用率(第 8 步)。最终内核在三块 GPU 上均达到与 hipBLASLt 相差几个百分点的水平。
在此过程中,你看到了 WMMA 片段和累加器布局在 RDNA 3 与 RDNA 4 之间有何不同,以及单个策略模板化内核如何同时服务于两者。你还看到,没有哪一种配置能在所有情况下胜出:若干步骤对三块 GPU 的影响程度各不相同,而两个选择(置换与填充,以及一个 LDS 缓冲区与两个)在每个目标上得到的结果也不同。同样的先测量后决策的方法,借助编译器的资源报告和 rocprofv3 内核跟踪,也适用于你自己的内核。
本系列的第 2 部分将从本文结束的地方继续。它将把最终内核移植到 RDNA 4(gfx1201)上的 FP8,并展示更小的元素尺寸如何开启在 FP16 下无法放入 LDS 的更大分块和更深 K 切片,并在取自 transformer 工作负载的 GEMM 形状上进行基准测试。
其他资源 #
AMD ROCm 优化指南,涵盖了本文中使用的内建函数和 GEMM 模式:
AMD ROCm Optimization Guide
Optimizing GEMM in HIP
RDNA3 dense WMMA builtins
RDNA4 dense WMMA builtins
Performance guidelines
RDNA 矩阵指令及其背后的架构:
如何使用 WMMA 在 RDNA 3 上加速 AI 应用
使用 AMD RDNA 4 架构 GPU 的 Matrix Cores
“RDNA 3”指令集架构参考指南
“RDNA 4”指令集架构参考指南
AMD GPU 架构编程文档
关于硬件模型和此处所用标志的 HIP 参考:
HIP 文档
HIP 硬件实现
CU 模式与 WGP 模式
HIP 性能指南
库与性能分析器:
hipBLASLt 文档
使用 rocprofv3 进行应用跟踪与性能分析
在 AMD Instinct™ 硬件上采用相同技术时,寄存器文件、wave 大小和矩阵指令均有所不同,因此数值不可直接套用:
在 AMD CDNA™ 4 架构上进行 FP8 GEMM 优化
使用 CK-Tile 避免 AMD GPU 上的 LDS Bank 冲突
AMD matrix cores
备注 #
系统配置 #
GPU:AMD Radeon™ PRO W7800(gfx1100)、AMD Radeon™ 8060S(gfx1151)、AMD Radeon™ RX 9070 XT(gfx1201)
ROCm 栈:ROCm 10.0
编译器:amdclang++,使用 -O3 -std=c++17 -mcumode
工作负载:FP16 GEMM,FP16 输出与 FP16 累加,A 行主序、B 列主序(TN),在 M=N=K=8192 和 M=8192、N=28672、K=8192 下运行
参考实现:直接调用 hipBLASLt,HIPBLAS_COMPUTE_16F,使用 hipblasLtMatmulAlgoGetHeuristic 返回的解决方案
方法:10 次预热启动,然后取 30 次计时启动的平均值;TFLOPS/s 按 2MNK/t 计算
资源数据:编译时使用 -Rpass-analysis=kernel-resource-usage,并在每个 GPU 上通过 rocprofv3 --kernel-trace 运行确认
免责声明 #
本文档所提供的信息仅供参考,可能包含技术性错误、遗漏和排版错误。本文所含信息可能会发生变化,并可能因多种原因而变得不准确,包括但不限于产品和路线图变更、组件和主板版本变更、新模型和/或产品发布、不同制造商之间的产品差异、软件变更、BIOS 刷新、固件升级等。任何计算机系统都存在无法完全预防或缓解的安全漏洞风险。AMD 无义务更新或以其他方式更正或修订此信息。但是,AMD 保留修订此信息并不时更改其内容的权利,且无义务通知任何人此类修订或更改。此信息按“原样”提供。AMD 不对本文内容作出任何陈述或保证,并且不对本信息中可能出现的任何不准确、错误或遗漏承担任何责任。AMD 明确否认任何关于不侵权、适销性或特定用途适用性的默示保证。在任何情况下,AMD 均不对任何人因使用本文所含任何信息而导致的任何依赖、直接、间接、特殊或其他后果性损害承担责任,即使 AMD 已明确被告知此类损害的可能性。AMD、AMD 箭头标识及其组合是 Advanced Micro Devices, Inc. 的商标。本出版物中使用的其他产品名称仅用于识别目的,可能是其各自公司的商标。© 2026 Advanced Micro Devices, Inc. 保留所有权利
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:AMD ROCm Blog
原创地址:https://rocm.blogs.amd.com/software-tools-optimization/rdna-fp16-gemm/README.html
原文作者:Adel Johar, Jan Stephan, Istvan Kiss;如有侵权,请联系管理员删除。

