使用开源智能体 API 服务器 OGX 构建 AI 应用
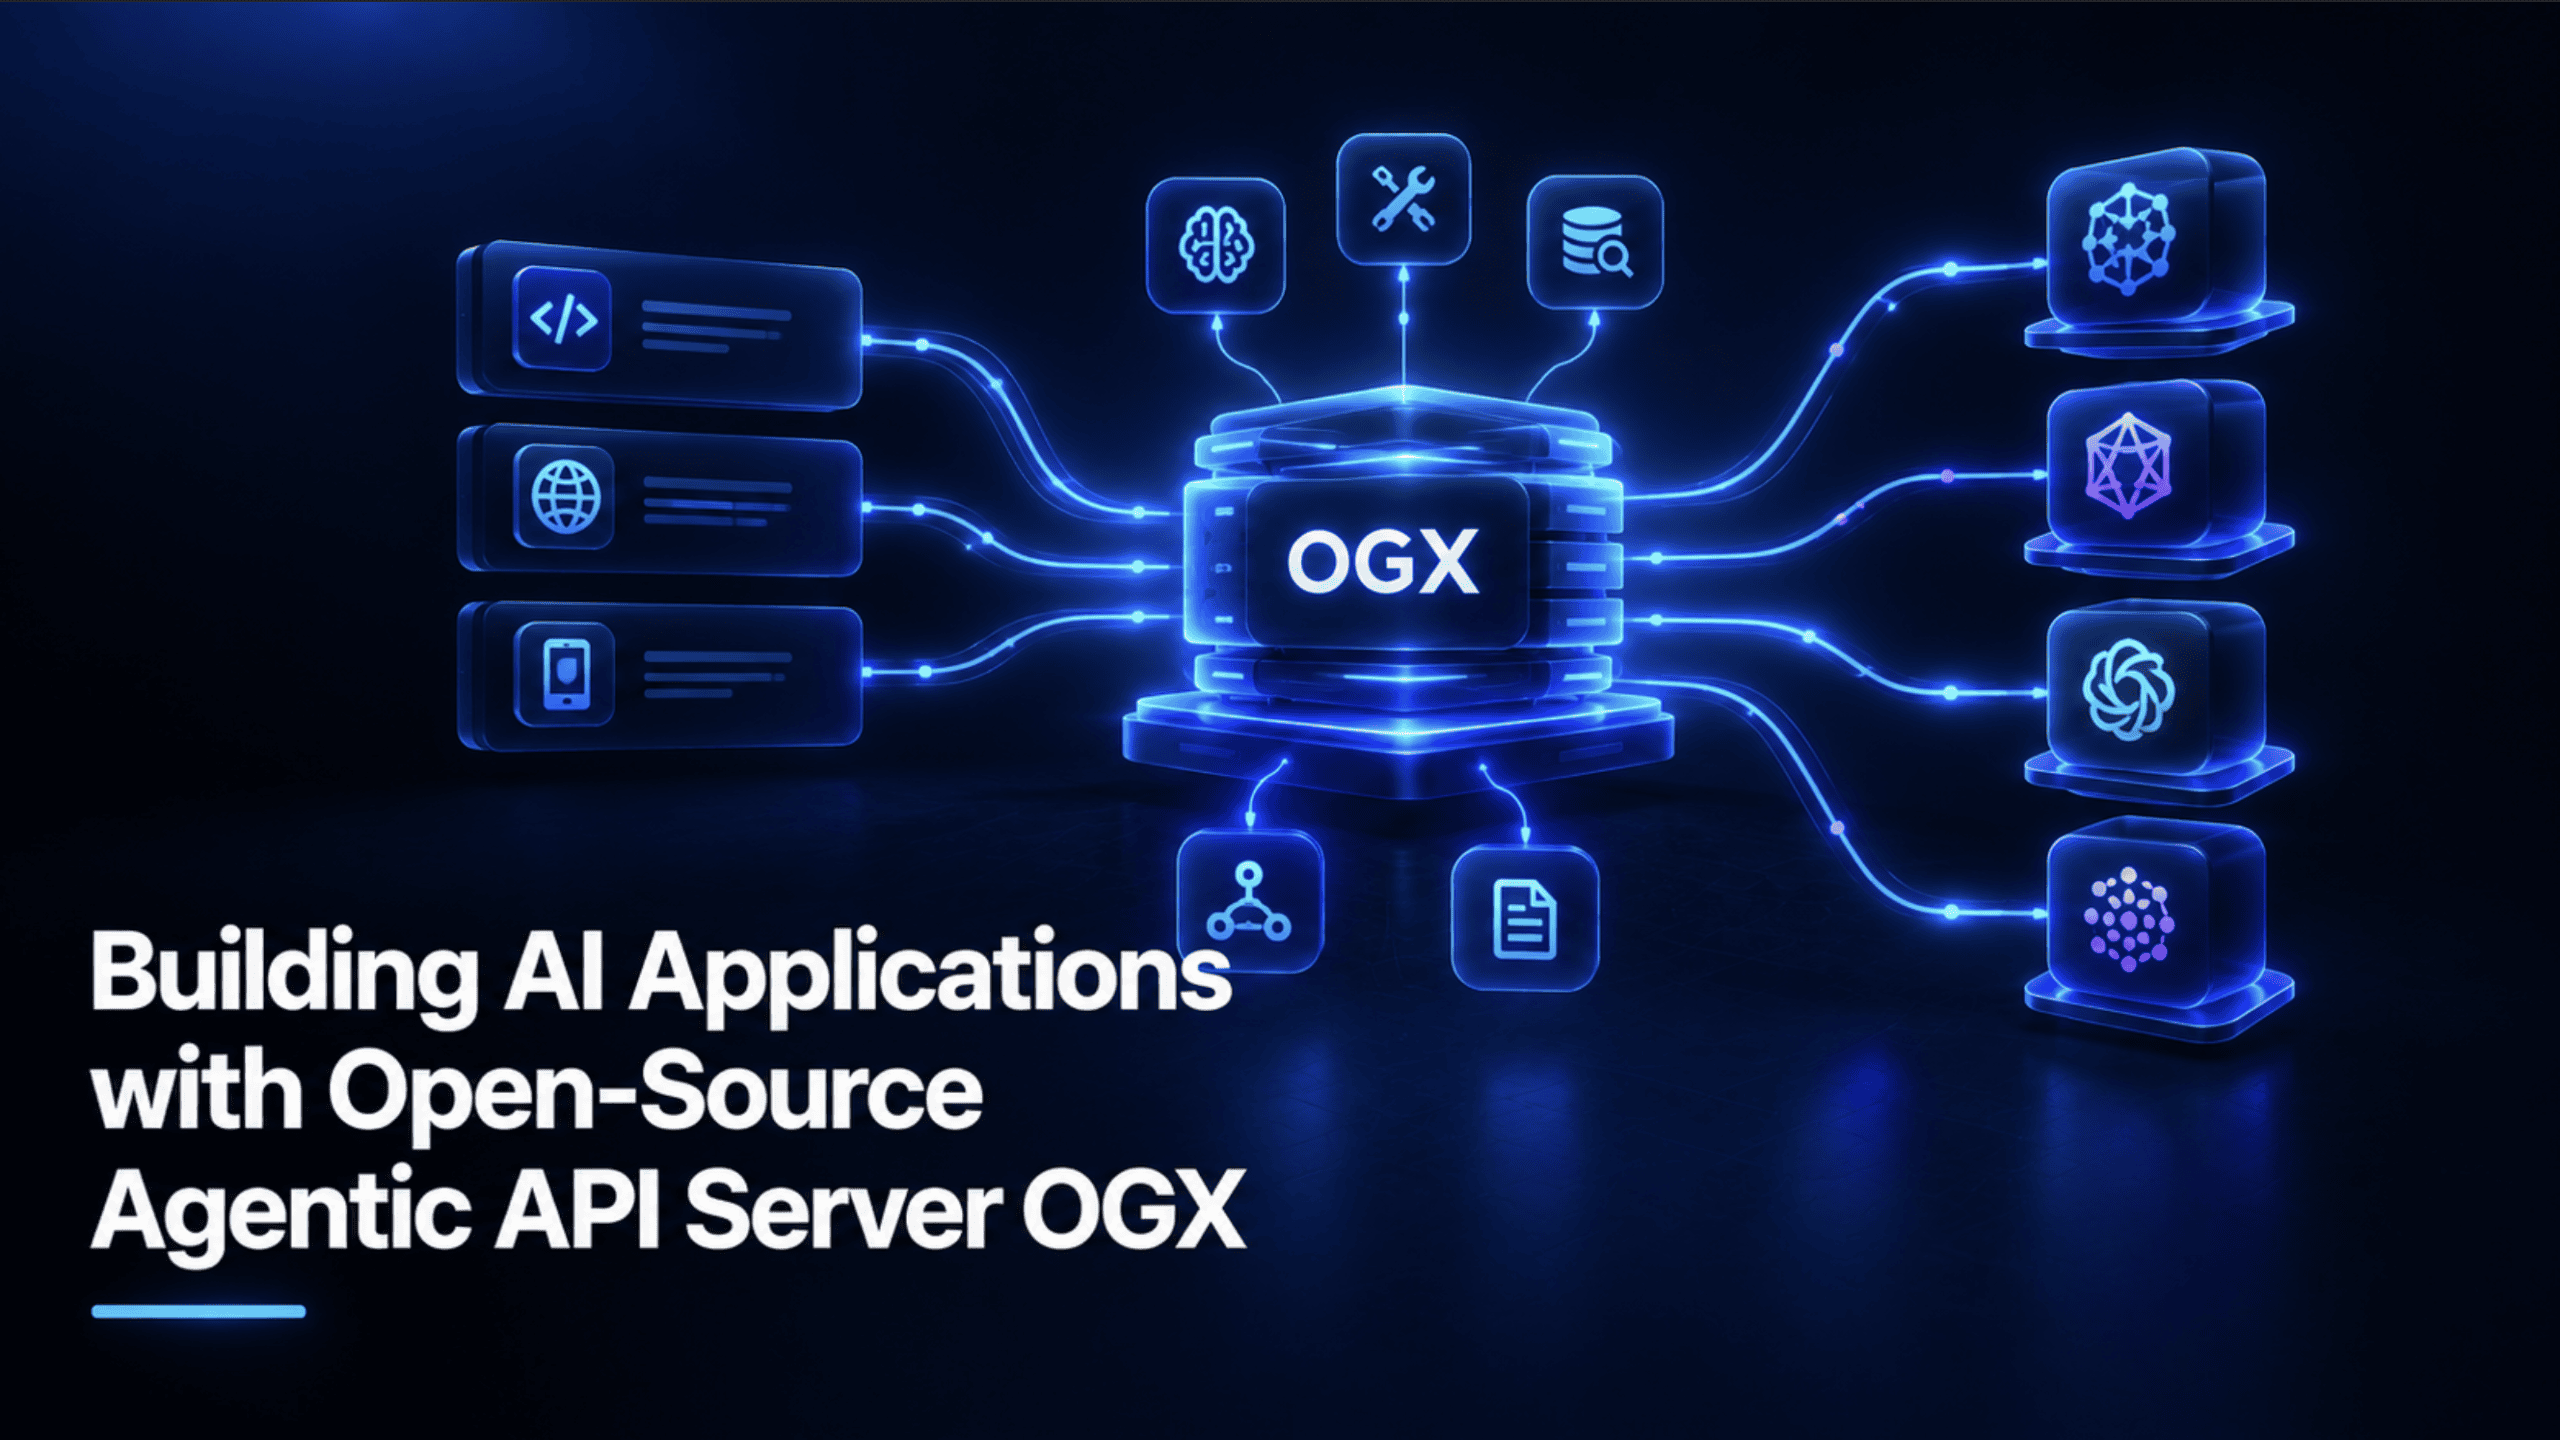
OGX 是一个开源智能体 API 服务器,用于构建与 OpenAI 兼容的 AI 应用,可使用任意模型和任意基础设施。
在讨论这个话题之前,有一个事实值得先了解:OGX 是 Meta 的 Llama Stack 的品牌重塑。其 GitHub 页面直接说明,Llama Stack 现在更名为 OGX,这一更名伴随着使命的真正转变,即转向模型无关、多 SDK(软件开发工具包) 和生产级——而不是一个架构相似得令人困惑的全新无关项目。这一事实为当前研究智能体 API 服务器、OpenAI 兼容 API 或本地 AI 应用开发的人解决了许多困惑,因为关于 Llama Stack 的许多内容在新名称下仍然直接适用于 OGX。
什么是 OGX(以及它为何曾被称为 Llama Stack)
OGX 被直白地描述为:一个用于构建 AI 应用的开源智能体 API 服务器,与 OpenAI 兼容,支持任意模型、任意基础设施。它基于 MIT 许可证发布,是一个真正成熟的项目——截至本文撰写时拥有超过 8,400 个 GitHub 星标和 1,400 个复刻——并定期举行社区会议且保持活跃开发。
其核心卖点是作为 OpenAI API 的直接替代品,你可以自行运行在笔记本电脑、数据中心或云端,并将任何与 OpenAI 兼容的客户端或智能体框架指向它。在这个单一 API 背后是可插拔的提供者架构:使用 Ollama 进行本地开发,使用 vLLM 部署到生产环境,或连接到托管云服务——所有这些都通过完全相同的 API 接口进行,因此之后更换后端并不意味着要重写上层应用。它还不止于聊天补全:Responses API 在单次 API 调用中处理服务器端智能体编排、工具调用、MCP 服务器集成以及用于检索增强生成(RAG(检索增强生成))的内置文件搜索,并且 OGX 原生支持 OpenAI、Anthropic 和 Google GenAI SDK 连接同一服务器,而不仅仅是某一个供应商的客户端库。
在本文中,我们将构建一个应用——我们称之为 DocBrain——它做两件事。第一,真正的 RAG:上传文档,它基于文档的实际内容回答问题,检索自动进行,而不是通过手动接线的向量数据库和单独的检索脚本。第二,真正的智能体能力:在审查你的文档时,它可以调用自定义工具来标记并保存一个真实的行动项——租赁续约截止日期、后续任务——到磁盘上的实际文件中,因此它不只是描述你应该做什么,而是完成记录工作。
前提条件和安装 OGX
你需要 uv(Python 的快速包管理器)和一个本地模型后端。本教程使用 Ollama,不过相同的代码之后无需更改即可用于 vLLM 或云提供商——这正是 OGX 提供者架构的全部意义。
# Install Ollama, then pull a model
ollama pull llama3.2:3b

# Set up a real project (not the throwaway uvx command from a quick trial)
uv init docbrain && cd docbrain
uv add ogx openai
代码解释:uv init 会搭建一个正式的项目,而不是依赖一次性的 uvx 调用,一旦这不再是五分钟的实验而成为你实际持续使用的东西,这一点就很重要。uv add ogx openai 会同时安装 OGX 服务器包和标准 OpenAI Python 客户端,因为该客户端正是 DocBrain 与 OGX 通信所需的全部。
启动服务器并验证其正常工作
uv run ogx go
在 Ollama 运行且模型已拉取的情况下,这会启动位于 https://localhost:8321 的 OGX 服务器。在编写任何应用程序代码之前,请确认它确实健康运行:
curl -k -s https://localhost:8321/v1/models | python -m json.tool
代码解释:OGX 默认监听 HTTPS,并且开箱即用、安全可靠,因此本地测试需要使用 -k 标志来跳过对其自签名本地证书的证书验证。健康的响应会在 /v1/models 下列出你注册的模型,确认服务器已启动且 Ollama 已正确连接——而这一切都发生在你编写实际应用程序的第一行代码之前。
通过 Responses API 进行基础聊天
最小的真实调用,确立了本教程后续所有内容所基于的模式:
import httpx
from openai import OpenAI

client = OpenAI(
    base_url="https://localhost:8321/v1",
    api_key="fake",
    http_client=httpx.Client(verify=False),
)

response = client.responses.create(
    model="ollama/llama3.2:3b",
    input="What is OGX?",
)
print(response.output_text)
代码解释:api_key="fake" 并不是一个需要你填写的占位符——对于本地服务器,OGX 根本不检查它,任何字符串都可以。http_client=httpx.Client(verify=False) 是上一步中 curl 的 -k 标志的 Python 等价物,用于在本地开发中跳过证书验证。模型字符串遵循 provider/model-name 格式——ollama/llama3.2:3b——OGX 正是通过它知道应将请求路由到其配置的哪个提供方。response.output_text 是 Responses API 用于获取最终文本答案的便捷属性,无需手动解析 choices 数组。
添加真正的 RAG:上传文档并创建向量存储
这正是 OGX 内置检索真正展现的地方,而且它确实非常紧凑:
# Upload a document
file = client.files.create(
    file=open("lease_agreement.pdf", "rb"),
    purpose="assistants",
)

# Create a vector store and index the file
vector_store = client.vector_stores.create(
    name="docbrain-kb",
    file_ids=[file.id],
)

# Ask questions with file search
response = client.responses.create(
    model="ollama/llama3.2:3b",
    input="Summarize the key points",
    tools=[{
        "type": "file_search",
        "vector_store_ids": [vector_store.id],
    }],
)
print(response.output_text)
代码解释:client.files.create 上传原始文档;purpose="assistants" 将其标记为可供检索的内容,而不是例如微调数据集。client.vector_stores.create 是真正完成大部分 RAG 教程需要手动编写数十行代码的工作的步骤——对文档进行分块、对这些块进行嵌入,并将它们索引到可搜索的存储中——所有这些都由 OGX 在服务器端处理。responses.create 调用中的 tools 列表是为这个特定问题激活检索的关键:file_search 结合向量存储的 ID 告诉 OGX 在该存储中搜索相关内容,并在生成响应之前自动将模型的答案建立在搜索结果之上。
添加自定义工具:标记并保存行动项
这是 DocBrain 真正具有智能体特性的那一半——一个模型可以选择调用的真实 Python 函数。
# tools/action_items.py
import json
import os
from datetime import datetime, timezone

ACTION_ITEMS_FILE = "action_items.jsonl"

def save_action_item(description: str, source_document: str, priority: str = "medium") -> dict:
    """Appends one action item as a JSON line to a local file."""
    if not description.strip():
        raise ValueError("description cannot be empty")
    if priority not in ("low", "medium", "high"):
        raise ValueError(f"priority must be low, medium, or high, got '{priority}'")

    entry = {
        "description": description.strip(),
        "source_document": source_document.strip(),
        "priority": priority,
        "flagged_at": datetime.now(timezone.utc).isoformat(),
    }
    with open(ACTION_ITEMS_FILE, "a") as f:
        f.write(json.dumps(entry) + "\n")
    return {"status": "saved", "entry": entry}


def list_action_items() -> list[dict]:
    """Reads back every saved action item, an empty list if none exist yet."""
    if not os.path.exists(ACTION_ITEMS_FILE):
        return []
    with open(ACTION_ITEMS_FILE) as f:
        return [json.loads(line) for line in f if line.strip()]


ACTION_ITEM_TOOL_SCHEMA = {
    "type": "function",
    "name": "save_action_item",
    "description": (
        "Save a genuine, concrete action item found while reviewing a document. "
        "Only call this for real, actionable tasks, not general summary points."
    ),
    "parameters": {
        "type": "object",
        "properties": {
            "description": {"type": "string", "description": "The concrete action item, in one sentence"},
            "source_document": {"type": "string", "description": "Which uploaded document this came from"},
            "priority": {"type": "string", "enum": ["low", "medium", "high"]},
        },
        "required": ["description", "source_document"],
    },
}
代码解释:save_action_item 在写入任何内容之前会验证自己的输入——空的描述或无效的优先级值会立即抛出异常,而不是静默损坏已保存的文件。将条目存储为 JSON Lines(每行一个 JSON 对象,追加写入)而不是一个大的 JSON 数组,是一个深思熟虑的实用选择:追加一行很简单且安全,即使进程在写入中途被中断也是如此;而正确地向 JSON 数组追加则每次都需要读取、修改并重写整个文件。ACTION_ITEM_TOOL_SCHEMA 是模型实际看到的对该函数的描述——一个紧凑、具体的描述(“仅对真实、可操作的任务调用此工具”)在这里很重要,因为模糊的工具描述往往会在并非真正可操作的事情上被过度触发。
整合起来:完整的助手
# docbrain.py
import httpx
import json
from openai import OpenAI
from tools.action_items import save_action_item, ACTION_ITEM_TOOL_SCHEMA

client = OpenAI(
    base_url="https://localhost:8321/v1",
    api_key="fake",
    http_client=httpx.Client(verify=False),
)
MODEL = "ollama/llama3.2:3b"


def setup_knowledge_base(file_paths: list[str]) -> str:
    file_ids = []
    for path in file_paths:
        uploaded = client.files.create(file=open(path, "rb"), purpose="assistants")
        file_ids.append(uploaded.id)
    vector_store = client.vector_stores.create(name="docbrain-kb", file_ids=file_ids)
    return vector_store.id


def ask(question: str, vector_store_id: str) -> str:
    response = client.responses.create(
        model=MODEL,
        input=question,
        tools=[
            {"type": "file_search", "vector_store_ids": [vector_store_id]},
            ACTION_ITEM_TOOL_SCHEMA,
        ],
    )
    for item in response.output:
        if getattr(item, "type", None) == "function_call" and item.name == "save_action_item":
            args = json.loads(item.arguments)
            save_action_item(**args)
    return response.output_text


if __name__ == "__main__":
    vector_store_id = setup_knowledge_base(["lease_agreement.pdf", "vendor_contract.pdf"])
    answer = ask(
        "Summarize the key terms of these documents, and flag anything "
        "that needs action before a deadline.",
        vector_store_id,
    )
    print(answer)
代码解释:两个工具——file_search 和自定义的 save_action_item schema——都位于同一次 API 调用的同一个 tools 列表中,这正是 Responses API 设计的核心要点:检索和自定义工具调用并非两个拼接在一起的独立系统,而是模型可以一起推理的同一个列表中的两个条目。对 response.output 的循环让该工具真正具备功能性而非装饰性:它会检查模型生成的每一项,任何匹配 save_action_item 的 function_call 都会被解析参数并实际执行,向磁盘上的 action_items.jsonl 写入一行真实记录。
运行完整项目
在 Ollama 运行并拉取模型后,启动服务器,然后针对你自己的文档运行助手:
uv run ogx go          # in one terminal
uv run python docbrain.py    # in another, once the server is healthy
将 lease_agreement.pdf 和 vendor_contract.pdf 替换为你自己的文件。问它一些真实的问题。如果它在回答时发现了真正的截止日期或任务,之后检查 action_items.jsonl——那里会有一条真实保存的记录,而不只是终端里滚过去的文本。
总结
OGX 的卖点值得认真对待的真正原因,并不是本教程中的任何单一功能——而是之后会发生什么。我们在这里构建的应用完全运行在本地 Ollama 模型上,零成本。当你需要生产级可靠性时,迁移到 vLLM 或托管提供商意味着只需更改模型字符串和提供商配置,而不是重写应用。向量存储逻辑、工具、调度循环——所有这些都保持原样。
这就是 API 封装与真正的智能体平台之间的真正区别,也是为什么这个项目值得在其上继续构建,而不是在它需要成长的那一刻就将其丢弃。
Shittu Olumide 是一名软件工程师和技术写作者,热衷于利用前沿技术打造引人入胜的叙事,注重细节,擅长简化复杂概念。你也可以在 Twitter 上找到 Shittu。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原创地址:https://www.kdnuggets.com/building-ai-applications-with-open-source-agentic-api-server-ogx
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

