由 Lyft 的 Rohit Channe 和 Simran Mirchandani 撰写。
动机
在 Lyft,数据不仅仅是一种资源——它融入我们所做的一切。指标驱动关键预测、指导运营决策,并检验我们最大胆的假设。但随着 Lyft 规模扩大、产品发布与演进、团队成员更替,我们发现不同团队可能对同一指标使用不同定义,这带来了风险。“指标 ABC”到底是什么意思?答案往往取决于你问的是哪个团队以及其具体场景和应用。
后果是可以预见的。没有集中式版本控制或共享标准,过时的指标定义就会悄然渗入决策过程。
我们的解决方案是构建内部指标语义层(Metric Semantic Layer,MSL):一个集中式仓库,作为每个指标定义的唯一权威来源——既提供清晰的自然语言描述,也提供最终确定的 SQL 代码。无需再在代码库中四处搜寻或依赖口口相传——只需一个地方来存储和访问标准化、达成一致的定义。借助 MSL,我们拥有单一事实来源——跨每个团队的一致术语和假设,因此每个人都能真正使用同一种语言。我们通过三个关键原则实现这一点:
简化入门和变更管理——一次更新指标定义,变更会自动且无摩擦地流经所有依赖它的下游应用
有意识的治理——明确所有权、定义范围、清晰的数据质量责任,以及足够稳健、能够经受组织变化、团队轮换和人员流失的结构
透明性和可访问性——定义易于技术和非技术用户(以及下游应用)查找并集成到日常工作流中
解决方案
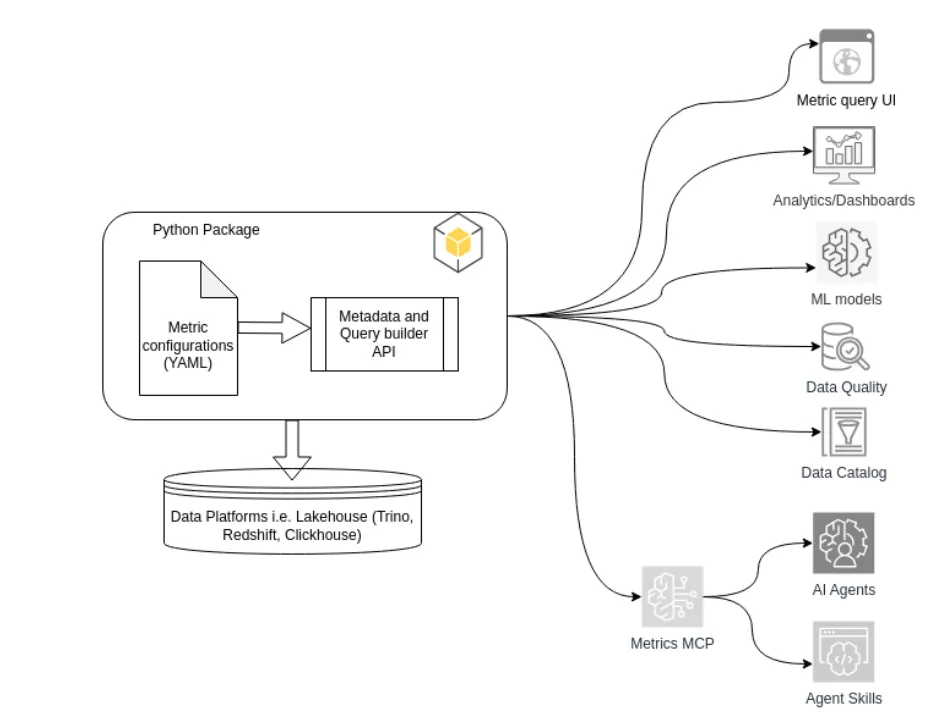
考虑到上述原则,我们将指标语义层实现为一个 Python 包:
1 — 通过灵活的指标配置简化入门和变更管理
为了将业务逻辑和指标定义以及支持的元数据属性编码化,我们使用了 YAML 配置。YAML 表示方式既提供了指标定义的灵活性,也提供了可读性。核心定义存储在 SQL jinja 模板中,这让我们可以根据时间粒度和维度定制最终 SQL。选择 Jinja 模板是为了确保 SQL 块不会在多个定义中重复声明(DRY 方法论),并且与其他一些模板框架相比学习曲线更低。
YAML example
operational_owner: rides_table_owners
data_sources:
- rides_table
view: |
SELECT DATE_TRUNC('{{time_granularity}}',{{time_attribute}}) AS {{time_granularity}},
{{select_dimensions(dimensions)}},
{{select_metrics(metrics, include_ratio_parts)}}
FROM rides_table
WHERE {{time_attribute}} BETWEEN DATE('{{start_date}}') AND DATE('{{end_date}}')
{% macro groupby_dimensions %}
time_attribute: ds
time_granularity:
- day
- week
- month
dimensions:
- dimension_name: region
dimension_expression: ride_region
dimension_definition: Ride region
metric:
- metric_name: rides_completed
metric_description: Rides with drop off completed
metric_type: Additive
business_owner: rides_owner
aggregated_expression: 1.0*count_if(is_dropped_off)
2 — 有意识的治理以支持规模化
为了让该包长期持续有效,我们必须围绕持续治理定义结构。我们通过两种主要机制做到了这一点:
选择标准:哪些指标(以及相关时,哪些维度)值得被纳入该包?
所有权模型:我们如何确保指标保持最新?谁负责维护定义?
并非所有指标都是平等的。有些指标是某个团队独有的,而另一些则受到全公司人员的关注。后一类被视为“黄金指标”。这些指标至少有两个不同的用例或应用场景。这些指标才被允许纳入该包;任何过于小众的指标带来的开销都超过其价值。例如,Rides Completed 既通过关键仪表板被主动监控,也被用于运营 ML 模型。
所有黄金指标都必须有一个业务负责人和一个运营负责人。负责人绝不应是个人——而应是一个团队——以便尽可能具备韧性。
业务负责人:他们负责指标健康。
谁?——一位对业务、市场状况和正常波动水平有深入理解的数据分析师或数据科学家。
做什么?——提供指标的(书面和技术 SQL)定义。——通过验证现有定义或按定期、预定义的节奏更新定义,在包中维护该定义。——定义指标的局限性和可扩展性(例如允许的维度和时间粒度)。获得利益相关者的批准。
运营负责人:他们负责数据健康。
谁?——一位具有创建/支持 ETL 管道经验的数据工程师或数据科学家。
做什么?——通过提供 on-call 支持、创建和维护数据质量(DQ)检查,以及在需要时运行回填来修复问题,确保所使用底层数据表的质量。——沟通指标生产中的延迟或问题、底层假设/逻辑的变更,以及因回填导致的数据变更。
对指标定义的任何更改都必须得到业务负责人和运营负责人的共同批准。这一要求有两个关键目的:
知情且协调的行动:它确保所有相关方都知晓该变更,并能够做出必要的、反应性的调整。例如,在业务定义更新后,运营负责人可能需要建立新的 DQ 检查,以维持对指标的信任。
问责制和质量控制:这种共同责任利用了各方不同的知识。一位负责人可能意识到另一位负责人未意识到的关键细微差别,从而防止采用次优的变更。
3 — 通过访问方法和 API 实现透明度
这些配置现在通过基于 Python 的方法和 API 暴露。该模块帮助用户探索定义了哪些指标、获取其元数据,并且最重要的是,获取或执行 SQL 定义。这也可作为与分析仪表板、数据质量工具、数据编排(Airflow)、ML 模型/工作流以及 AI 代理/工具集成的接口。该 Python 包已进行版本控制,更新会通过自动化代码重构定期部署到所有依赖应用程序,以便它们接收最新更新。
### Input
from metrics_source import get_sql
print(get_sql(metric_group_name='rides',
start_date='2025-04-01',
end_date='2025-05-01',
dimension_names=['region'],
metric_names=['rides_completed'],
time_granularity='week',))
### Output
SELECT DATE_TRUNC('week',ds) as week,
ride_region as region,
1.0*count_if(is_dropped_off) as rides_completed
FROM rides_table
WHERE ds BETWEEN DATE('2025-04-01') and DATE('2025-05-01')
GROUP BY 1,2
访问标准化指标
我们让用户无需直接使用 Python 访问函数即可访问 MSL 的一些方式。
Amundsen:可发现性
对于希望发现、探索和访问指标定义的用户,我们与内部数据目录工具 Amundsen 进行了集成。这帮助他们搜索、导航和访问指标定义,同时还能展示归属关系和数据质量信息。
自助式工具
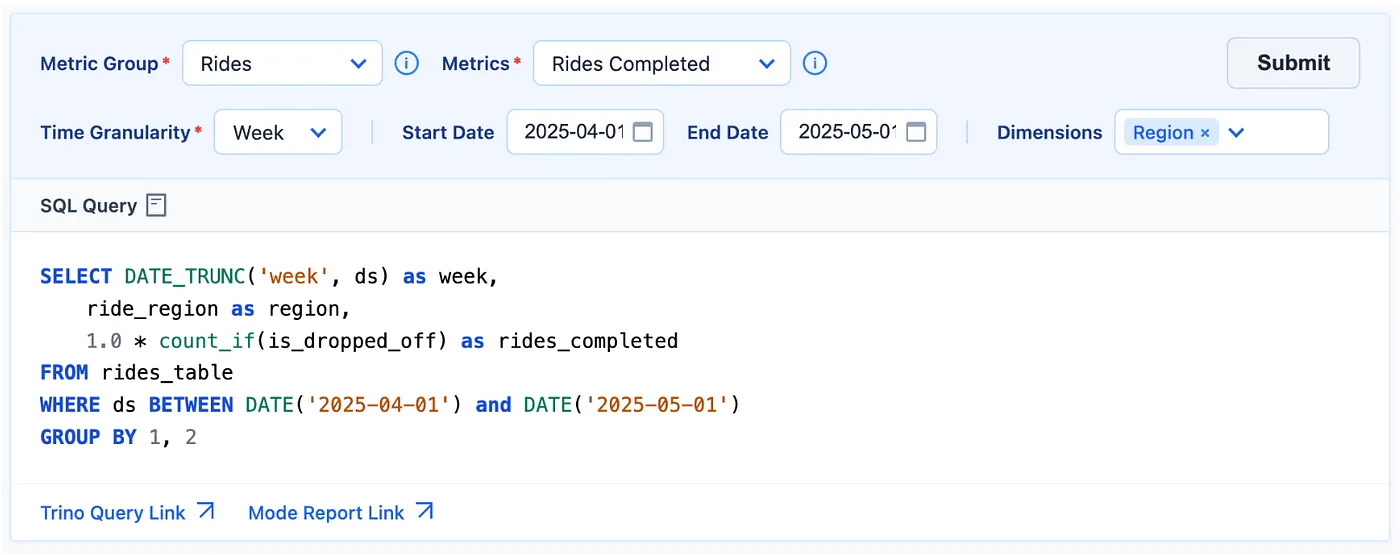
对于希望在不编写任何代码的情况下生成和执行自定义指标 SQL 的用户,我们推出了自助式 Metric UI。该工具允许用户选择必要的维度和时间粒度,以生成针对其特定用例的 SQL,同时保留核心指标定义构造和谓词。
AI MCP/Skills
将我们的指标定义组织为干净、可访问的 YAML 文件——使其完全对代码友好——所带来的最大、或许也是最出人意料的好处之一是,这种配置可以作为 AI Agents 和 Skills 的全面知识库。
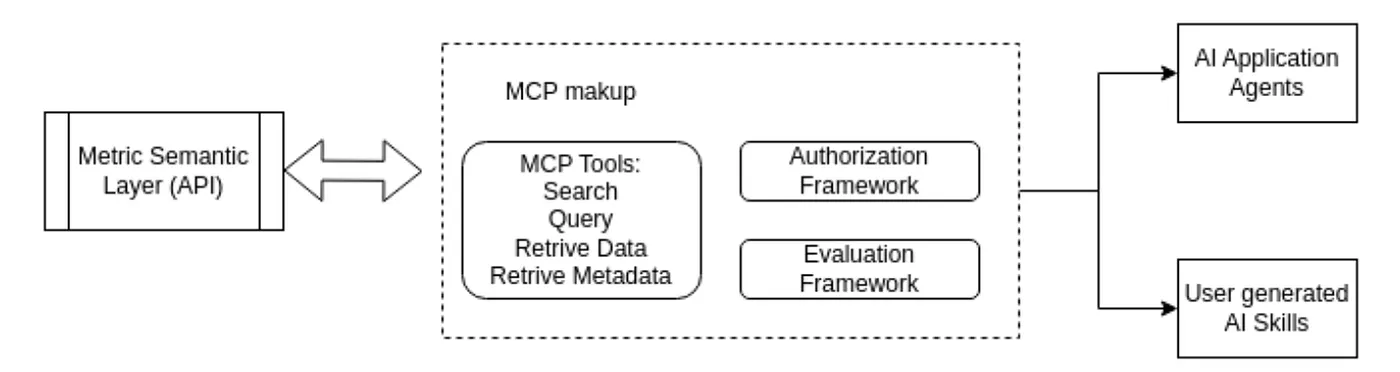
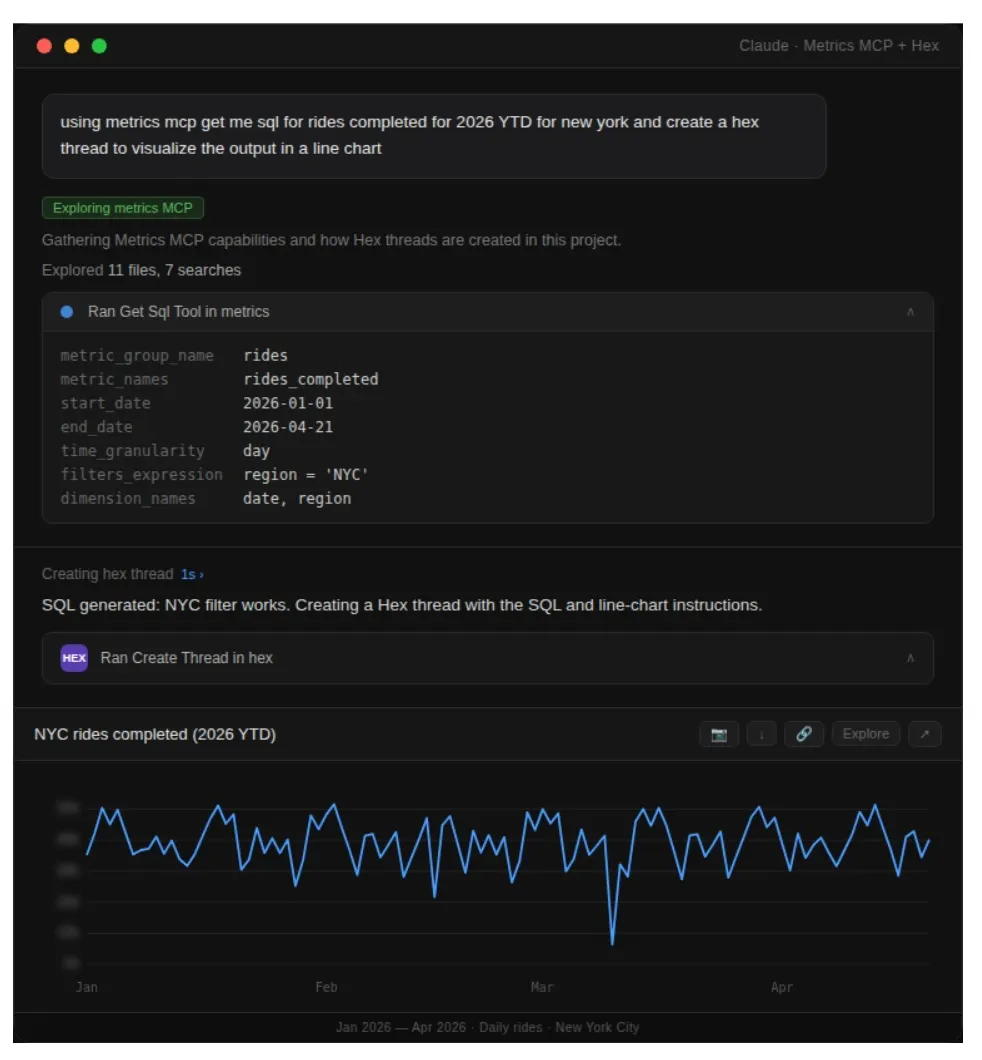
我们创建了一个 MCP(Model Context Protocol),其中包含用于访问 MSL 库的工具,让用户可以就指标提出自然语言问题,并获得更高的准确性和更少的幻觉。用户可以在 Claude 和 Cursor 中,将 MCP 与其本地或远程工作流中的 Skills 和 Custom AI Agents 集成。它也能很好地与 Hex 等流行 BI 工具集成,使这些 BI 工具生成的 AI 输出更加可靠。
最后,我们还内置了护栏,用于通过 ground truth 和 LLM as a judge 等评估技术来评估 MCP 的结果。
后续步骤
自研解决方案 MSL 为确保关键业务应用与最新指标定义保持一致奠定了良好的基础。除此之外,它还为指标变更管理带来了严谨性。然而,随着我们扩大范围并寻求与其他第三方应用(BI 工具和数据库)集成,我们正在探索供应商托管解决方案的选项。这将自然地把 Metric Semantic Layer 扩展到 AI 驱动的分析。指标配置和可访问性工具的确定性结构与构造,为我们在 Lyft 构建的 AI 辅助业务洞察提供了基线上下文和知识库——后续博客文章中会有更多相关内容!
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文作者:Iraklikhorguani;如有侵权,请联系管理员删除。

