在 Kaggle 数据科学竞赛中使用集成方法——第 3 部分
之前,我们展示了如何使用堆叠泛化和折外预测创建堆叠集成。现在我们将学习如何实现各种堆叠技术。

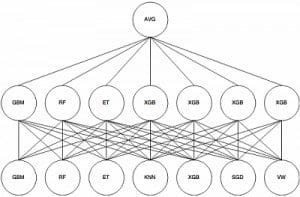
网络模型的反向传播
在多分类问题上使用原始特征进行非线性堆叠会带来惊人的收益。
非线性算法能够发现原始特征与元模型特征之间的有用交互。
首先使用分箱,将回归问题转化为多分类问题。
这些类别的预测概率可以帮助堆叠回归器做出更好的预测。
将数据集降至 2 或 3 维。
将其与非线性堆叠器进行堆叠。
使用留出集进行堆叠/混合(安全选择)。
因此,当数据集具有时间效应时,你可以使用 Vowpal Wabbit 在整个数据集上进行训练。
将其与更复杂、更强大的工具(如 XGBoost)结合,在最后一天的数据上进行训练。
最后将 XGBoost 的预测与样本一起堆叠,让 Vowpal Wabbit 发挥其最擅长的能力——优化损失函数。
不对数据进行缩放
对数据进行标准缩放
对数据进行最小-最大缩放
对手动挑选的表现良好的集成使用平均、投票或排名平均。
从约 3 个优秀模型的基础集成开始。当某个模型能最大程度提升训练集得分时,将其加入。通过允许模型放回,单个模型可能被多次选中(加权)。
使用遗传算法(来自遗传模型选择)和 CV 分数作为适应度函数。
作者使用完全随机的方法:从随机选择的集成中创建约 100 个集成(不放回)。然后选择得分最高的模型。
可视化为网络的模型可以使用反向传播进行训练
考虑 CV 分数及其标准差(越小越好)。
在优化复杂度/内存使用和运行时间方面仍有空间。
还可以考虑在创建集成时让脚本偏好不相关的模型预测。
考虑并行化和分布式自动化以提高速度。
对于基础模型,使用纯随机参数生成随机算法并进行训练。
可以编写包装器,使 VW、Sofia-ML、RGF、MLP 和 XGBoost 等分类器与 Scikit-learn API(应用程序编程接口) 良好配合。
对于堆叠器,让脚本使用 SVM、随机森林、极端随机树、GBM 和 XGBoost,并配以随机参数和基础模型的随机子集。
最后,当创建的堆叠器在训练集上的折预测产生更低损失时,对它们进行平均。
你可以赢得 Kaggle 竞赛。
你可以用单一方法击败大多数最先进的学术基准。
可以将集成模型的知识迁移回更简单的浅层模型(Hinton 的 Dark Knowledge,Caruana 的 Model Compression)
集成的一个好处是,单个模型的损失不会对生成良好预测造成致命影响。
自动化大型集成不需要太多调参或选择。
准确率提高 1% 可能使一只投资基金从亏损转为减少一点亏损。更严肃地说:改进医疗筛查方法有助于拯救生命。
身份欺诈与分析——概述
云机器学习之战:Amazon vs IBM Watson vs Microsoft Azure
测试预测模型准确性的 3 种方法
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原创地址:https://www.kdnuggets.com/2015/06/ensembles-kaggle-data-science-competition-p3.html#comment-184732
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

