面向初学者的十大机器学习算法
面向初学者的十大机器学习(ML)算法介绍,配有图表和示例,便于理解。
I. 引言
在《哈佛商业评论》将“数据科学家”称为“21世纪最性感职业”的文章发表后,ML 算法的研究获得了巨大的关注。因此,对于那些刚进入 ML 领域的人来说,我们决定重启我们极受欢迎的金牌博客《机器学习工程师需要知道的10种算法》——尽管这篇文章是针对初学者的。
ML 算法是那些能够从数据中学习并从经验中改进,而无需人工干预的算法。学习任务可能包括学习将输入映射到输出的函数、学习未标记数据中的隐藏结构;或“基于实例的学习”,即通过将新实例(行)与存储在内存中的训练数据实例进行比较,为新实例生成类别标签。“基于实例的学习”不会从具体实例中创建抽象。
II. ML 算法的类型
ML 算法有3种类型:
1. 监督学习:
监督学习可以解释如下:使用带标签的训练数据来学习从输入变量(X)到输出变量(Y)的映射函数。
监督学习问题可以有两种类型:
a. 分类:预测给定样本的结果,其中输出变量为类别形式。示例包括男性和女性、生病和健康等标签。
b. 回归:预测给定样本的结果,其中输出变量为实数值形式。示例包括表示降雨量、身高的实值标签。
我们在本博客中介绍的前5种算法——线性回归、逻辑回归、CART、朴素贝叶斯、KNN——都是监督学习的示例。
集成学习是一种监督学习。它意味着结合多个不同的弱机器学习模型的预测来对新样本进行预测。我们介绍的第9-10种算法——随机森林的Bagging、XGBoost的Boosting——都是集成技术的示例。
2. 无监督学习:
无监督学习问题仅具有输入变量(X),但没有相应的输出变量。它使用未标记的训练数据来建模数据的底层结构。
无监督学习问题可以分为两种类型:
a. 关联:发现集合中项目共现的概率。它广泛用于购物篮分析。示例:如果顾客购买了面包,他有80%的可能性也会购买鸡蛋。
b. 聚类:将样本分组,使得同一聚类内的对象彼此之间比与其他聚类中的对象更相似。
c. 降维:顾名思义,降维意味着减少数据集的变量数量,同时确保重要信息仍然被传达。降维可以使用特征提取方法和特征选择方法来完成。特征选择选择原始变量的子集。特征提取执行从高维空间到低维空间的数据变换。示例:PCA算法是一种特征提取方法。
我们在此介绍的第6-8种算法——Apriori、K-means、PCA——都是无监督学习的示例。
3. 强化学习:
强化学习是一种机器学习算法,它允许智能体基于其当前状态决定最佳的下一个动作,通过学习能够最大化奖励的行为来实现。
强化算法通常通过试错来学习最优动作。它们通常用于机器人领域——机器人可以通过在撞到障碍物后收到负面反馈来学习避免碰撞,以及视频游戏中——通过试错可以发现能够大幅提升玩家奖励的特定动作。智能体随后可以利用这些奖励来理解游戏的最优状态并选择下一个动作。
III. 量化机器学习算法的流行度
诸如此类的综述论文已经量化了10种最流行的数据挖掘算法。然而,这类列表是主观的,并且如所引用论文的情况一样,被调查参与者的样本量非常狭窄,且由数据挖掘的高级从业者组成。被调查的人员包括ACM KDD创新奖获得者、IEEE ICDM研究贡献奖获得者;KDD-06、ICDM'06和SDM'06的程序委员会成员;以及ICDM'06的145名参会者。
本博客中的十大算法面向初学者,主要是我在孟买大学计算机工程学士学位期间从“数据仓库与挖掘”(DWM)课程中学到的算法。DWM课程是对机器学习算法领域的绝佳入门。我特别根据在Kaggle竞赛中获胜的普遍性,加入了最后2种算法(集成方法)。希望你喜欢这篇文章!
IV. 监督学习算法
1. 线性回归
在机器学习中,我们有一组输入变量(x),用于确定输出变量(y)。输入变量与输出变量之间存在某种关系。机器学习的目标是量化这种关系。
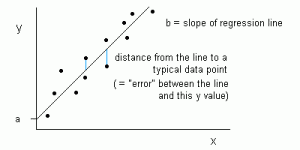
图1展示了某个数据集中x和y值的散点图。目标是拟合一条最接近大多数点的直线。这将减少数据点的y值与直线之间的距离(“误差”)。
2. 逻辑回归
线性回归的预测是连续值(以厘米为单位的降雨量),而逻辑回归在应用变换函数后,其预测是离散值(学生是否通过/未通过)。
逻辑回归最适合二分类(即y = 0或1的数据集,其中1表示默认类别。例如:在预测某事件是否会发生时,事件发生被归类为1。在预测某人是否会生病时,生病的实例被标记为1)。它以其所使用的变换函数命名,该函数称为逻辑函数h(x)= 1/ (1 + e^x),呈S形曲线。
在逻辑回归中,输出以默认类别的概率形式呈现(不同于线性回归直接产生输出)。由于它是概率,输出范围在0-1之间。输出(y值)是通过使用逻辑函数h(x)= 1/ (1 + e^ -x)对x值进行对数变换而生成的。然后应用一个阈值,将这个概率强制转换为二分类。
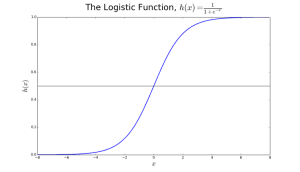
逻辑回归方程 P(x) = e ^ (b0 +b1*x) / (1 + e^(b0 + b1*x)) 可以转换为 ln(p(x) / 1-p(x)) = b0 + b1*x 。
逻辑回归的目标是使用训练数据来找到系数 b0 和 b1 的值,使其能够最小化预测结果与实际结果之间的误差。这些系数通过最大似然估计技术进行估计。
分类与回归树(CART)是决策树的一种实现,其他实现还包括 ID3、C4.5 等。
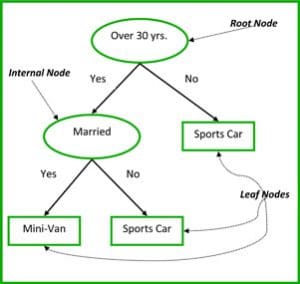
非终端节点包括根节点和内部节点。终端节点是叶节点。每个非终端节点代表一个输入变量(x)以及该变量上的一个分裂点;叶节点代表输出变量(y)。该模型按如下方式用于预测:沿着树的分裂路径走到叶节点,并输出叶节点处的值。
图3中的决策树根据年龄和婚姻状况来分类一个人会购买跑车还是小型货车。如果此人超过30岁且未婚,我们按如下方式遍历树:'超过30岁?' -> 是 -> '已婚?' -> 否。因此,模型输出跑车。
为了计算在另一个事件已经发生的情况下,某一事件发生的概率,我们使用贝叶斯定理。为了计算在某个变量的值已知的情况下某一结果的概率,即在给定先验知识(d)的情况下,计算假设(h)为真的概率,我们使用贝叶斯定理如下:
P(h|d)= (P(d|h) * P(h)) / P(d)
P(h|d) = 后验概率。在给定数据 d 的情况下,假设 h 为真的概率,其中 P(h|d)= P(d1| h)* P(d2| h)*....*P(dn| h)* P(d)
P(d|h) = 似然。在假设 h 为真的情况下,数据 d 的概率。
P(h) = 类先验概率。假设 h 为真的概率(与数据无关)
P(d) = 预测变量先验概率。数据的概率(与假设无关)
该算法被称为“朴素”是因为它假设所有变量彼此独立,这在现实世界的例子中是一个朴素的假设。
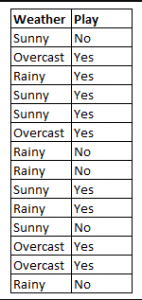
为了在变量 weather='sunny' 的值已知的情况下确定结果 play= 'yes' 或 'no',计算 P(yes|sunny) 和 P(no|sunny),并选择概率更高的结果。
->P(yes|sunny)= (P(sunny|yes) * P(yes)) / P(sunny)
= (3/9 * 9/14 ) / (5/14)
-> P(no|sunny)= (P(sunny|no) * P(no)) / P(sunny)
= (2/5 * 5/14 ) / (5/14)
因此,如果天气='sunny',则结果为 play='yes'。
k-近邻算法将整个数据集用作训练集,而不是将数据集拆分为训练集和测试集。
当需要为新数据实例给出结果时,KNN 算法会遍历整个数据集,以找到与新实例最接近的 k 个实例,即与新记录最相似的 k 个实例,然后输出结果的平均值(用于回归问题)或众数(出现最频繁的类别,用于分类问题)。k 的值由用户指定。
实例之间的相似度使用欧几里得距离和汉明距离等度量来计算。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原创地址:https://www.kdnuggets.com/2017/10/top-10-machine-learning-algorithms-beginners.html#comment-184733
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

