在 NumPy 中从零复现 Anthropic 的《Toy Models of Superposition》,手推梯度,不借用任何现成数值。
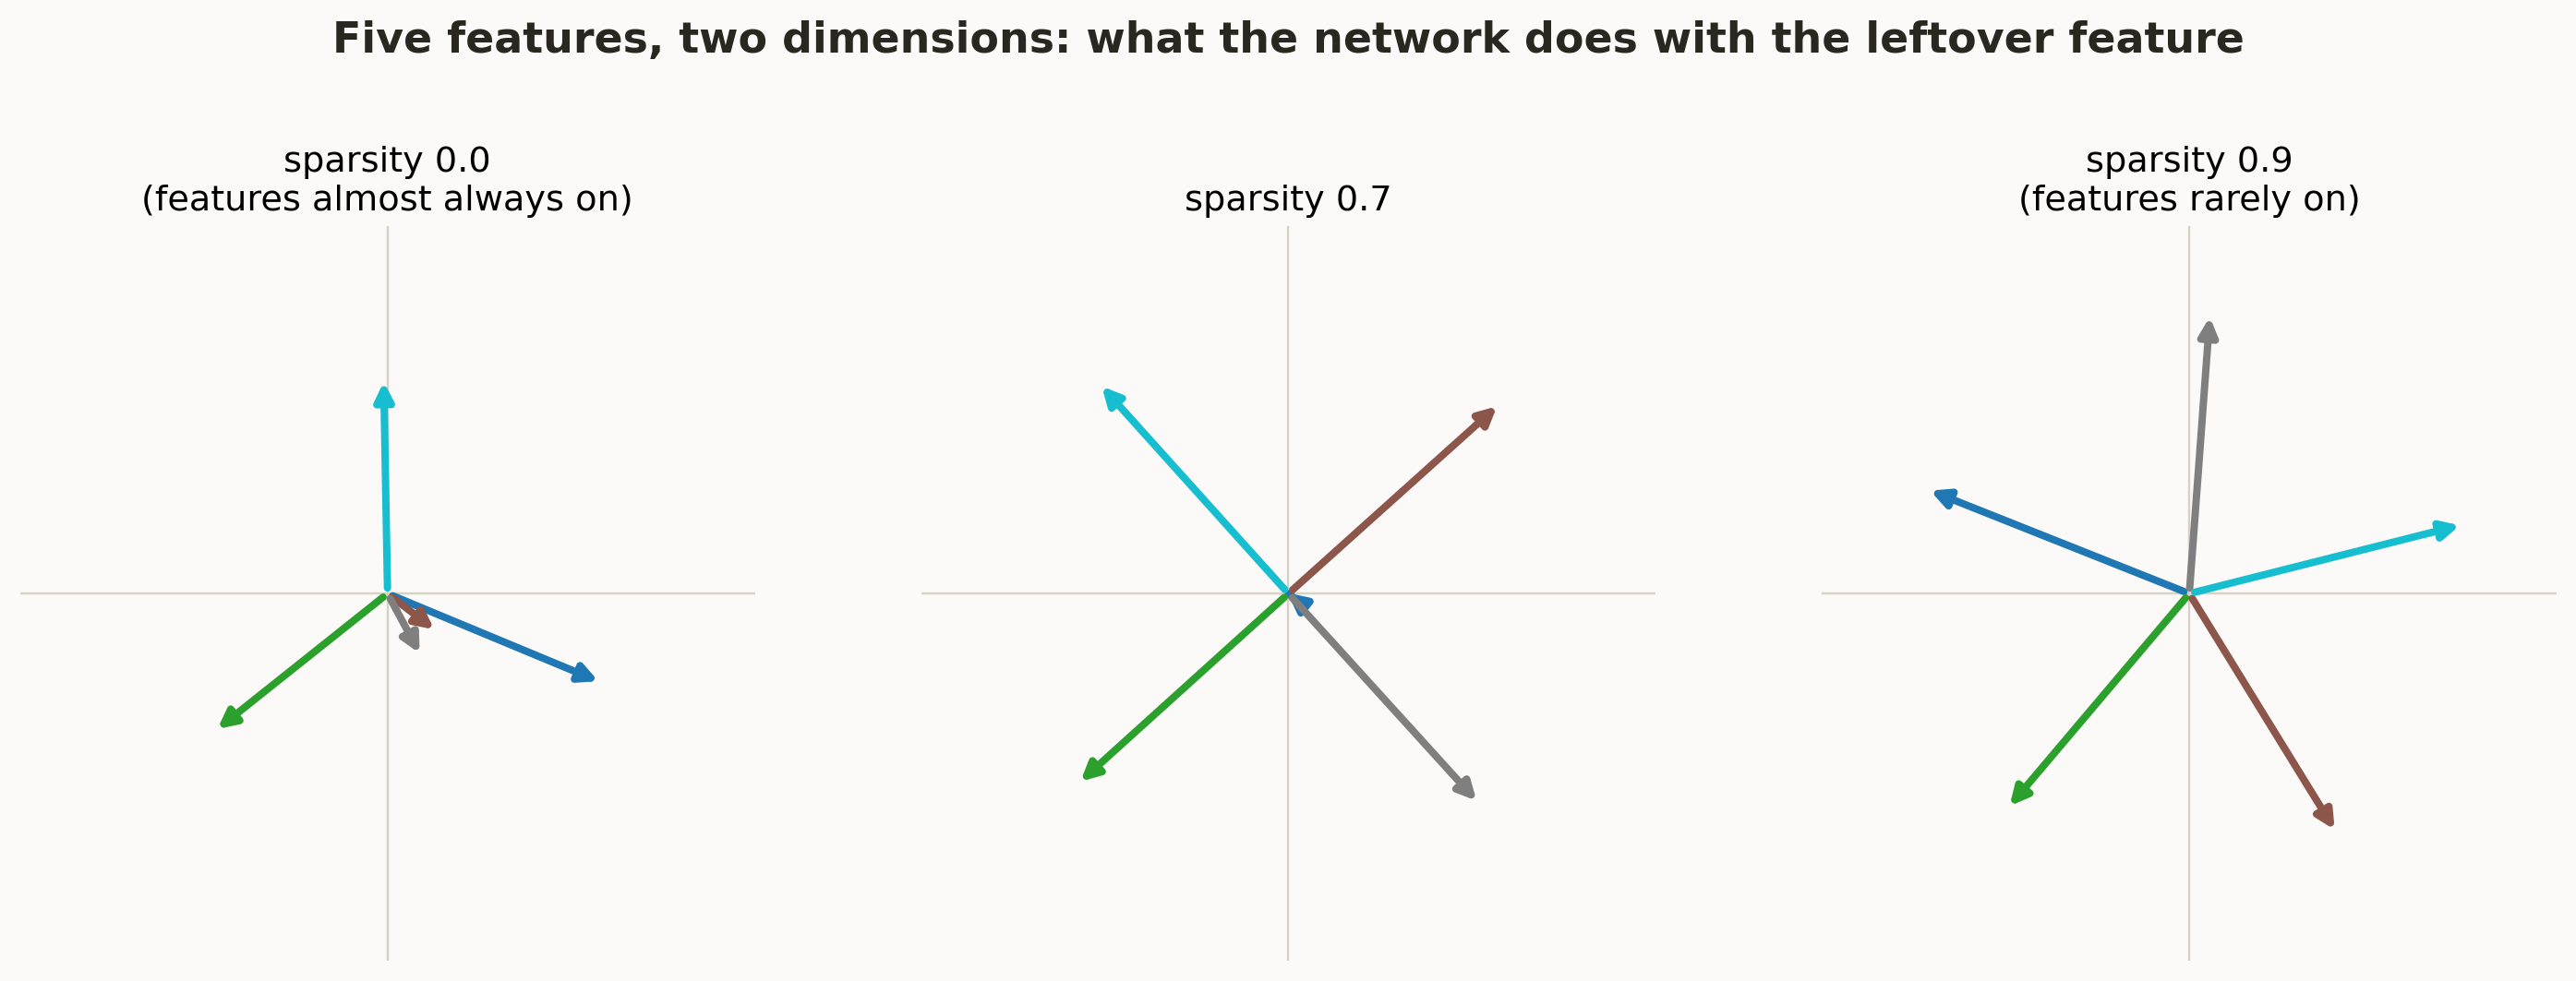
我没想到几何学会出现。我当时正在复现 Anthropic 2022 年可解释性论文《Toy Models of Superposition》[1] 的一小部分,主要是因为其核心论断听起来相当难以置信,我想亲自验证,而不是盲目相信。该论断是:一个神经网络可以表示比其可用维度更多的特征,方法是将它们以一定角度彼此堆叠,并容忍一些干扰。在合适的条件下,要求它将五个事物压缩到两个维度中,它不会挑选两个赢家而放弃其余。它会将全部五个排列成一个完美的五边形。
我没有 PyTorch 或任何自动微分库可用,也没有网络访问权限来安装一个,所以下面的一切都是纯 NumPy,并且我手动推导了反向传播。事实证明,这是一种恰到好处的烦人。自己推导梯度会迫使你真正理解模型对数据做了什么,而不是信任一个你从未需要思考过的 .backward() 调用。如果你有数学背景,并且从未手动推导过哪怕一个小网络的反向传播,我真的会推荐你把它当作一个练习。十分钟的链式法则会让后续的一切豁然开朗。
本文中的所有数据都是合成的。我在代码中自行生成,不涉及任何外部数据集,原论文也是如此。除非另有说明,所有图片均由作者提供。
这试图解释的问题
这是那个引人思考的谜题,而且它在可解释性研究中确实存在。如果你深入一个训练好的神经网络,希望找到能干净地表示单个概念的单个神经元——一个神经元表示“这是否是一只狗”,一个表示“这是否是红色”——你大多找不到。相反,你会发现神经元似乎同时对几个不相关的事物作出响应,比如一个神经元既对猫脸激活,也对汽车前端激活。这被称为多义性(polysemanticity),它使可解释性变得更加困难,因为你不能仅仅通过检查单个单元来读出网络“相信”什么。
论文的提议是,多义性不是噪声或失败。它是网络有意使用的一种真实策略,因为它要表示的概念比用来表示它们的神经元更多,而且这些概念中的大多数很少同时活跃。如果两个特征几乎从不同时“开启”,网络就可以让它们在激活空间中共享一个方向,因为干扰只在两者恰好同时触发的罕见情况下才会带来代价。这种打包策略就是论文所称的叠加(superposition),其玩具模型被设计成尽可能最简单的设置,让你能够观察它发生并实际测量它。
模型,以及我为了训练它而必须推导出的数学
这个设置是刻意做小的。你有 n 个合成特征,每个都是 0 到 1 之间的一个数,大多数时候为零(这就是稀疏性),其余时间非零。你通过一个 m 个隐藏维度的瓶颈将它们压缩,其中 m 小于 n,然后尝试在通过 ReLU 返回时重建原始特征。
具体来说,使用一个形状为 (m, n) 的单一权重矩阵 W,同时用于压缩和重建:
训练最小化 x x x 与 x ^ \hat{x} x ^ 之间的加权平方误差,其中每个特征 i 获得一个重要性权重 I i I_i I i ,因此网络被告知某些特征比其他特征更重要,需要更准确地重建:
由于我没有自动微分,我需要手动求出 ∂ L / ∂ W \partial \mathcal{L} / \partial W ∂ L / ∂ W 和 ∂ L / ∂ b \partial \mathcal{L} / \partial b ∂ L / ∂ b。一旦你把它设置为两个共享相同权重的矩阵乘法,这并不难。令 z = W ⊤ h + b z = W^\top h + b z = W ⊤ h + b 为 ReLU 之前的输出。通过平方误差和 ReLU 的标准反向传播会给出一个 delta 向量:
其中 ⊙ \odot ⊙ 是逐元素乘法,[ z > 0 ] [z > 0] [ z > 0 ] 是 ReLU 掩码。然后,由于 W 出现了两次,一次在压缩步骤中,一次在重建步骤中,对梯度的两个贡献只是相加:
第二个方程是我花了一分钟才弄对的唯一部分,它也很好地提醒了我们,为什么绑定权重在求导时比它们看起来更有趣一些。
下面是完整实现,按样本分批处理,并显式写出了 Adam,因为我也没有现成可用的实现:
import numpy as np
def generate_batch(batch_size, n_features, sparsity, importance, rng):
"""Sparse synthetic features: each is independently 'on' with probability
(1 - sparsity); when on, its value is Uniform(0, 1)."""
values = rng.uniform(0, 1, size=(batch_size, n_features))
mask = rng.uniform(0, 1, size=(batch_size, n_features)) > sparsity
return values * mask
class ToyModel:
def __init__(self, n_features, n_hidden, importance, rng, lr=1e-3):
self.n_features = n_features
self.n_hidden = n_hidden
self.importance = importance
self.W = rng.normal(0, 1 / np.sqrt(n_features), size=(n_hidden, n_features))
self.b = np.zeros(n_features)
self.lr = lr
self.mW = np.zeros_like(self.W); self.vW = np.zeros_like(self.W)
self.mb = np.zeros_like(self.b); self.vb = np.zeros_like(self.b)
self.t = 0
self.beta1, self.beta2, self.eps = 0.9, 0.999, 1e-8
def forward(self, X):
H = X @ self.W.T          # (batch, n_hidden)
Z = H @ self.W + self.b   # (batch, n_features)
Xhat = np.maximum(Z, 0)
return H, Z, Xhat
def loss(self, X, Xhat):
diff = X - Xhat
return (self.importance[None, :] * diff**2).sum(axis=1).mean()
def step(self, X):
batch = X.shape[0]
H, Z, Xhat = self.forward(X)
diff = X - Xhat
dXhat = -2 * self.importance[None, :] * diff / batch
dZ = dXhat * (Z > 0)
db = dZ.sum(axis=0)
dH = dZ @ self.W.T
dW = H.T @ dZ + dH.T @ X
self._adam_update(self.W, dW, 'mW', 'vW')
self._adam_update(self.b, db, 'mb', 'vb')
return self.loss(X, Xhat)
def _adam_update(self, param, grad, mname, vname):
self.t += 1 if mname == 'mW' else 0
m = getattr(self, mname); v = getattr(self, vname)
m[:] = self.beta1 * m + (1 - self.beta1) * grad
v[:] = self.beta2 * v + (1 - self.beta2) * (grad ** 2)
mhat = m / (1 - self.beta1 ** self.t)
vhat = v / (1 - self.beta2 ** self.t)
param -= self.lr * mhat / (np.sqrt(vhat) + self.eps)
下面的每个结果都来自实际运行这段代码,而不是来自论文中的数字。
实验一:网络会悄悄放弃那些不重要的特征
第一个检查:压缩到底有没有起作用,以及那些不太重要的特征会发生什么?我用 20 个特征输入到 5 个隐藏维度进行训练,稀疏度为 0.9(每个特征有 90% 的时间为零),并且让重要性在这 20 个特征上按几何级数衰减,因此特征 0 最重要,特征 19 最不重要。
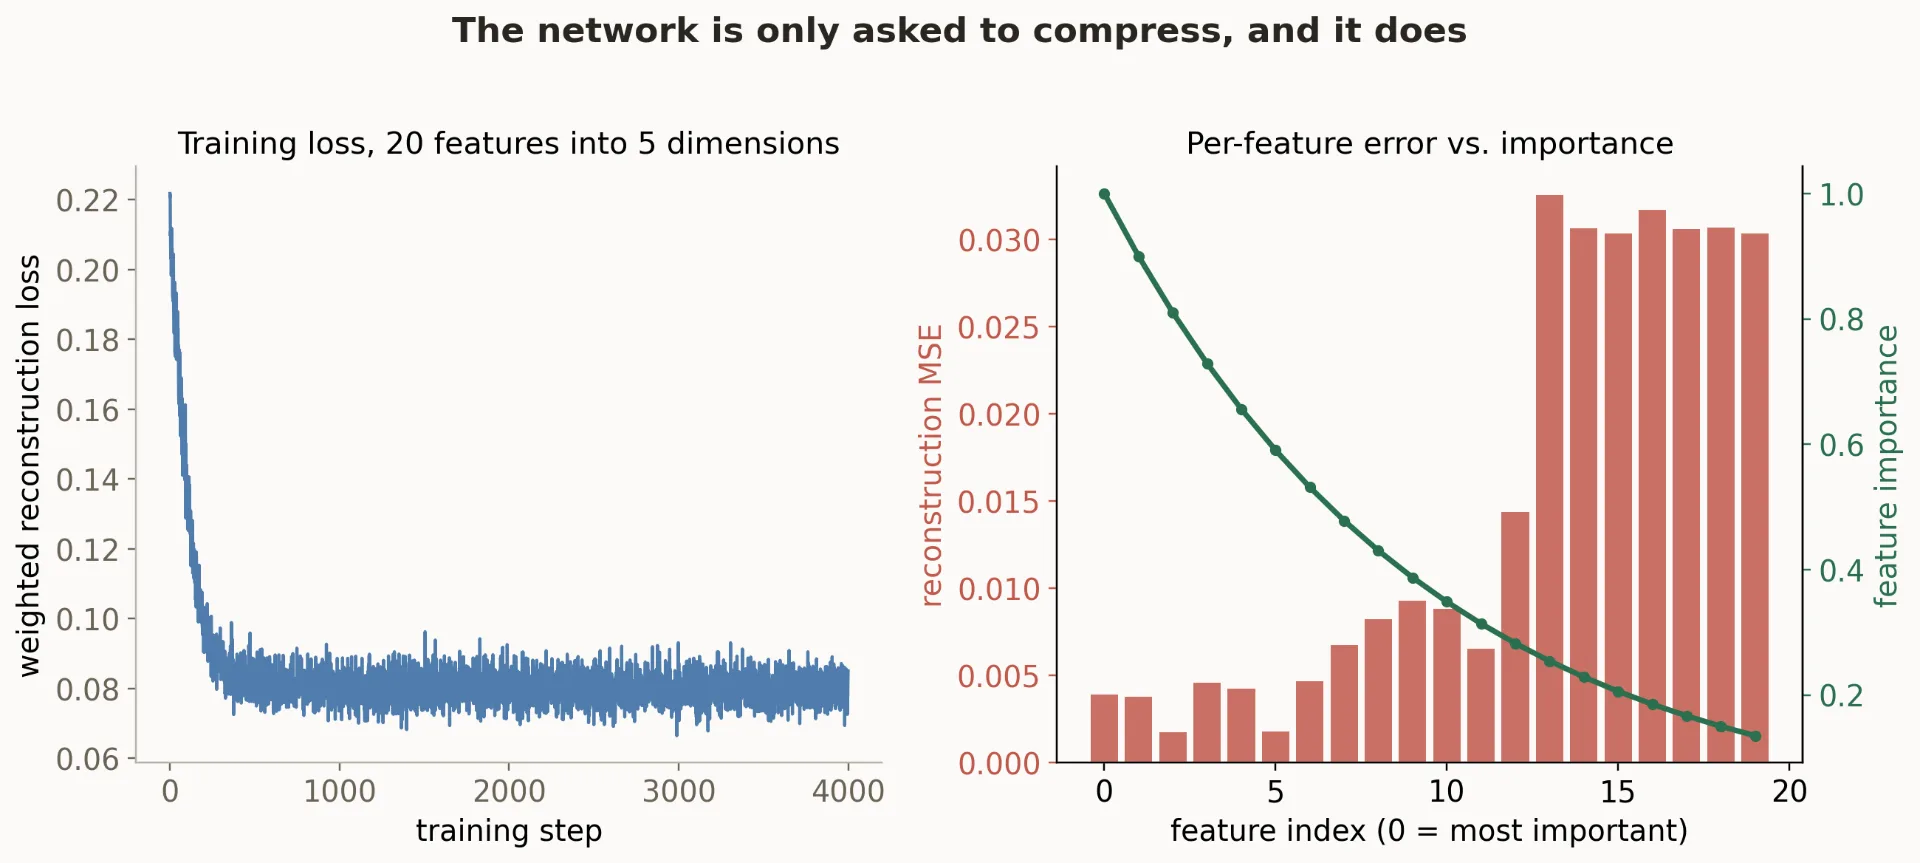
右图是我真正感到满意的一张图,因为它是由真实数字中浮现出来的,而不是论文里的描述。网络并不是以平庸的准确率重建全部 20 个特征。它做出了一个明确的决定:把重要特征表示好,而超过一个相当明显的阈值后,就不再费心处理其余特征。没有人告诉它要这样做。它只是从普通加权 MSE 损失上的梯度下降中自然产生的。
实验二:五个特征、两个维度,以及五边形
正是这个结果让我决定把它写出来。把 5 个同等重要的特征压缩到仅仅 2 个隐藏维度中,然后观察这 5 个学到的特征向量在那个二维空间中作为箭头实际是什么样子,并比较三种不同的稀疏度水平。
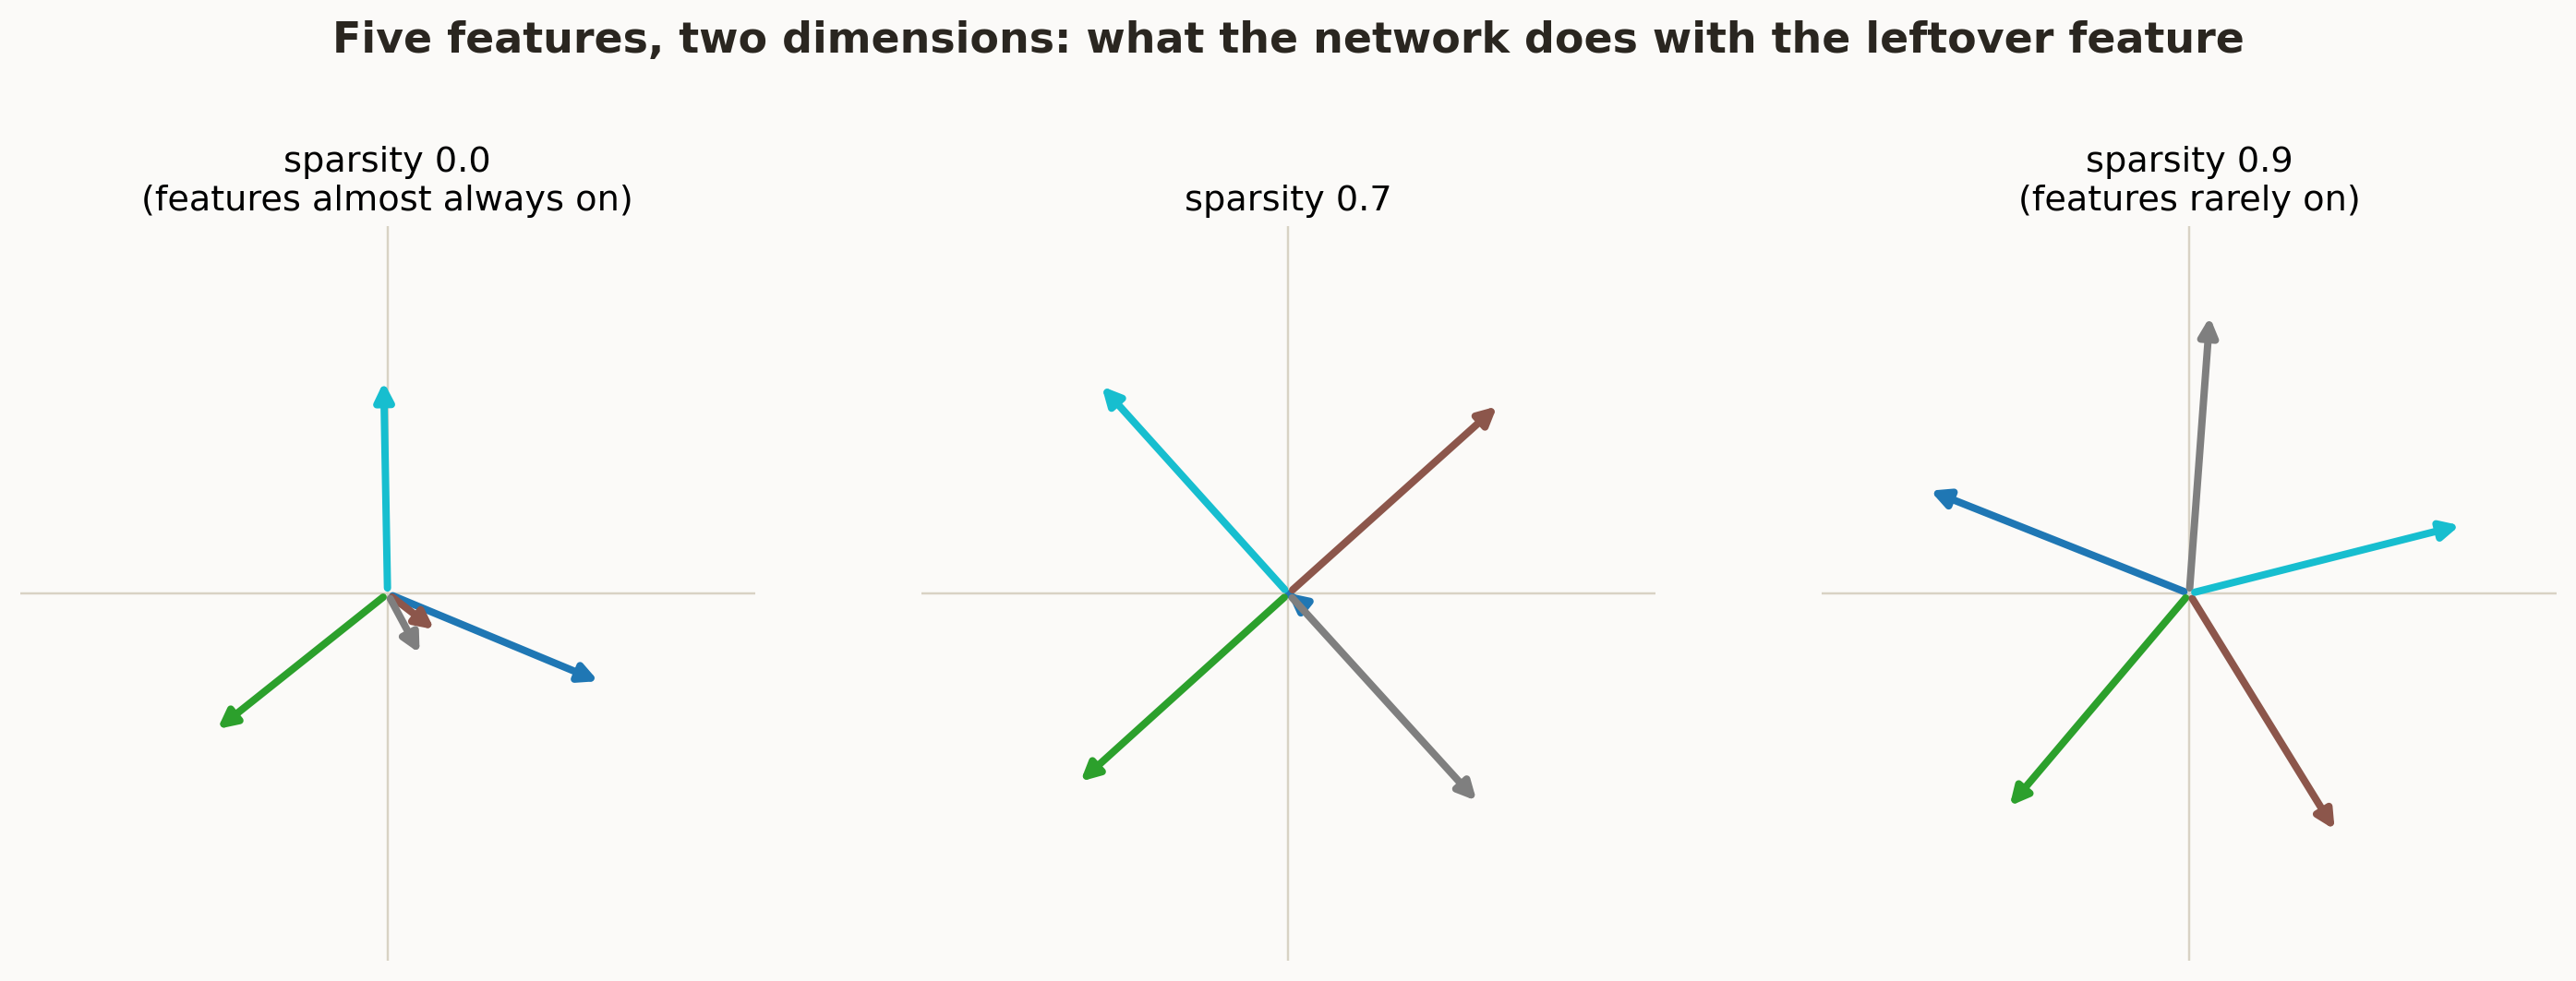
我以数值方式检查了最后这个说法,而不是靠肉眼判断:高稀疏度运行中的五个角度分别为 14.2、85.8、158.3、229.8 和 301.6 度,它们彼此相隔 71.5 到 72.5 度,基本上就是一个完美的正五边形,精确到大约半度。损失函数中没有任何项会奖励对称性。五边形只是把 5 个点放在圆上、使每一对点都与其他每一对点尽可能远离的最有效方式,从而最小化任意两个特征之间的最坏干扰。梯度下降自己找到了这种排列,因为它确实就是最优 packing,而不是因为有人告诉它什么是五边形。
实验三:干扰实际上是什么样子
对于 2 个维度中的 5 个特征来说,五边形图很好,因为你可以真正看到它。特征更多时,你就没法再画出这个图了,但你可以通过计算 W ⊤ W W^\top W W ⊤ W 来直接观察任意两个特征在多大程度上互相踩脚,它的对角线告诉你每个特征重建自身的程度,而非对角线项告诉你重建一个特征会在多大程度上破坏另一个特征。
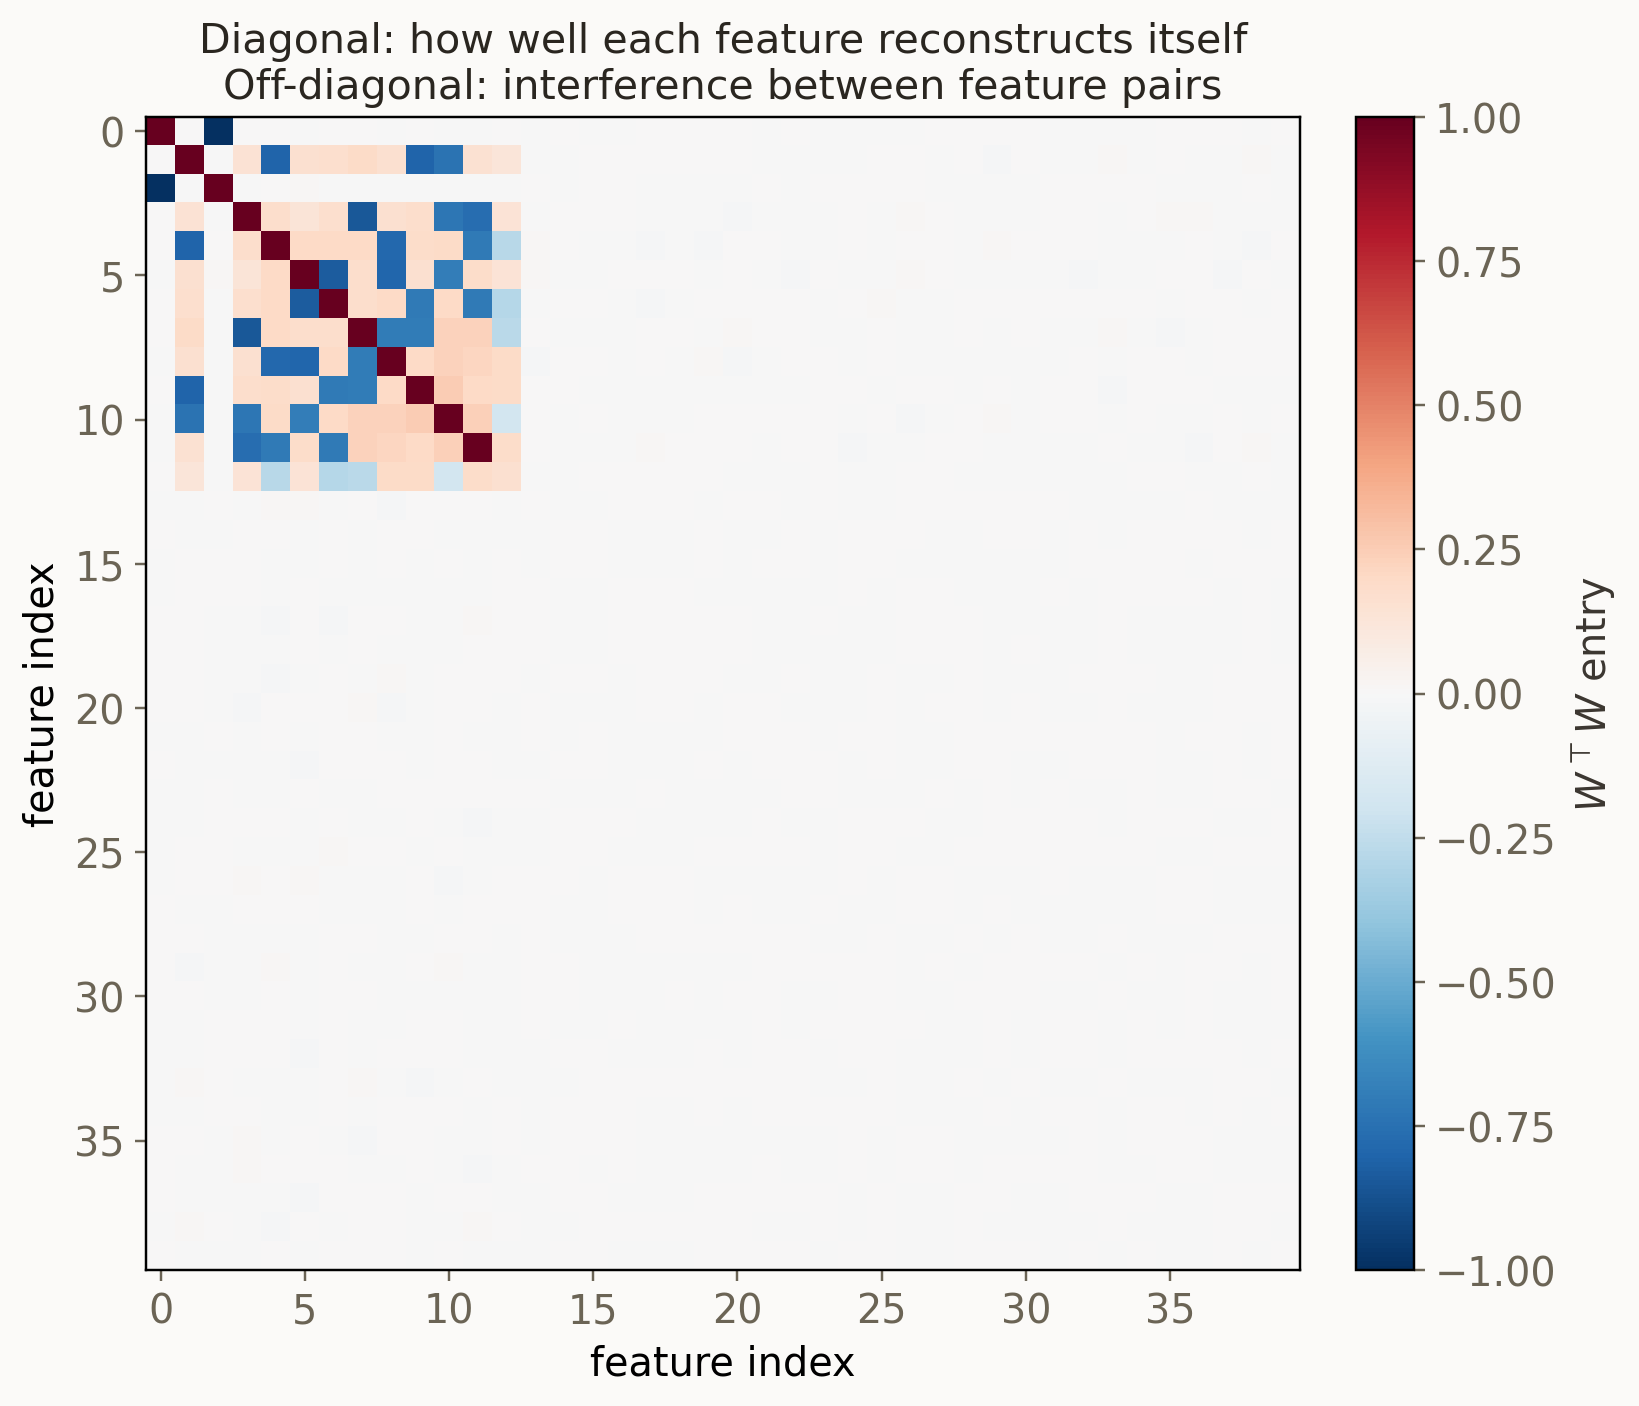
这与实验一几乎完全吻合。在特征 12 或 13 附近出现的相同截断点在两个实验中独立显现,这是一个很好的合理性检验,说明它测量的是真实效应,而不是某个特定图表的假象。
实验四:转动稀疏度旋钮
最后一个实验才真正配得上"相变"这个词——论文使用了这个术语,而在我亲眼看到之前一直对此持怀疑态度。固定 30 个特征和 5 个隐藏维度,将稀疏度从 0(特征几乎总是活跃)扫描到 0.99(特征只有 1% 的时间活跃),在每个级别从头重新训练。
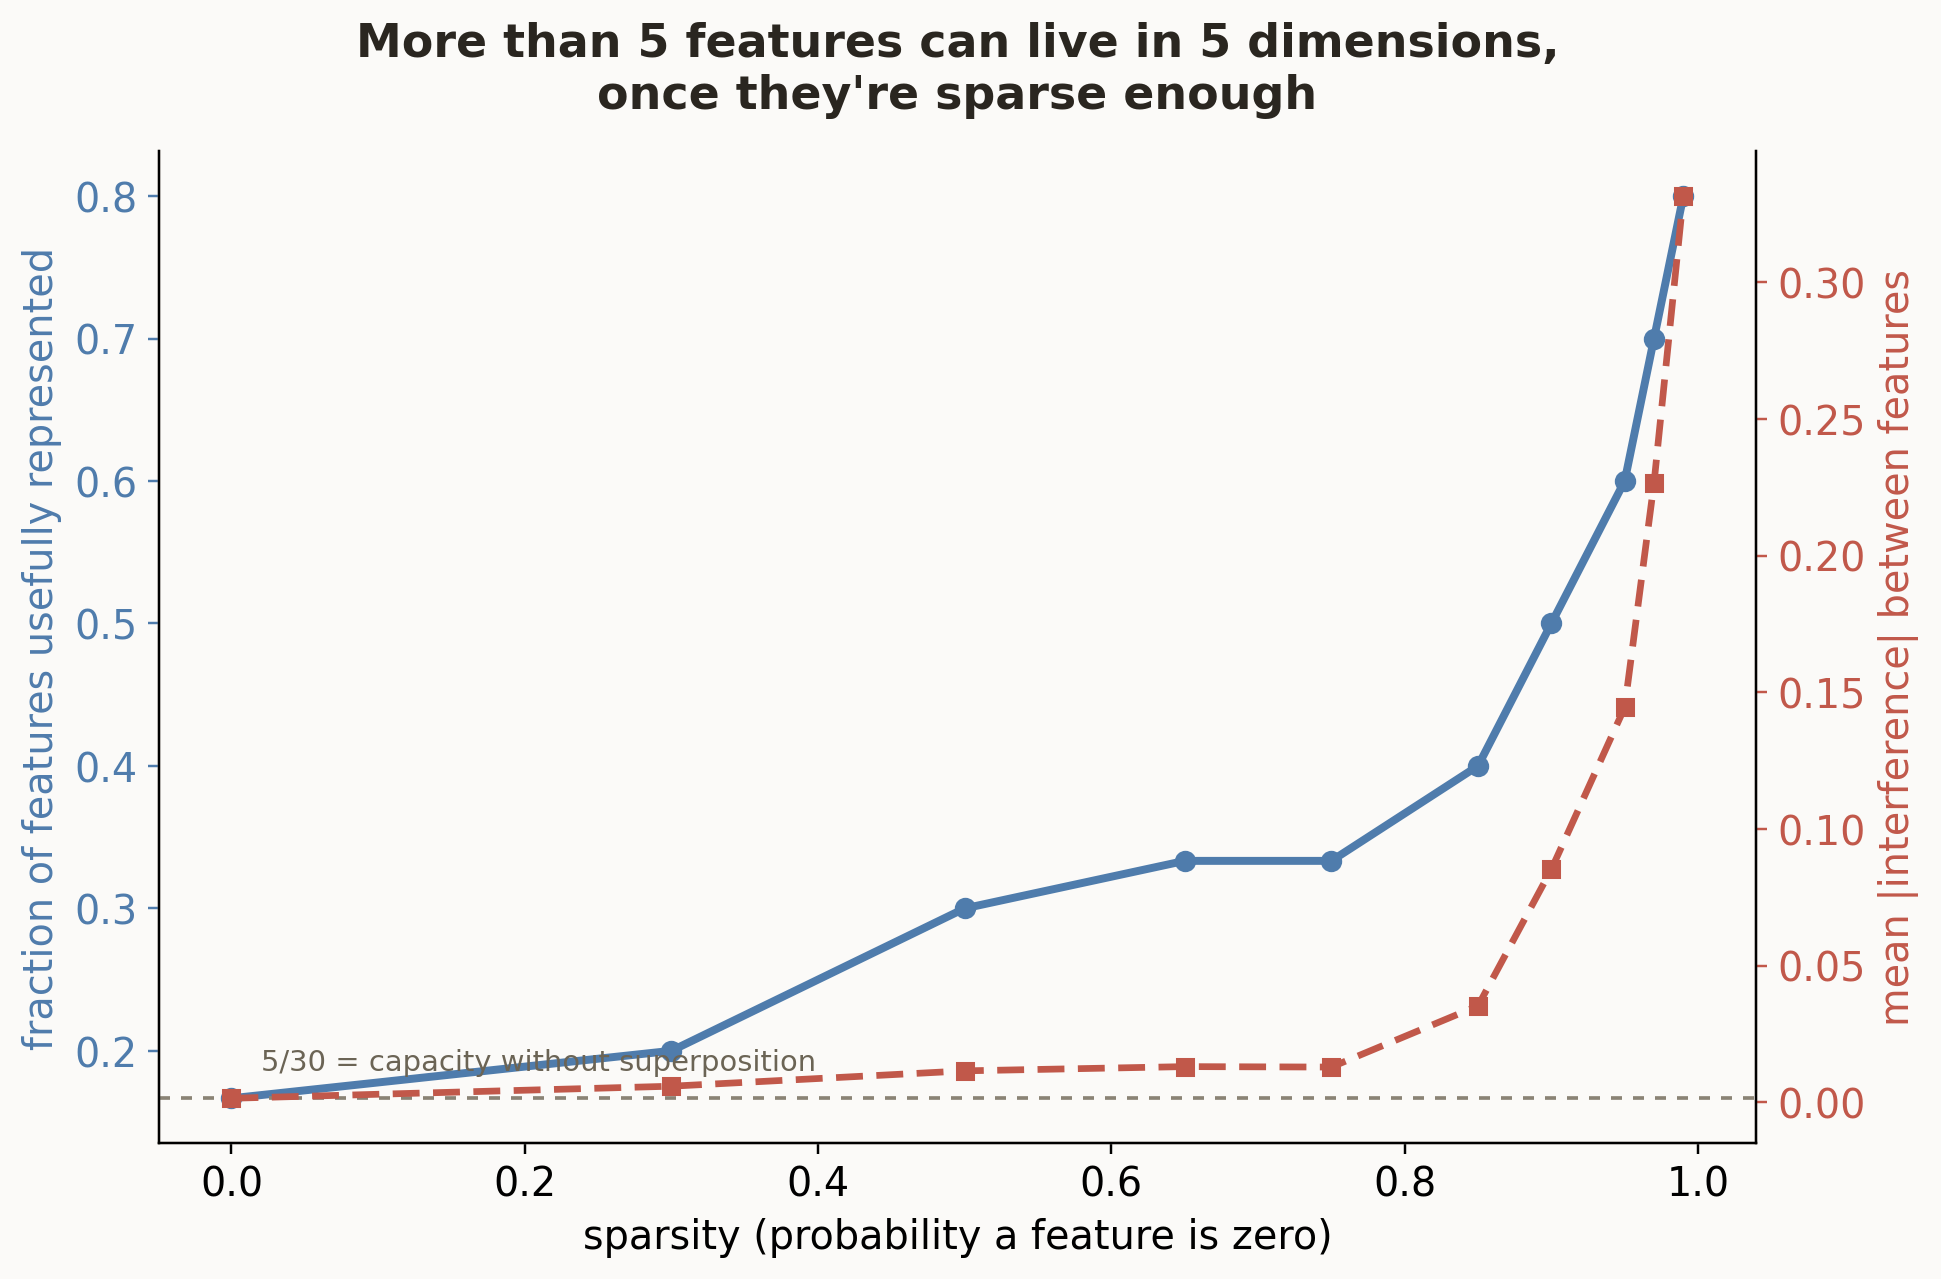
低稀疏度时的平坦段和大约 0.8 之后的急剧攀升,正是这成为相变而非平滑权衡的原因。网络所采用的策略发生了真正的体制转变,而不仅仅是逐渐转动旋钮。在某个阈值以下,叠加在干扰方面的代价超过了其价值。在阈值以上,它显然值得,网络便坚定地采用它。
这实际上告诉了你什么
所有这些都不需要大型模型、GPU 或真实世界数据集。三十个合成数字和一个下午就足以观察到一个现象的真实实例,而这个现象目前正是人们思考如何解释更大模型的核心。核心主张经受住了实际代码的检验:网络确实表示的概念比神经元多,它们通过利用稀疏性来做到这一点,而它们为此所采用的几何结构——对跖对、正多边形——并非装饰性的。它是损失函数愿意容忍的干扰量下的数学上高效的填充方式。
实际意义比一个五边形要大得多。如果一个大型语言模型在几千个神经元内表示了数千个概念——而且几乎可以肯定它确实如此——那么多义性就不是一个你可以通过更仔细地盯着单个神经元来修复的 bug。它是在稀疏性下压缩的可预测后果,也是为什么机械可解释性不得不开发专门工具(如稀疏自编码器)的重要原因之一,这些工具专门设计用来撤销这种填充并提取出单个特征。现在我已经在一个小到可以完全看清的系统中观察到了叠加的发生,我理解了为什么这条研究路线存在——我认为仅仅通过阅读相关文献是不会有的。
参考文献:
[1] N. Elhage, T. Hume, C. Olsson, N. Schiefer, T. Henighan, S. Kravec, Z. Hatfield-Dodds, R. Lasenby, D. Drain, C. Chen, R. Grosse, S. McCandlish, J. Kaplan, D. Amodei, M. Wattenberg and C. Olah, Toy Models of Superposition (2022) , Transformer Circuits Thread
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Towards Data Science
原创地址:https://towardsdatascience.com/i-trained-a-tiny-network-to-compress-data-it-drew-a-pentagon/
原文作者:utkarsh mangal;如有侵权,请联系管理员删除。

