Google 今天发布了两款新的 Gemini 文本转语音模型——gemini-3.8-flash-tts 和 gemini-3.8-flash-lite-tts。
它们附带了一个包含 2,000 多种声音的库,并且能够通过“仅需一段 30 秒的你的声音或你拥有使用权的 Sicherheitslücke 声音样本”来创建自定义声音。
我用 GPT-6 Astra 凭感觉编写了这个自带密钥的游乐场界面,利用了底层 Gemini API(应用程序编程接口) 的开放 CORS 策略。
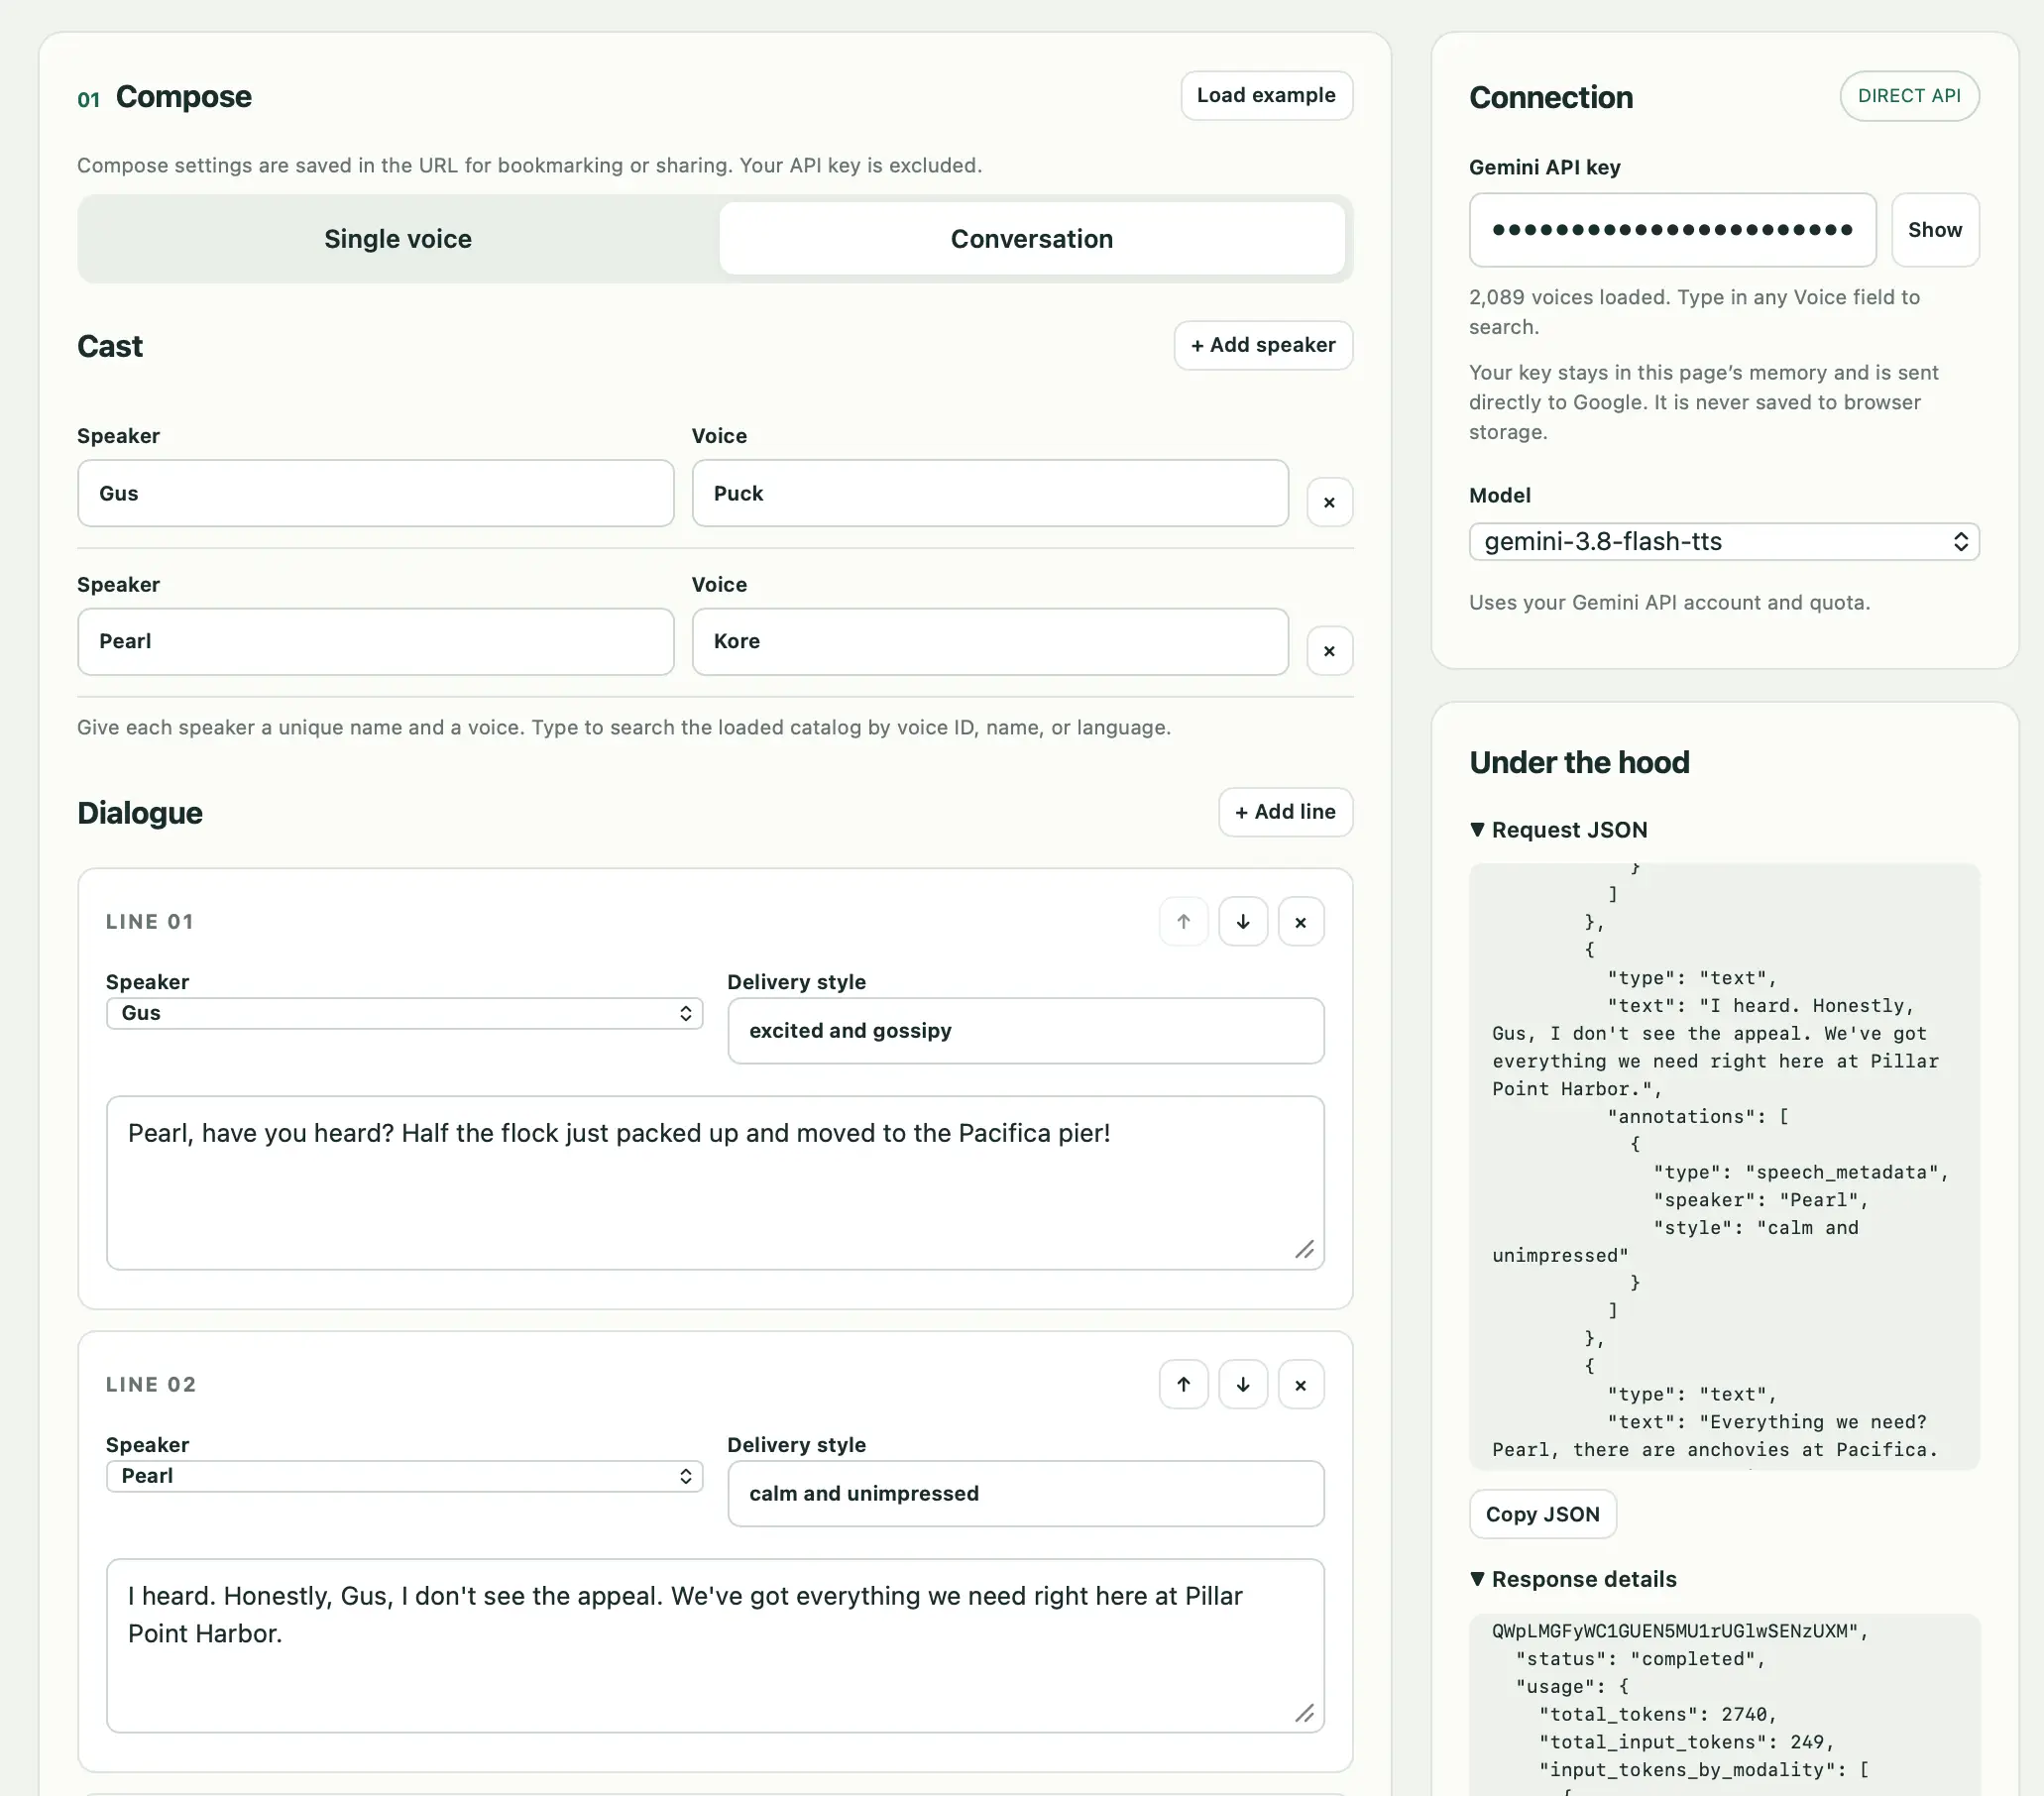
该 API 的一个显著特点是,它让定义多个角色之间的完整对话变得很容易,每个角色都有不同的声音和声音风格指令。
这里有一段简短的演示片段,内容是两只鹈鹕在争论它们是否应该搬到 Pacifica Pier。我让 Claude 4.5 Opus 编写了脚本,并生成一个 URL 来使用该工具渲染它。
你的浏览器不支持音频元素。
使用 Gemini 3.8 Flash TTS(不是更便宜的 Flash-Lite)生成 1 分 18 秒的音频大约花了 20 秒,成本为 2.74 美分。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Simon Willison
原创地址:https://simonwillison.net/2026/Sep/23/gemini-tts-playground/
原文作者:Simon Willison;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
