我们解释如何使用评分指标获取模型性能的估计值,然后探讨发现和诊断机器学习算法潜在问题的方法。
微调机器学习预测模型是提高预测结果准确性的关键步骤。最近,我写了许多文章,解释机器学习的工作原理以及如何丰富和分解特征集以提高机器学习模型的准确性。
本文探讨以下细节:
使用评分指标获取模型性能的估计值
发现和诊断机器学习算法的常见问题
微调机器学习模型的参数
步骤 1:理解什么是调优机器学习模型
有时,我们必须探索模型参数如何提高机器学习模型的预测准确性。微调机器学习模型是一门黑魔法。它可能是一项耗时的任务。在本文中,我将介绍多种方法,我们可以遵循这些方法在更短的时间内获得准确的结果。
当特征稳定且特征集已分解时,我经常被问到可以用来调优预测模型的技术。一旦所有方法都尝试过,我们就应该考虑调优我们的机器学习模型。
调优机器学习模型就像旋转电视开关和旋钮,直到获得更清晰的信号
此图说明了参数如何相互依赖。
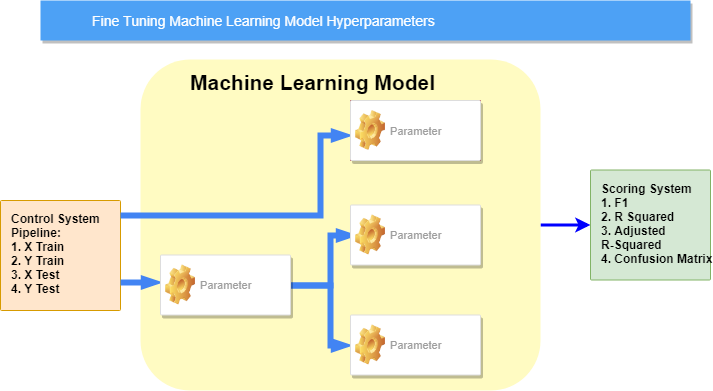
X Train — 自变量的训练数据,也称为特征
X Test — 自变量的测试数据
Y Train — 因变量的训练数据
Y Test — 因变量的测试数据
例如,如果你根据温度和湿度预测瀑布的水量,那么水量表示为 Y(因变量),温度和湿度为 X(自变量或特征)。X 的训练数据称为 X Train,你可以用它来训练模型。
超参数是模型的参数,可以作为参数输入到模型中。
第 2 步:掌握基础知识
在微调你的预测模型之前,简要了解什么是机器学习非常重要。
如果你是机器学习新手,请查看这篇文章:
8 分钟了解机器学习
改进我们输入模型的数据通常比微调模型参数更容易。如果你想提高预测模型的准确性,请先丰富特征集中的数据。
如果你输入低质量的数据,那么模型将产生糟糕的结果。
请查看这篇文章,其中重点介绍了我们可以用来丰富特征的常见技术:
处理数据以提高机器学习模型的准确性
如果你不确定你的模型是否是最适合该问题的模型,请查看这篇文章。它回顾了机器学习模型中最常见的算法:
机器学习算法比较
步骤 3:确定你的评分指标
最重要的前提是确定你将用来评估预测模型准确性的指标。
它可以是 R squared、Adjusted R squared、Confusion Matrix、F1、Recall、Variance 等。
阅读这篇文章,了解每位数据科学家都应该知道的最重要的数学度量。这些度量以易于理解的方式进行了解释:
每位数据科学家都必须知道的数学度量
from sklearn.metrics contains a large number of scoring metrics
步骤 4:获得准确的预测评分
一旦你准备好了训练集、丰富了其特征、对数据进行了缩放、分解了特征集、确定了评分指标,并在训练数据上训练了模型,那么你就应该在未见过的数据上测试模型的准确性。未见过的数据被称为“测试数据”。
你可以利用交叉验证来评估模型在未见过的数据上的表现。这被称为模型的泛化误差。
交叉验证
有两种常见的交叉验证方法
留出法交叉验证
在同一个数据集上训练模型并评估其准确率并非明智的机器学习实践。更优的做法是在未见过的测试集上使用不同的模型参数值来测试你的模型。
将数据集划分为三部分是一种良好的实践:
训练集
验证集
测试集
在训练集(数据的60%)上训练模型,然后在验证集(数据的20%)上进行模型选择(调参),准备就绪后,在测试集(数据的20%)上测试模型。
根据你的机器学习模型的需求和数据的可用性,确定训练集、验证集和测试集的比例。
K折交叉验证
K折交叉验证是一种优于留出法交叉验证的机制。其工作原理是将数据分为k折(部分)。其中k-1折用于训练模型,最后一折用于测试模型。
该机制重复k次。此外,每次可以使用多种性能指标来评估和打分。然后报告性能指标的平均值。在StratifiedKFold中,类别比例得以保留。
选择8–12折
from sklearn.cross_validation import cross_val_score
scores = cross_val_score(estimator=pipe_lr, X=X_train, y=Y_train, cv=12, n_jobs=)
mean_scores = scores.mean()
n_jobs参数控制用于运行交叉验证的CPU数量。
步骤5:使用验证曲线诊断最佳参数值
一旦建立了准确的预测评分,找出模型所需的所有参数。然后你可以使用验证曲线来探索这些参数值如何提高预测模型的准确率。
在我们调参之前,需要先诊断并判断模型是处于欠拟合还是过拟合状态。
参数数量庞大的模型容易过拟合。我们可以使用验证曲线来解决机器学习中的过拟合和欠拟合问题。
这些参数也被称为超参数。
照片由 Dominik Scythe 发布于 Unsplash
验证曲线用于传入模型参数的一系列取值。它每次改变一个模型参数的值,然后将准确率值与模型参数值进行绘图,以评估模型的准确率。
例如,如果你的模型接受一个名为“number of trees”的参数,那么你可以通过传入该参数的 10 个不同取值来测试模型。你可以使用验证曲线来报告每个参数取值下的准确率,以评估准确率。最后,选择返回最高准确率的分数,并在可接受的时间内为你提供所需的结果。
Sci-kit learn 提供了 validation curve 模块:
from sklearn.learning_curve import validation_curve
number_of_trees= [1,2,3,4,5,6,7,99,1000]
train_scores, test_scores = validation_curve(estimator=, … X=X_train,y=Y_train, param_range=number_of_trees, …)
步骤 6:使用网格搜索优化超参数组合
一旦我们获得了各个模型参数的最优值,就可以使用网格搜索来获取能够为我们提供最高准确率的模型超参数值组合。
网格搜索会评估参数值的所有可能组合。
网格搜索是穷举式的,使用暴力方法来评估最准确的取值。因此,这是一项计算密集型任务。
使用 sci-kit learn 的 GridSearchCV 来执行网格搜索。
from sklearn.grid_search import GridSearchCV
步骤 7:持续调整参数以进一步提升准确率
这里的关键是,一旦有更多数据可用,就始终增强训练集。
始终在模型未见过的更丰富测试数据上测试你的预测模型。
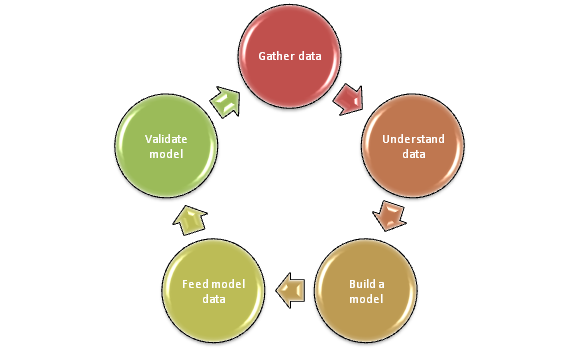
始终确保为任务选择正确的模型和参数值。
重要的是,一旦有更多数据可用就立即输入更多数据,并持续测试模型的准确率,以便进一步优化性能和准确率。
本文揭示了我们可以如何做到以下事项的细节:
使用评分指标获取模型性能的估计值
发现并诊断机器学习算法的常见问题
微调机器学习模型的参数以进一步提升准确率
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原创地址:https://www.kdnuggets.com/2019/01/fine-tune-machine-learning-models-forecasting.html#comment-184072
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

