查看这份包含答案的高级SQL面试问题合集。
引言
所有数据库使用的标准语言是结构化查询语言(SQL)。
它在从数据库中获取所需数据方面发挥着关键作用。所有大数据平台,如Hadoop和Spark,都使用SQL作为其组织的高级语言。
数据科学是研究和分析数据的唯一领域。数据的输出结果应准确无误,以便进行调查。
这就是SQL与数据科学结合的方式。尽管某些组织已转向NoSQL,但其基础仍在于SQL。
正在准备数据科学面试?
25个高级SQL面试问题
一些你必须掌握的SQL面试问题及答案。
1. 解释规范化?
规范化是一种组织数据库中数据的方法,旨在从一组关系中最小化冗余。范式(Normal forms)的概念用于对关系执行规范化。
NF:如果一个关系具有原子值,则它处于1NF。
NF:要使一个关系处于2NF,它必须处于1NF,并且所有非键属性完全函数依赖于主键。
NF:要使一个关系处于3NF,它必须处于2NF,并且不存在传递依赖。
BCNF:Boy Codd范式是3NF的强表示。
2. 解释DDL和DML之间的区别?
DDL代表数据定义语言,而DML称为数据操纵语言。
DDL创建带有某些约束的模式。DML在该模式中添加、检索或更新数据。
DDL定义表的列属性。DML提供表的行属性。
DDL命令的示例包括create、alter、drop、rename等,而DML的示例包括merge、update、insert等。
WHERE子句在DDL中不使用,但在DML中使用。
3. SQL中的ACID属性是什么?
ACID属性如下:
原子性(Atomicity)——数据中的更改必须像单个操作一样。
一致性(Consistency)——数据在事务前后必须保持一致。
隔离性(Isolation)——多个事务可以在没有任何阻碍的情况下执行。
持久性(Durability)——在系统故障的情况下事务能够成功。
4. 编写一个查询来查找表中的所有重复项?
在一般场景下,可以用来查找表中所有重复项的方法如下:
使用GROUP BY命令按目标列对所有行进行分组。这里的自标列是你可以检查重复项的列。
使用HAVING命令并集成COUNT函数来检查是否有任何组有超过一个条目。
5. 聚集索引和非聚集索引之间的区别?
聚集索引和非聚集索引之间的区别:
聚集索引用于定义对索引或表进行排序的顺序,就像字典一样。非聚集索引将所有数据收集在一个地方,并将其记录在另一个地方。
聚集索引比非聚集索引更快。
与使用非聚集索引相比,对聚集索引执行操作所使用的内存更少。
6. 解释反规范化?
向表中添加数据(冗余)的数据库优化技术称为反规范化。该技术很有用,因为它有助于减少数据库中代价高昂的连接操作。
7. 什么是排序规则?
在 SQL server 中,排序规则为数据库中的数据提供排序规则、重音和大小写敏感属性。它通过使用排序规则定义位模式来表示数据库中的每个字符。
一些排序规则级别如下:
区分大小写 (_CS)
区分重音 (_AS)
区分假名 (_KS)
区分宽度 (_WS)
区分变体选择符 (_VSS)a
二进制 (_BIN)
二进制码位 (_BIN2)
8. 内连接、外连接和全外连接之间有什么区别?
内连接、外连接和全外连接之间的区别:
在内连接中,输出的是两个表中都存在的行。
在全外连接中,返回两个表中的所有行。
外连接返回来自任一表或两个表的值。
9. 解释连接和联合之间的区别?
连接和联合之间的区别:
Join 从表中检索匹配的记录,而 union 用于组合两个不同 SELECT 语句的集合。
Join 不会删除重复数据,而 union 会从选定的语句中删除重复数据(行)。
10. 解释 UNION 和 UNION ALL 之间的区别?
Union 保留唯一记录,而 Union 保留所有记录,包括所有重复项。此外,union 在返回数据之前执行去重步骤,而 union all 打印连接后的结果
11. 编写一个查询以打印表中的最高工资?
考虑一个包含以下数据的表,表名为 EMP-
---------------------
SELECT * FROM EMP WHERE salary=(select Max(salary) FROM EMP);
12. 共享锁和排他锁之间有什么区别?
在共享锁中,锁定模式仅用于读操作,但在排他锁中,它用于读和写操作。
共享锁阻止其他人更新数据,而排他锁阻止其他人读取或更新数据。
任意数量的事务都可以在特定项上持有共享锁,而只有一个事务可以持有排他锁。
13. 解释使用 SQL 进行转置的机制?
SQL 中的转置定义为将行或列更改为特定格式,以从新的角度可视化数据。
一种基本的转置是将行更改为列或将列更改为行。典型的转置方法是动态转置和连接转置。
所有转置方法都用于数据分析,以获得丰硕的成果。
14. 解释 B 树索引的工作原理?
B 树被定义为一种自平衡搜索树,其中所有叶子节点都处于同一层级。要在 B 树中插入数据,数据会被插入到叶子节点。
在 B 树索引中,树具有一个键值对,称为有效载荷(payload)。该值引用实际的数据记录。
当我们使用 B 树索引时,数据库会按照 B 树搜索给定的键,并获取索引。
15. 解释 Truncate 和 Delete 对标识列的影响?
DELETE 和 TRUNCATE 命令之间的区别:
DELETE 命令用于删除表中的特定行,而 TRUNCATE 会删除所有行中的数据。
DELETE 是 DML 命令,比 TRUNCATE 命令慢,后者是 DDL 命令。
DELETE 命令会激活触发器,而 TRUNCATE 不会。
16. 解释拥有数据库索引的代价?
它会占用你的空间。表越大,索引就越大。
对表中某些行进行 ADD、DELETE 或 UPDATE 操作时,也必须对我们的索引执行相应操作。
根据经验法则,如果索引列所在的表会被频繁使用,则必须在表上创建索引。
17. 拥有索引有哪些优势?
使用索引的优势:
它可以加速 SELECT 查询。
数据检索变得非常容易。
索引可用于排序。
它使行唯一且没有重复。
当索引设置为填充文本索引时,可以插入大型字符串文本。
## 18. 解释数据库中的索引?
索引是一种数据结构技术,通过在查询处理期间减少磁盘访问来优化数据库性能。
索引具有以下属性:
访问类型:基于搜索类型
访问时间:基于搜索时间
插入时间:基于快速插入
删除时间:基于快速删除
空间开销:基于额外的开销空间。
## 19. 什么是 OLAP 和 OLTP?
## 在线分析处理(OLAP)
企业必须理解一组数据,这有助于财务领导者和业务团队深入了解其用户以及多个相关因素的表现。
企业可以在业务流程和策略中拥有各种数据,帮助团队在更细粒度的层面上分析绩效。
这些数据存储在多个数据库系统中,因此需要一致、实时且更灵活的流程,帮助团队分析数据并进一步处理以进行更多分析。
在线分析处理或 OLAP 包含用于分析业务数据并帮助深入了解数据库的软件工具。
例如,OLAP 可用于构建 Spotify 歌曲推荐引擎,该引擎根据用户的歌曲选择和历史收听数据自动为用户生成播放列表。
在线事务处理(OLTP)
事务是每个业务不可或缺的一部分。向客户提供服务的业务在客户使用服务时会收到一笔金额。
当用户为他们选择的服务付款时,发票会立即生成。
当我们需要存储所有用户的事务信息时,事务数据库就登场了。
然而,在线事务处理(OLTP)提供了面向事务的应用程序,这些应用程序被归类为三层架构。
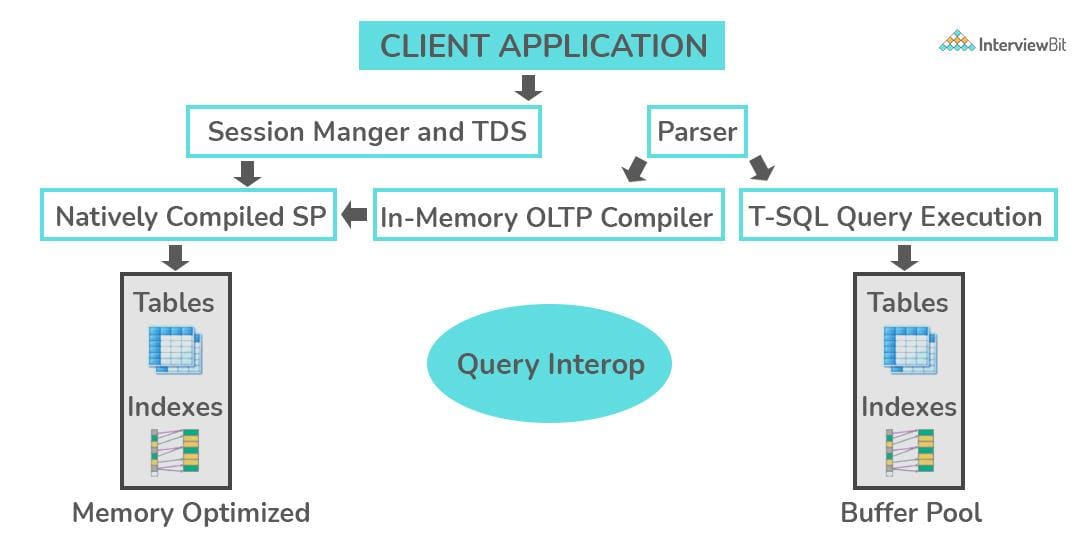
OLTP 帮助业务执行与事务数据库相关的某些活动。
例如,通过网上银行进行交易也服务于同样的目的,其中 OLTP 可用于操作用户事务信息。
20. CASE WHEN 在什么条件下适用?
SQL 用于查询数据库和修改大型数据集中的值。它还提供了一种在存在多种情况时操作数据的方法。
例如,一个表包含员工列表(name)以及经验(EXP)和入职日期(ac_date)。
现在,如果我们想以这样的方式查询数据:如果经验大于(>)“4”,则在新列“exp_level”中插入“Is a senior”,否则在该列中插入 NULL。
在这种情况下,你可以使用 CASE WHEN 语句查询数据库。
CASE WHEN 语句类似于 C、C++、Python 等编程语言中的 If/else 条件。
CASE 语句后面跟着一对 WHEN 和 THEN 语句。不过,你可以根据需求添加嵌套语句。
一旦 CASE 语句完成,通过添加以 ELSE 和 END AS 开头的结束语句来完成。
在上面的示例中,我们有 employee.database,它列出了公司的员工及其属性,如员工姓名、入职年份、经验等。在这个示例中使用 CASE WHEN 语句,
SELECT employee_name,
       exp,
       CASE WHEN exp > 4 THEN 'Is a Senior'
            ELSE NULL END AS exp_level
  FROM xyz.marketing_employees
21. 解释使用 HAVING 与 WHERE 的场景?
SQL 中的 HAVING 子句
SQL 提供 HAVING 子句来过滤数据库中的一组数据。
例如,公司 XYZ 有一份拥有超过 1 年经验的员工名单。
数据库包含行和列,包括员工姓名、入职数据、经验和经验水平。
你可以检索拥有超过 5 年经验的员工名单。
HAVING 子句为你提供了一种控制信息并使用一组数据修改数据的方式。
HAVING 子句的语法是 HAVING condition。
在示例中,我们可以通过如下查询数据库来检索具有超过 5 年经验的员工列表:
SELECT employee_name, exp_level,
FROM EMPLOYEE
GROUP BY experience
HAVING COUNT(experience) > 5;
SQL 中的 WHERE 子句
当你希望基于特定条件筛选记录时,可以使用 WHERE 子句。
例如,在员工表中,我们可以检索出在公司中恰好有 5 年经验的所有员工列表。WHERE 子句的语法是,WHERE condition。
在示例中,我们可以通过如下查询数据库来提取具有 5 年经验的员工姓名:
SELECT employee_name, exp_level,
FROM EMPLOYEE
WHERE experience=  5;
22. 什么是 PL/SQL?
PL/SQL 是一种块结构语言,鼓励开发者通过过程式语句来使用 SQL 的强大功能。
它是一种特性丰富的过程式语言,内嵌了决策能力以及 POP 的许多其他特性。
使用单个块命令,PL/SQL 可以在广泛错误检查的支持下运行多个查询。
PL/SQL 是 SQL 的扩展,用于创建应用程序。
23. SQL 中的 ETL 是什么?
ETL 代表“提取、转换和加载”。它利用数据仓库的概念来进行数据可视化和数据分析。在更广泛的背景下,它用于数据集成。
任何从某个系统提取数据并将其存储/复制到另一个目标系统,且其数据以不同方式表示的系统,都称为 ETL 过程。
24. 什么是嵌套触发器?
SQL 提供数据操作语言(DML)和数据定义语言(DDL),以便在查询数据库时执行某些操作。
当对数据库执行某种类型的操作时,它也会自动在数据库上执行一些动作。
当这些类型的动作在数据库中被触发时,它们被称为嵌套触发器。
SQL 将嵌套触发器分为两大类——AFTER 触发器和 INSTEAD OF 触发器。
顾名思义,AFTER 触发器在对数据库执行 DML 或 DDL 操作之后执行。
然而,INSTEAD OF 触发器代替 DML 和 DDL 操作执行。
25. 什么是提交和检查点?
提交确保在当前事务结束后,数据保持一致并保持在更新状态。使用提交时,会向日志内存中添加一条新记录。
对于检查点,它用于将所有已提交的更改写入磁盘,直到控制文件和头文件中的系统更改号。
结论
在本文中,我们详细讨论了数据科学家面试中会问到的所有 SQL 问题。
如果你是初学者,可以从以下内容学习 SQL:
Matthew Mayo 的 SQL in 4 Hours Full Course
Scaler 的 SQL by Wikipedia SQL Tutorial
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

