Pomegranate 是一种美味的水果。它也可以是一个用于统计分析的超级有用的 Python 库。我们将在本文中展示如何做到这一点。
什么是 Pomegranate?
首先,它是一种美味的水果。
但对于热爱水果的数据科学家来说,这是双重喜悦!
它也是一个 Python 包,实现了快速且灵活的概率模型,从单个概率分布到组合模型,如贝叶斯网络和隐马尔可夫模型。
这个包背后的核心思想是,所有概率模型都可以被视为一个概率分布。这意味着它们都为样本产生概率估计,并且可以根据样本及其相关权重进行更新/拟合。这一认识的主要结果是,实现的类可以比其他常见包中可用的类更灵活地堆叠和链接。
与 Scipy 或 Numpy 有什么不同?
这是一个合理的问题。然而,你会看到 Pomegranate 包中实现的类非常直观,并且具有统一的接口,尽管它们涵盖了广泛的统计建模方面,
一般分布
马尔可夫链
贝叶斯网络
隐马尔可夫模型
贝叶斯分类器
这就像将多个 Python 库中的有用方法结合在一起,并具有统一且直观的 API(应用程序编程接口)。
让我们看看这个精巧的小包的一些酷炫用法。
概率分布
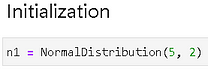
让我们用 NormalDistribution 类来初始化。
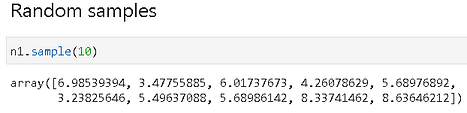
生成一些样本,
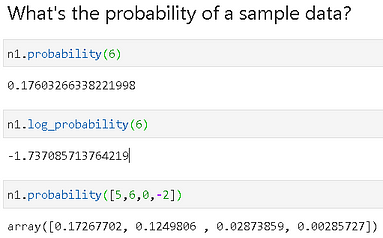
现在,我们可以轻松检查一个样本数据点(或一组数据点)属于该分布的概率,
拟合数据
这里变得更加有趣。使用数据样本进行拟合非常简单且快速。
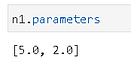
如上初始化后,我们可以检查 n1 对象的参数(均值和标准差)。我们期望它们是 5.0 和 2.0。
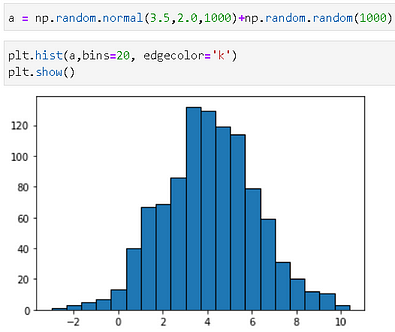
现在,让我们通过向高斯分布添加随机噪声来创建一些合成数据。
我们可以将这个新数据拟合到 n1 对象,然后检查估计的参数。
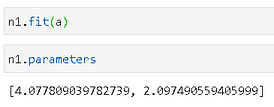
呼!看起来 n1 已经更新了其估计的均值和标准差参数,以匹配输入数据。从图中可以看出,直方图的峰值接近 4.0,而估计的均值也显示了这一点。
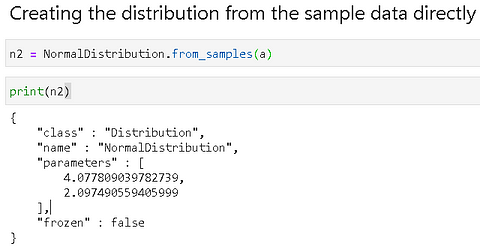
直接从数据样本创建分布
我们展示了如何将数据拟合到一个分布类。或者,可以直接从数据创建对象,
原生支持绘图(直方图)
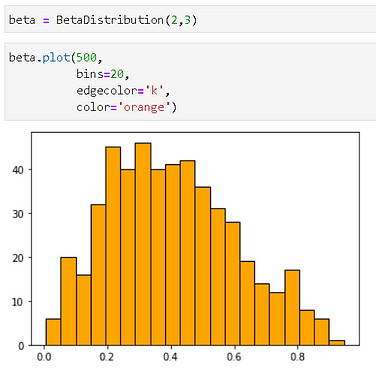
在分布类上使用 `plot()` 方法绘图很简单,该方法还支持 Matplotlib 直方图方法的所有关键字参数。我们通过绘制一个 Beta 分布对象来说明。
离散分布
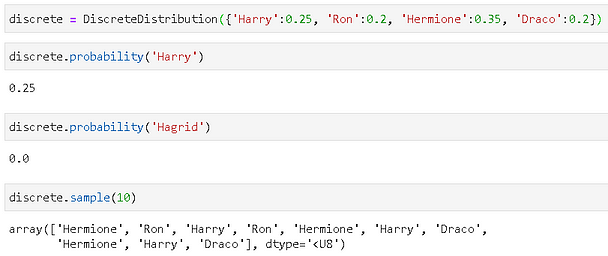
这里变得更加有趣。与向已知统计分布(例如 Normal 或 Beta)传递参数不同,你可以传入一个字典,其中键可以是任意对象,值是对应的概率。
一些霍格沃茨角色的示例。注意,当我们尝试计算‘Hagrid’的概率时,得到的是平坦的零,因为该分布对‘Hagrid’对象没有任何有限概率。
将数据拟合到离散分布
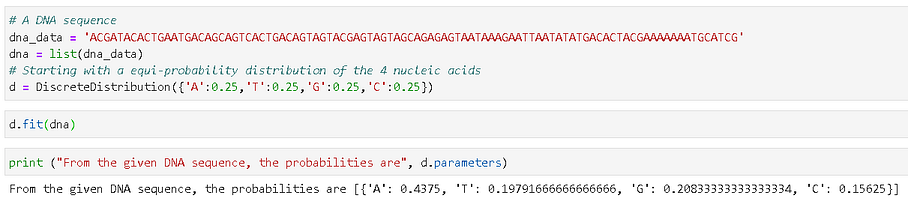
通过将数据拟合到离散分布对象,我们可以做更多有趣的事情。这里有一个虚构 DNA 核酸序列的示例。这种类型的序列数据通常以字符串形式存在,我们可以用简单的代码读取数据并计算序列中四种核酸的概率。
一个简单的 DNA 序列匹配应用
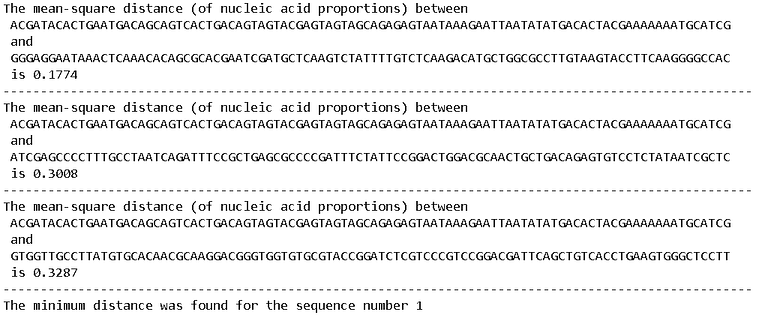
我们只需几行代码就可以编写一个极其简单(且朴素)的 DNA 序列匹配应用。假设核酸频率/概率相似的序列彼此更接近。有些随意地,我们选择计算均方根距离作为该距离度量。
你可以查看 Jupyter notebook 以了解辅助函数和确切代码,但这里是一个示例输出。
高斯混合模型
Pomegranate 让处理来自多个高斯分布的数据变得简单。
让我们创建一些合成数据,
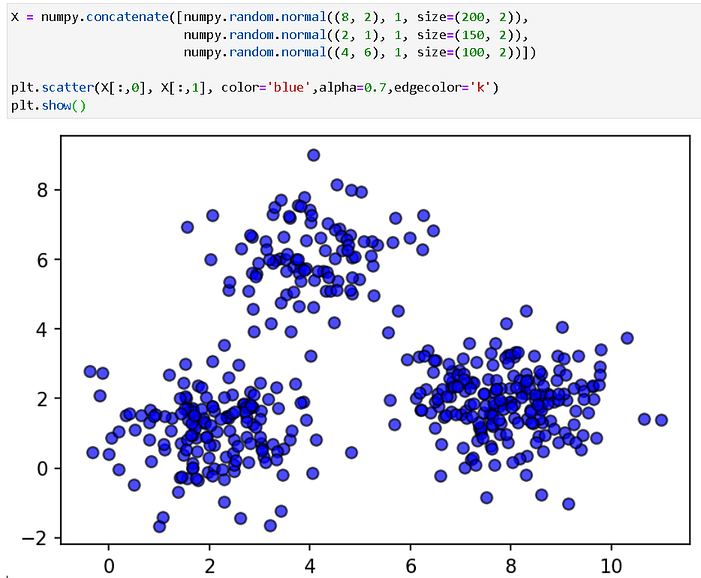
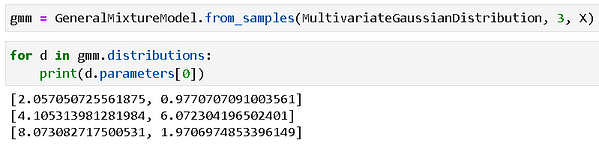
像往常一样,我们可以用一行代码直接从数据中创建模型。当我们打印模型的估计参数时,我们观察到它已经很好地捕捉到了真实值(生成器分布的参数)。
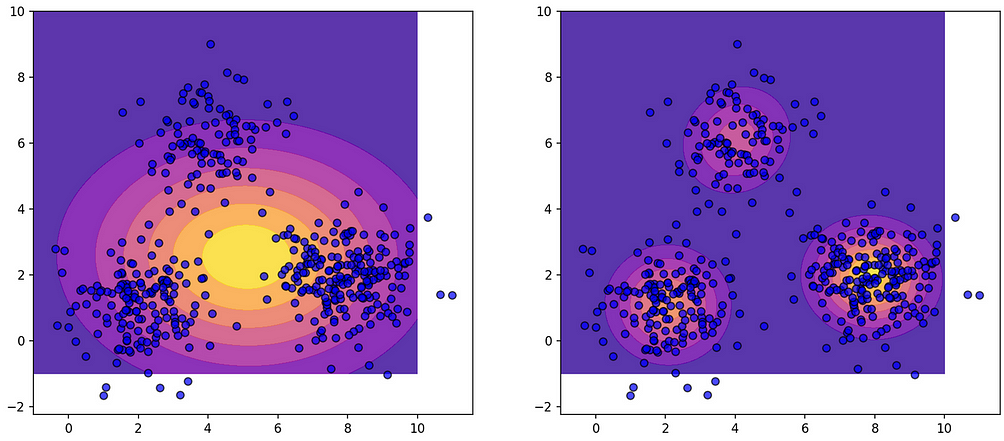
一旦用数据样本生成了模型,我们就可以轻松计算概率并绘制它们。代码在 Notebook 中,这里是说明性图表——左侧显示单个高斯分布,右侧显示混合模型。
马尔可夫链
我们可以用 Pomegranate 轻松建模一个简单的马尔可夫链,并计算任何给定序列的概率。
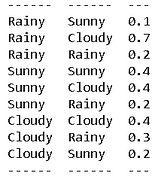
我们将使用经典的雨天-多云-晴天示例。这是转移概率表,
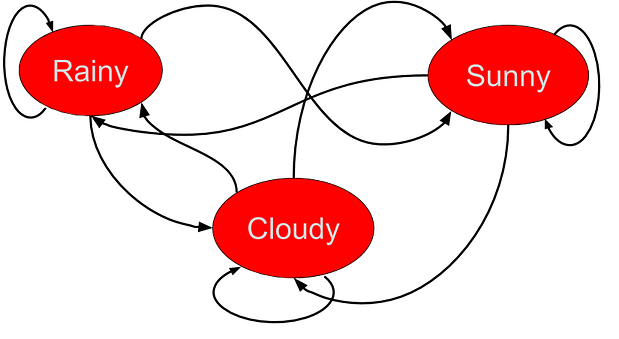
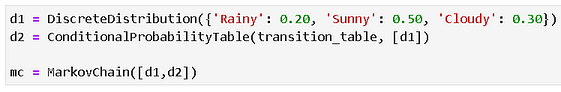
我们还知道,平均而言,有 20% 的雨天、50% 的晴天和 30% 的多云天气。我们将离散分布和转移矩阵都编码在 MarkovChain 类中,
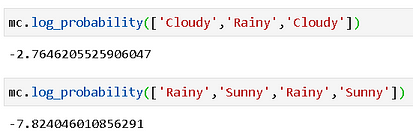
现在,我们可以使用这个对象计算任何给定序列的概率。例如,如果你查看上面的表格,你可以确信像“多云-雨天-多云”这样的序列具有很高的可能性,而像“雨天-晴天-雨天-晴天”这样的序列不太可能出现。我们可以通过精确的概率计算来确认这一点(我们取对数来处理小概率数值),
将数据拟合到 GMM 类
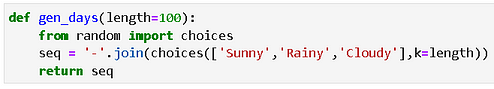
我们编写一个小函数来生成雨天-多云-晴天的随机序列,并将其输入到 GMM 类中。
首先,我们将这些数据用于 14 天的观察——“雨天-晴天-雨天-晴天-雨天-晴天-雨天-雨天-晴天-晴天-晴天-雨天-晴天-多云”。概率转移表为我们计算出来了。
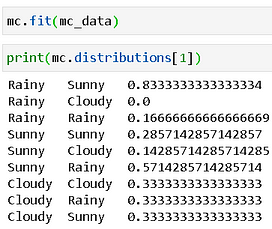
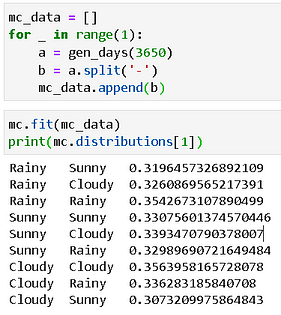
如果我们生成一个10年即3650天的随机序列,那么我们会得到下表。由于我们的随机生成器是均匀的,根据马尔可夫链的特性,转移概率将取极限值,每个约为0.333。
隐马尔可夫模型
使用Pomegranate中的HMM类可以做很多有趣的事情。这里,我们仅展示一个小例子,即使用HMM预测来检测长字符串中子序列的高密度出现。
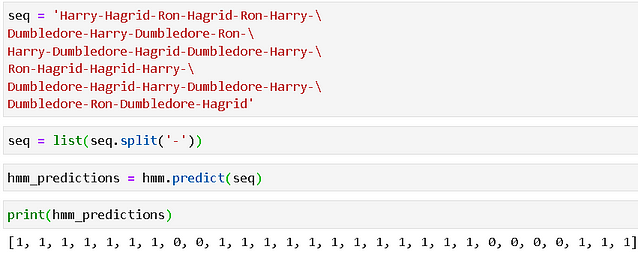
假设我们记录了一本《哈利·波特》小说中四个角色名字在某一章节中依次出现的顺序,我们感兴趣的是检测出哈利和邓布利多同时出现的某些部分。然而,由于他们可能在交谈中提及罗恩或海格的名字,这些部分中的子序列并不纯净,即并不严格包含哈利和邓布利多的名字。
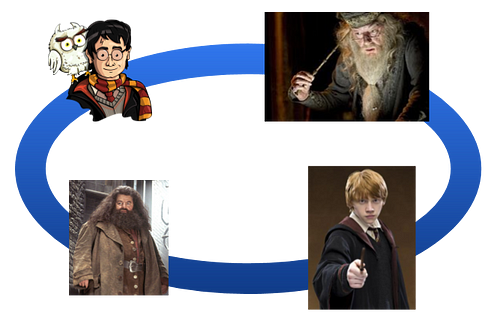
以下代码初始化了一个均匀概率分布、一个偏斜概率分布、两个带有名称的状态,以及包含这些状态的HMM模型。

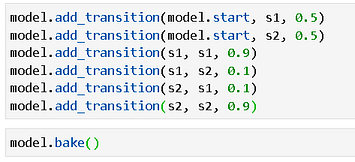
然后,我们需要添加状态转移概率并‘烘焙’模型以最终确定内部结构。注意转移的高自环概率,即状态倾向于以高可能性保持在其当前状态。
现在,我们有一个观测序列,我们将把它作为参数传递给HMM模型的predict方法。将计算转移和发射概率,并预测出一个由1和0组成的序列,其中我们可以注意到0的岛屿,表明‘哈利-邓布利多’共同出现丰富的部分。
总结
在本文中,我们介绍了一个快速且直观的统计建模库Pomegranate,并展示了一些有趣的使用示例。更多教程可以在这里找到。本文中的示例也受到了这些教程的启发。
来自其Github仓库的Pomegranate教程
该库提供了来自各种统计领域的实用类——一般分布、马尔可夫链、高斯混合模型、贝叶斯网络——具有统一的API,可以快速用观测数据实例化,然后用于参数估计、概率计算和预测建模。
你可以查看作者的GitHub仓库,获取机器学习和数据科学方面的代码、想法和资源。如果你像我一样对AI/机器学习/数据科学充满热情,请随时在LinkedIn上添加我或在Twitter上关注我。
Tirthajyoti Sarkar - 高级首席工程师 - 半导体、AI、机器学习 通过写作让数据科学/机器学习概念易于理解
原文 . 经许可转载。
数据分布概述
概率分布之前
比较机器学习模型:统计显著性与实际显著性
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

