Scikit-LLM 将语言模型封装在 scikit-learn 估计器 API(应用程序编程接口) 中,因此它可以原生地嵌入 Pipeline 或交叉验证循环。
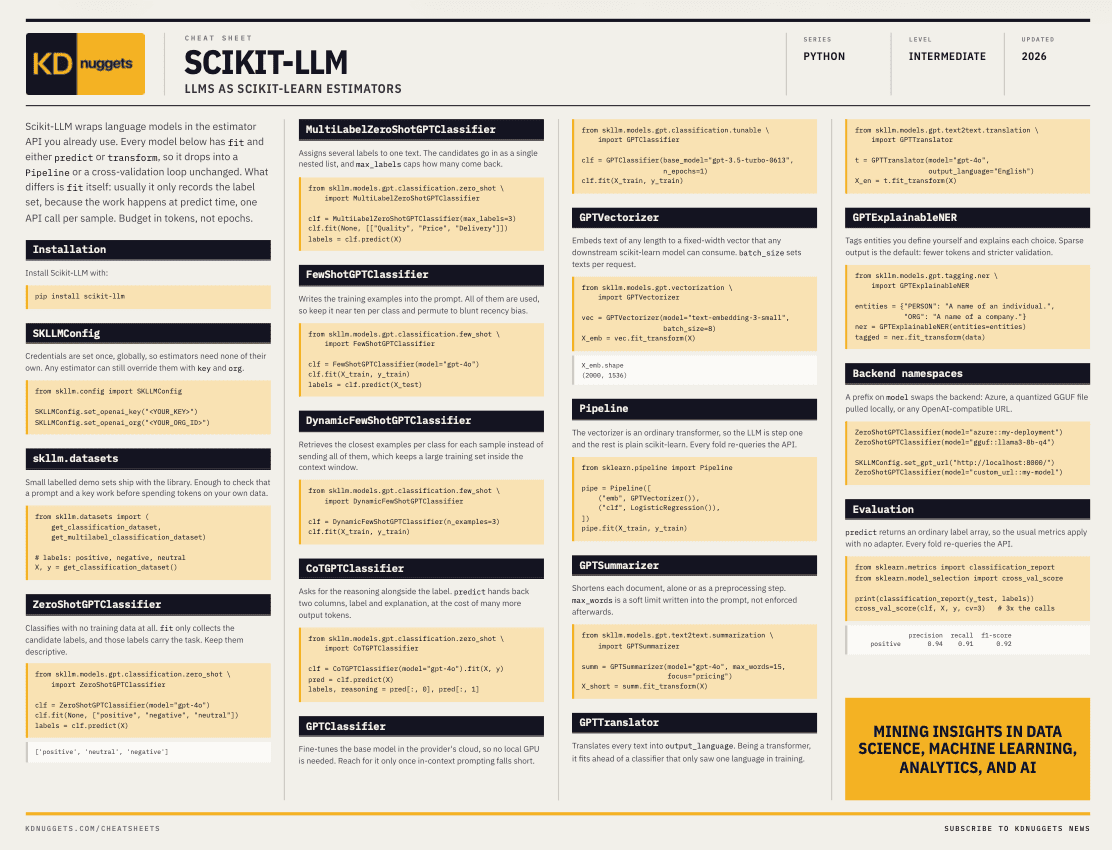
将 LLM 集成到传统机器学习工作流中有两种方式。一种是使用 scikit-learn,配合管道、交叉验证以及最后的指标报告。另一种是写一个满是 API 调用循环、字符串解析,以及用 try/except 包裹响应的脚本——而响应偶尔会以散文而非标签的形式返回。两者都执行分类,但只有第一种提供了值得复用的方法。
Scikit-LLM 弥合了这一差距,它将语言模型封装在你可能已在其他地方使用的 scikit-learn 估计器 API 中。每个模型都有 fit 以及 predict 或 transform,因此它可以原生地嵌入 Pipeline 或交叉验证循环。真正不同的是 fit:它通常只记录标签集,因为实际工作发生在 predict 时,每个样本一次 API 调用。你可以用 token 来思考和规划,这正是这份新速查表所围绕的理念。
你最终可能会最常使用的是 ZeroShotGPTClassifier,我一开始也花了一些时间才弄明白。用 fit(None, [...]) 只传入候选标签,前几次会感觉不对劲,直到你内化这样一个事实:标签就是任务规范。模糊的标签会给出模糊的结果,所以最好把它们当作描述来对待。当零样本不够用时,DynamicFewShotGPTClassifier 是比普通少样本更值得默认选择的,因为它会巧妙地针对每个样本、每个类别检索最接近的示例,而不是把整个训练集塞进每个提示中。
这里还有其他亮点。GPTVectorizer 可以将任意长度的文本转换为固定宽度的向量,因此 LLM 成为管道的第一步,之后的一切都只是普通的 scikit-learn——所以你可以在嵌入上运行逻辑回归。而 GPTTranslator 是一个 transformer,因此它可以被放置在训练时只见过英语的分类器之前,无需在多语言语料上重新训练。
我要强调的一个注意事项是实际涉及的 token 成本。cv=3 的 cross_val_score 意味着三倍的 API 调用,而如果你之前还运行了网格搜索,这个数字还会成倍增加。那些在 scikit-learn 中不花我们任何成本的习惯,在这里并非免费。
记住这一点,scikit-LLM 是加入你 AI 工程工具箱的绝佳工具,尤其是如果你经常使用 scikit-learn。它也是一种很好的方法,让你在不偏离舒适区太远的情况下动手实践。
现在就查看这份新速查表,在你开始使用这个出色的辅助库时随时掌握 scikit-LLM 要点,或作为常规用户的参考。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原创地址:https://www.kdnuggets.com/estimators-in-scikit-llm-a-kdnuggets-cheat-sheet
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

