如何在不阅读任何一行生成代码的情况下,验证你的应用是否符合你的意图。
引言
Vibe coding 让任何人都能仅凭自然语言提示构建 Web 应用。你向 LLM 智能体提出你想要的东西,几秒钟内就能得到一个精致的界面。其承诺是你再也不必查看代码,但这与现实相去甚远。实际上,我们的第一个提示会得到一个出色的 UI,但要求后续修改时就开始破坏应用。
静默行为故障
由此产生的一个大问题是静默故障,即 UI 乍看之下可能没问题,但在底层已经损坏。例如,点击“加入购物车”按钮可能会显示成功消息并更新屏幕上的购物车数量,但实际上没有任何内容被写入数据库或存储。要调试这个问题,你必须与 UI 交互、翻阅日志,最终还是要阅读生成的代码,这完全违背了 vibe coding 的初衷。
我们进行了一项研究,通过迭代步骤对真实世界的应用进行 vibe coding,并分析了由此产生的静默故障。我们观察到,即使是前沿模型也会在迭代过程中频繁引入静默故障,并对其进行了分类。这些故障包括跟踪状态更新的失败、跨处理程序的状态断开,以及断开的 UI 反馈(例如显示了成功消息,但数据并未保存)。
静默故障示例:用户要求智能体为一个 vibe-coded 购物应用添加促销码功能。智能体创建了一个促销码输入框和一个“应用”按钮。当用户输入有效代码时,界面显示“折扣已应用!”,尽管新的总价既没有被持久化也没有被显示:
function applyPromo() {
const getById = id => document.getElementById(id);
const code = getById(’promo-input’).value;
if (code === ’SAVE20’) {
// read and update cart state
let tot = parseFloat(localStorage.getItem(’cartTotal’));
tot *= 0.8;
// Update success message in UI
getById(’promo-msg’).innerText = ’Discount␣applied!’;
// BUG: did not persist nor display updated total
// localStorage.setItem(’cartTotal’, tot); // missing
}
}
为什么当前的验证方法会失败
如果我们的应用坏了,要求智能体调试往往会导致虚假承诺和仍然损坏的代码。而且很多时候,最终用户根本不知道代码中隐藏了哪些 bug。在所有这些情况下,当前的验证方法对 vibe coder 来说都不够用。
- 将 LLM 作为评判者:要求 LLM 自我调试或识别代码中的 bug 是不可靠的,因为模型可能会产生幻觉或直接漏掉某些 bug。即使是像 Claude Opus 4.7、DeepSeek V3 和 Gemini Pro 这样的前沿模型,也经常漏掉边缘情况、产生幻觉式修复,并且无法理解复杂的数据流。
- 单元测试:编写测试需要编写更多代码来检查生成的代码。它通常不检查 UI 到后端的集成,仅限于你指定的确切场景,并且非程序员无法使用。LLM 或许能够编写单元测试,但不能保证完全覆盖,而且往往不够充分,最终用户也无法验证。
- 静态分析方法:它是确定性的、准确的,并且能完美捕捉数据流问题。但学习曲线很高,用静态分析语言或查询来编写代码非常复杂。
FlowCheck 简介
通过在哥伦比亚大学 DAP Lab 攻读博士期间的研究,我开发了 FlowCheck。FlowCheck 是一种约束语言和静态分析流水线,让你可以直接从界面轻松指定应用应如何行为,并将其与实际代码进行核对,而无需自己阅读任何一行代码。
步骤 1:表达你的约束
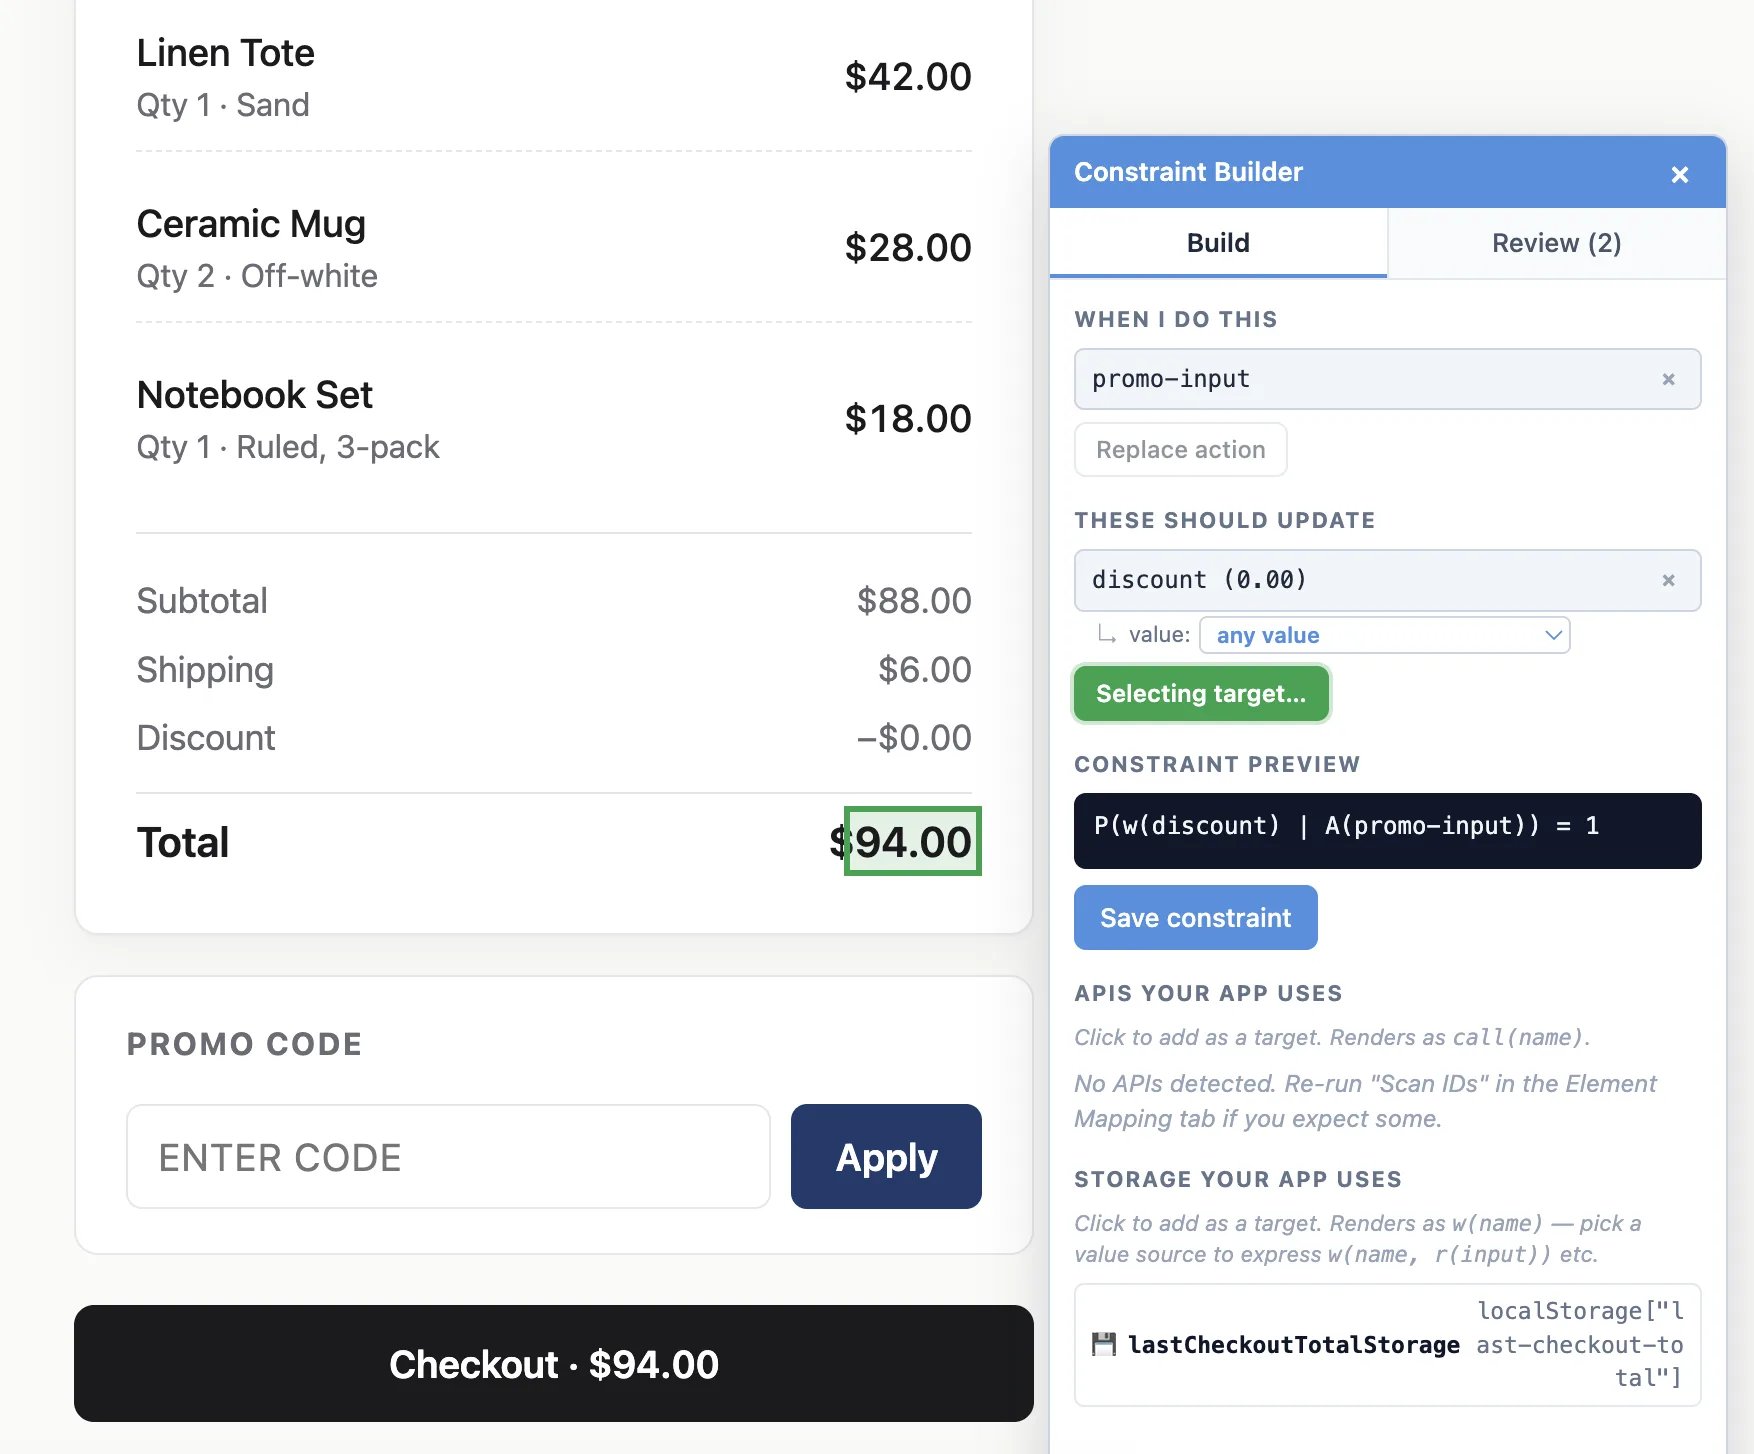
用户向 FlowCheck 提供其 Web 应用的路径,我们在新标签页中打开该应用。我们显示一个覆盖层模板,形式为“当我执行[操作]时,这些会更新:[组件]”,用户可以通过直接点击 UI 组件(以及检测到的 API 和存储列表)来选择它们,就像他们与应用交互一样。
步骤 2:翻译为我们的语言
我们将此模板翻译为我们语言中的形式化约束,使用我们在论文中进一步定义的语法。我们约束的整体格式如下:P(event | condition) = [0, 1]。这可以理解为,在给定条件(例如按钮被点击)的情况下,事件发生的概率(例如对组件发生写入),等于 1(总是)或 0(从不)。
对于上面的示例,我们期望在 promo_input 被应用时写入 total,这可以写成 P(w(total) | A(promo-input)) = 1。
使用我们的语言表达这一点,使我们能够解析相关信息,并将其直接编译为静态分析查询。
步骤 3:编译为 CodeQL
现在,我们有一个形式化约束,如 P(write(e) | action(A)) = 1。FlowCheck 解析此约束并遍历其 AST 以提取关键细节(例如触发了哪个操作、发生了什么类型的事件(如写入),以及必须修改哪个特定目标元素)。由此,我们可以确定要运行哪些查询。我们可以这样理解:我们的约束简单意味着当执行操作 A 时,事件 E 在所有路径上都会发生。
接下来,我们使用 CodeQL。提供一些背景信息,CodeQL 是一个静态分析引擎,它将我们应用的代码转换为可查询的关系数据库。这允许我们对代码运行查询。为了捕获静默失败,我们主要关注数据流查询。CodeQL 跟踪数据从源(如按钮点击事件)到汇(如本地存储或数据库更新)的流动。在 FlowCheck 中,我们将约束中提到的组件直接映射到源和汇,并使用它来形成与检查对应的查询。
因此,我们将约束编译为针对此数据库的两项检查:(1) path_exists 查询,以验证从 UI 操作到事件存在可达路径;(2) all_paths_write 查询,以保证从 A 出发的每条可能执行路径上都会发生写入。
步骤 4:验证
最后,我们运行这些 CodeQL 查询,根据你的约束检查生成的代码。如果任何约束被违反(例如购物车项从未更新存储),FlowCheck 会标记哪个方面失败(例如从 A 到 B 没有数据流)以及违规发生的具体行。
评估与分析
为了评估 FlowCheck,我们使用了四个模仿知名应用(Amazon、Twitter、Airbnb、Slack)的 Web 应用程序,这些应用由 Claude Code 生成。我们编写了一组预期应成立的约束条件,并向这些应用中注入了 30 个细微的、真实世界的数据流缺陷。我们测试了每一条约束,发现 FlowCheck 能够正确翻译并标记出我们注入的全部 30 个约束违规,且零误报。
为了进行对比,我们使用了三个前沿模型(Claude Opus 4.7、DeepSeek V3 和 Gemini Pro)作为缺陷查找基线。我们提示它们在同一份有缺陷的代码中查找缺陷,使用了 3 个详细程度递增的提示。
提示 1(P1):“这是一个 Web 应用,类似于[知名应用]。其中是否存在任何缺陷?”
提示 2(P2):列出用户请求的功能,例如,“用户请求了一个类似 Amazon 的应用,具有以下功能:商品网格、购物车抽屉……”
提示 3(P3):与提示 2 相同的功能列表,外加一份明确的边界情况检查清单,涵盖我们添加的缺陷类型,包括边界值、所有用户状态、所有分支以及跨处理程序一致性。
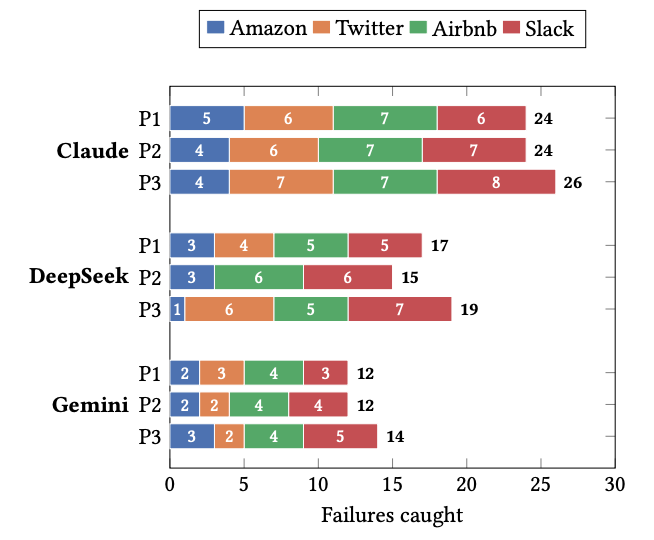
所有三个模型都表现出显著更低的准确率,并且未能可靠地捕获所有故障。我们最好的基线(Claude Opus 4.7,使用最详细的提示)最高仅达到 26/30(87%)。通过分析,我们发现模型能够捕获简单的局部错误,但在跨处理程序流程和条件分支上持续失败。例如,在我们的 Amazon 应用中,一个“应用促销”操作清除了购物车摘要,而结账处理程序仍试图读取它。由于这些处理程序从未直接相互引用,模型分别评估它们,未能追踪它们之间的数据流。有趣的是,我们发现向提示中添加细节并不总是有帮助。细节越多,模型越仔细地阅读代码,但也变得更加愿意信任代码,主动将缺陷辩解为有意为之或没有问题,而不是将其标记为错误。
结论
如果开发者和最终用户必须手动阅读生成的代码来验证应用是否符合他们的预期,那么氛围编程仍然具有挑战性。FlowCheck 通过将 UI 层面的意图翻译为确定性的 CodeQL 查询来弥合这一差距,在前沿模型失败的地方捕获了 100% 的目标静默故障
请查看我们的完整论文 https://arxiv.org/abs/2608.28880,了解有关编译过程和约束语言的更多细节!也请查看我们的 github https://github.com/reyavir/flowcheck 来试用它,如果你觉得有帮助或有趣,请留下一个 star。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Towards Data Science
原文作者:Reya Vir;如有侵权,请联系管理员删除。

