你是否曾经训练过一个你认为很好的模型,但当应用于现实世界数据时却惨遭失败?如果是这样,你并不孤单。机器学习过程复杂,很容易在不明显的情况下导致过拟合。在我从事机器学习的20年左右时间里,我见过许多这样的例子,这促使我撰写了《如何避免机器学习陷阱:学术研究人员指南》,试图防止其他人落入这些陷阱。
但你不必只听我的一面之词。这些问题在科学和大众媒体中越来越多地被报道。例如,有观察指出,在新冠疫情期间开发的数百个模型根本不起作用,以及多伦多部署的一个水质系统经常告诉人们可以在危险的水中沐浴是安全的。其中许多案例记录在AIAAIC存储库中。甚至有人提出,这些机器学习失误正在导致科学界的可重复性危机——而且,鉴于如今许多科学家将机器学习作为关键工具,这导致对已发表科学结果的信任缺失。
在本文中,我将讨论一些可能导致模型看似良好但实际上并非如此的问题。我还会讨论一些防止这类错误的方法,包括使用最近推出的REFORMS检查表来进行基于机器学习的科学研究。
被数据欺骗
误导性数据是一个好的起点,或者更确切地说,不是一个好的起点,因为整个机器学习过程都依赖于用于训练和测试模型的数据。
在最坏的情况下,误导性数据可能导致所谓的“垃圾进,垃圾出”现象;也就是说,你可以训练一个模型,并可能在测试集上获得非常好的性能,但该模型没有实际用途。这方面的例子可以在前面提到的Roberts等人对Covid预测模型的综述中找到。在急于开发Covid预测工具的过程中,许多公共数据集变得可用,但后来发现这些数据集包含误导性信号——如重叠记录、错误标记和隐藏变量——所有这些都帮助模型准确预测类别标签,而在此过程中没有学到任何有用的东西。
以隐藏变量为例。这些是数据中存在的特征,它们恰好能预测数据中的类别标签,但与类别标签没有直接关系。如果你的模型在训练过程中抓住了这些特征,它看起来会工作得很好,但在新数据上可能不起作用。例如,在许多Covid胸部影像数据集中,身体的方向是一个隐藏变量:生病的人更可能是躺着扫描的,而站立的人往往健康。由于许多Covid机器学习模型学到了这个隐藏变量,而不是疾病的真实特征,结果它们擅长预测姿势,却不擅长预测Covid。尽管名字叫隐藏变量,但这些变量往往就在眼前,并且有许多分类器抓住图像中嵌入的边界标记、水印和时间戳的例子,这些通常用于区分一个类别与另一个类别,而无需查看实际数据。
一个相关问题是虚假相关性的存在。与隐藏变量不同,这些与数据中的其他任何东西都没有真正的关系;它们只是恰好与类别标签相关的模式。一个经典的例子是坦克问题,据称美国军方试图训练一个神经网络来识别坦克,但它实际上识别的是天气,因为所有坦克的照片都是在一天中的同一时间拍摄的。考虑下面的图像:一个机器学习模型只需查看图像顶部像素的颜色,就可以识别出这个数据集中所有坦克的图片,而无需考虑任何物体的形状。模型的性能看起来很棒,但在实践中完全无用。
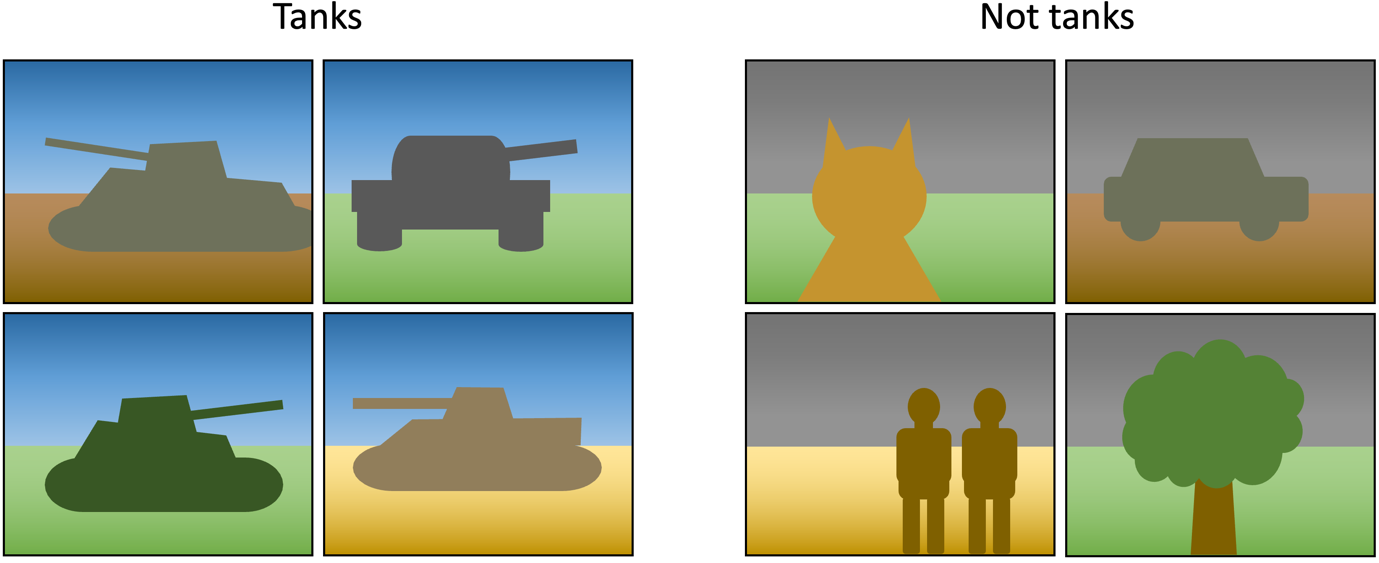
许多(也许是大多数)数据集包含虚假相关性,但它们通常不像这个例子那么明显。例如,常见的计算机视觉基准已知存在与类别标签虚假相关的背景像素组。这对深度学习器构成了特殊挑战,因为它们有能力对数据中的许多模式进行建模;各种研究表明,它们确实倾向于捕捉虚假相关的模式,这降低了它们的泛化能力。对对抗性攻击的敏感性就是其后果之一:如果一个深度学习模型基于图像背景像素中的虚假相关性进行预测,那么对这些像素进行微小更改就可以翻转模型的预测。对抗性训练,即在训练过程中让模型接触对抗性样本,可以用来解决这个问题,但成本很高。一个更简单的方法是查看你的模型,看看它使用什么信息来做出决策。例如,如果可解释AI技术生成的显著性图表明你的模型关注背景中的某些东西,那么它可能不会很好地泛化。
有时问题不在于数据本身,而在于数据的标记。当数据由人类标记时尤其如此,标签最终会捕捉到标记者的偏见、错误假设或仅仅是老式的错误。这方面的例子可以在用作图像分类基准的数据集中看到,如MNIST和CIFAR,它们通常有百分之几的错误标记率——不是很多,但在建模者争夺百分之零点几的准确率时相当重要。也就是说,如果你的模型比竞争对手稍好,是因为实际的改进,还是因为对标记过程中的噪声进行了建模?当处理具有隐含主观性的数据时,事情可能更加麻烦,例如情感分类,存在过拟合特定标记者的危险。
被泄漏引导
坏数据不是唯一的问题。在机器学习流程的后续阶段有很多出错的空间。一个常见的问题是数据泄漏。当模型训练流程能够访问它不应该访问的信息时,就会发生这种情况,特别是那些给模型带来优势的信息。大多数时候,这表现为来自测试数据的信息泄漏——虽然大多数人都知道测试数据应该保持独立,不应在训练中明确使用,但有各种微妙的方式可能导致信息泄漏。
一个例子是在划分出测试数据之前,对整个数据集执行依赖数据的预处理操作。也就是说,利用通过查看所有数据而学到的信息来对所有数据进行更改。这类操作从简单的(如对数值特征进行中心化和缩放)到复杂的(如特征选择、降维和数据增强)不等——但它们的共同点是都利用整个数据集的知识来指导其结果。这意味着测试数据的知识隐式地进入了模型训练流程,即使它没有被显式地用于训练模型。因此,从测试集得出的任何性能度量都可能高估模型的真实性能。
让我们考虑最简单的例子:中心化和缩放。这涉及查看每个特征的范围,然后利用这些信息重新缩放所有值,通常使均值为0、标准差为1。如果在划分出测试数据之前对整个数据集执行此操作,那么训练数据的缩放将包含关于测试集中特征值范围和分布的信息。如果测试集的范围比训练集更宽,这尤其成问题,因为模型可能从训练数据中存在的截断值范围推断出这一事实,并通过预测高于或低于训练期间所见值的值来在测试集上表现良好。例如,如果你正在处理基于时间序列数据的股票价格预测,模型接受的输入范围是0到1,但在训练期间只看到0到0.5范围内的值,那么它不难推断出股票价格未来会上涨。
事实上,预测是机器学习中特别容易受到数据泄露影响的领域,这是由于一种称为前视偏差(look ahead bias)的现象。当模型不应访问的信息从未来泄露并人为地提高其在测试集上的性能时,就会发生这种情况。这通常发生在训练集包含比测试集时间上更靠前的样本时。我稍后会给出一个可能发生这种情况的例子,但如果你从事这一领域,我也强烈建议你看看这篇关于时间序列预测模型评估中陷阱和最佳实践的优秀综述。
一个更复杂的依赖数据的预处理操作导致过于乐观的性能指标的例子可以在这篇关于早产预测模型的综述中找到。基本上,许多论文报告了预测婴儿是否会早产的高准确率,但事实证明,所有这些论文都在划分出测试数据之前对数据集应用了数据增强。这导致测试集包含训练数据的增强样本,训练集包含测试数据的增强样本——这构成了相当严重的数据泄露。当综述作者纠正这一点后,模型的预测性能从近乎完美下降到比随机猜测好不了多少。
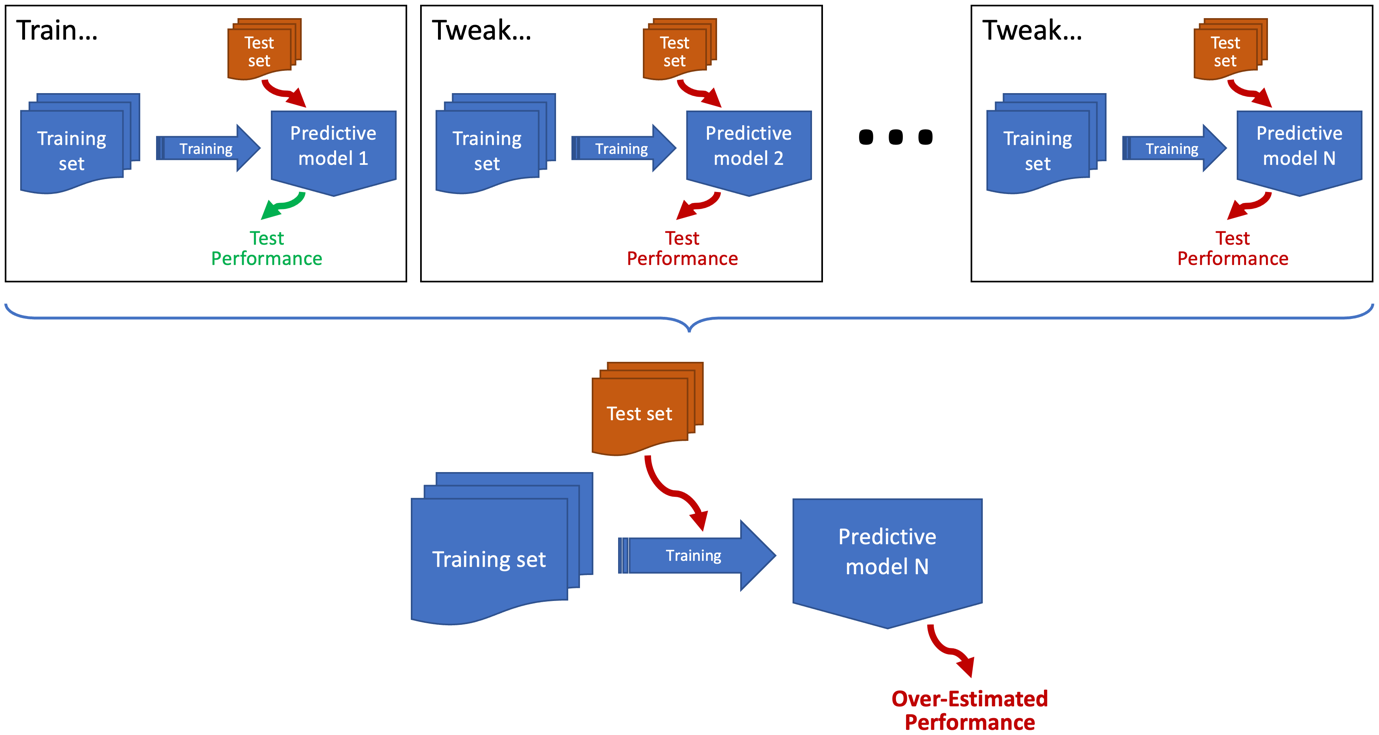
奇怪的是,最常见的数据泄露例子之一没有公认的名称(有人建议使用过度炒作和顺序过拟合这两个术语),但本质上是一种对测试集训练的形式。举例来说,想象上面描述的场景:你训练了一个模型并在测试集上评估了它。然后你决定其性能低于你的期望。于是,你调整了模型,然后重新评估。你仍然不满意,所以你一直这样做,直到它在测试集上的性能足够好。听起来很熟悉?嗯,这是一件很常见的事情,但如果你在迭代开发模型并使用相同的测试集在每次迭代后评估模型,那么你基本上是在使用该测试集来指导模型的开发。最终结果是你会过拟合测试集,并且可能得到对模型泛化能力的过于乐观的度量。
有趣的是,当人们使用社区基准(如MNIST、CIFAR和ImageNet)时,也会发生同样的过程。几乎所有从事图像分类工作的人都使用这些数据集来基准测试他们的方法;因此,随着时间的推移,对这些基准产生一定程度的过拟合是不可避免的。为了缓解这一点,始终建议使用多样化的基准选择,理想情况下在其他未使用过的数据集上尝试你的技术。
被指标误导
一旦你稳健地构建了模型,你就需要稳健地评估它。这里也有很多可能出错的地方。让我们从不恰当的指标选择开始。经典的例子是在不平衡数据集上使用准确率。想象一下,你设法训练了一个模型,无论输入如何,它总是预测相同的标签。如果一半的测试样本以该标签为真实标签,那么你将获得50%的准确率——这没问题,对于差分类器来说是差的准确率。如果90%的测试样本具有该标签,那么你将获得90%的准确率——对于差分类器来说是好的准确率。这种程度的不平衡在现实世界的数据集中并不罕见,而在处理不平衡的训练集时,得到总是预测多数类标签的分类器也并不罕见。在这种情况下,使用F分数或马修斯相关系数等指标会好得多,因为它们对类别不平衡不太敏感。然而,所有指标都有其弱点,所以最好使用一组指标组合,从不同角度反映模型的性能和失败模式。
时间序列预测的指标尤其麻烦。有很多指标可供选择,最合适的选择可能取决于具体的问题领域和时间序列数据的确切性质。与用于分类的指标不同,时间序列预测中使用的许多回归指标没有自然尺度,这意味着原始数字可能具有误导性。例如,均方误差的解释取决于时间序列中存在的值范围。因此,除了适当的指标外,使用适当的基线也很重要。作为一个例子,这篇(已经提到的)关于时间序列预测陷阱的综述展示了在顶级AI会议上发表的许多深度学习模型实际上不如朴素基线模型。例如,他们展示了一个autoformer——一种为时间序列预测设计的复杂transformer模型——可以被一个预测下一时间步无变化的简单模型击败——仅从指标上看是不明显的。
总的来说,有一种趋势是开发越来越复杂的模型来解决困难的问题。然而,重要的是要记住,有些问题可能无法解决,无论模型变得多么复杂。许多金融时间序列预测问题可能就是这样。预测某些自然现象时也是如此,特别是那些由于混沌成分而无法在某个时间范围之外进行预测的现象。例如,许多人认为地震无法预测,然而有大量论文报告在这一任务上表现良好。这篇综述论文讨论了这些正确预测可能是由于一系列建模陷阱,包括不恰当的基线选择以及由于数据稀疏、不必要的复杂性和数据泄露导致的过拟合。
另一个问题是假设单次评估足以衡量模型的性能。有时确实如此,但很多时候你会处理随机或不稳定的模型;因此,每次训练它们时,你都会得到不同的结果。或者你可能正在处理一个小数据集,其中你可能只是幸运地遇到了一个简单的测试分割。为了应对这两种情况,通常使用重采样方法,如交叉验证,它在数据的不同子集上训练和测试模型,然后计算出平均性能。然而,重采样引入了自身的风险。其中之一是数据泄露风险增加,特别是当假设依赖于数据的预处理操作(如居中和缩放以及特征选择)只需执行一次时。它们不需要;它们需要在重采样过程的每次迭代中独立执行,否则可能导致数据泄露。下面是一个例子,展示了特征选择应如何在交叉验证的前两次迭代中使用的两个训练集(蓝色)上独立进行,以及这如何导致每次选择不同的特征。
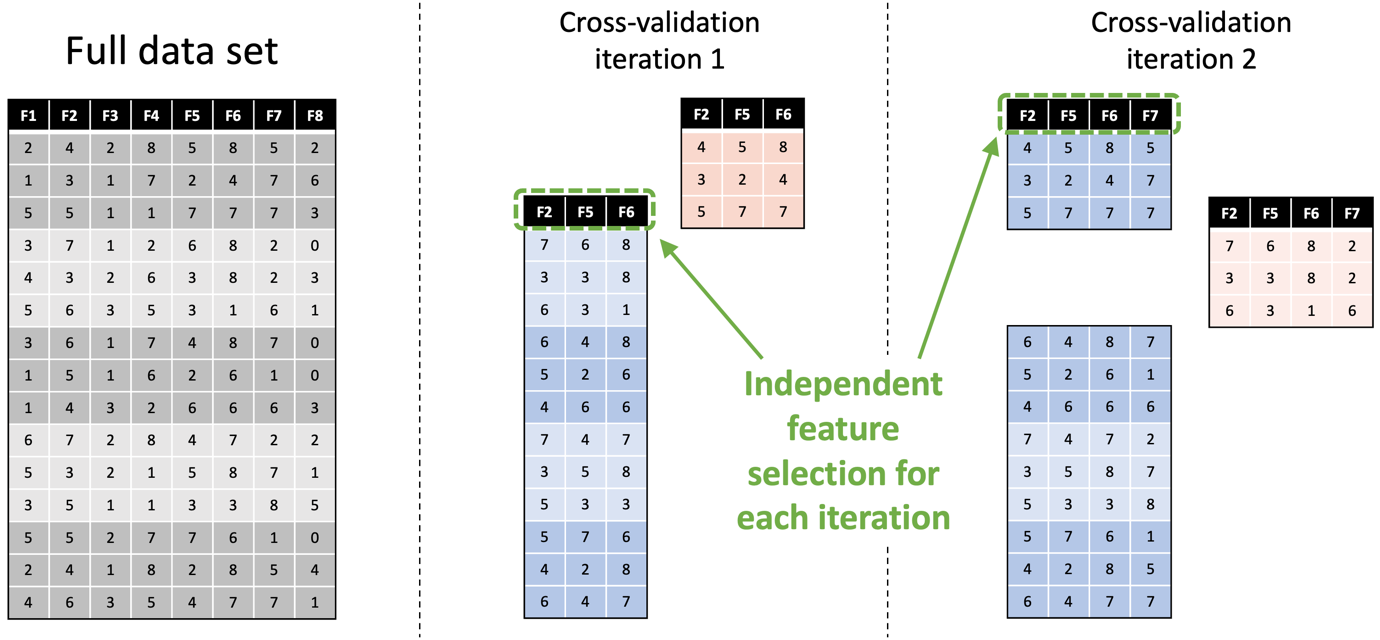
正如我之前提到的,在处理时间序列数据时,数据泄露的危险更大。使用标准交叉验证,除了一个迭代外,每个迭代都会涉及至少一个训练折,其时间上比测试折中的数据更靠后。例如,如果你想象上图中的数据行代表按时间排序的多变量样本,那么两个迭代中使用的测试集(粉色)在时间序列中出现得比全部或部分训练数据更早。这是一个前视偏差的例子。可以使用替代方法,如块交叉验证,来防止这些情况。
多次评估并非对每个人都可行。例如,训练一个基础模型既耗时又昂贵,因此重复进行不可行。根据你的资源,即使是相对较小的深度学习模型也可能如此。如果是这样,那么也考虑使用其他方法来衡量模型的鲁棒性。这包括使用可解释性分析、进行消融研究或增强测试数据。这些可以让你超越可能具有误导性的指标,并了解模型如何工作以及可能如何失败,这反过来可以帮助你决定是否在实践中使用它。
深入探索
到目前为止,我主要讨论了通用的机器学习流程,但在使用深度学习模型时,陷阱可能更大。考虑潜在空间模型的使用。这些模型通常与使用它们的预测模型分开训练。也就是说,训练一个像自编码器这样的东西来进行特征提取,然后在训练下游模型时使用这个模型的输出,这并不罕见。这样做时,必须确保下游模型中使用的测试集不与自编码器中使用的训练数据相交——这在使用交叉验证或其他重采样方法时很容易发生,例如当使用不同的随机分割或未选择在相同训练折上训练的模型时。
然而,随着深度学习模型变得更大更复杂,确保这些类型的数据泄露不发生可能更难。例如,如果你使用预训练的基础模型,可能无法判断你的测试集中使用的数据是否用于训练基础模型——特别是如果你使用来自互联网的基准数据来测试你的模型。如果你使用复合模型,情况会更糟。例如,如果你在微调一个GPT类型的基础模型时使用一个BERT类型的基础模型来编码输入,你必须考虑用于训练这两个基础模型的数据集与你自己的微调数据之间的任何交集。在实践中,其中一些数据集可能是未知的,这意味着你无法确信你的模型是正确泛化还是仅仅复制了预训练期间记忆的数据。
避免陷阱
这些陷阱太常见了。那么,避免它们的最佳方式是什么?嗯,你可以做的一件事是使用检查清单,这基本上是一个正式文档,带你了解机器学习流程中的关键痛点,并帮助你识别潜在问题。在涉及高风险决策的领域,如医学,已经有许多成熟的检查清单,如CLAIM,并且在这些领域发表的期刊通常会强制执行这些清单。
然而,我想简要介绍一个新事物:REFORMS,一个基于共识的检查清单,用于进行基于机器学习的科学。这是由19位来自计算机科学、数据科学、数学、社会科学和生物医学科学的研究人员——包括我自己——共同制定的,源于最近一次关于基于ML的科学中可重复性危机的研讨会。它旨在以更领域无关的方式解决机器学习流程中出现的常见错误,包括本文中提到的许多错误。它由两部分组成:检查清单本身,以及一个配对的指导文档,解释每个检查清单项为什么重要。检查清单贯穿基于机器学习的研究的主要组成部分,在每种情况下鼓励用户验证机器学习过程的设计方式是否支持研究的总体目标、是否不会陷入任何常见陷阱,并使结果能够由独立研究人员验证。虽然它专注于机器学习在科学背景下的应用,但它涵盖的许多内容更普遍适用,所以我鼓励你看看,即使你不认为你的工作是“科学”。
避免陷阱的另一种方式是更好地利用工具。现在,我对当前机器学习状态的一个主要抱怨是,常用工具几乎无法防止你犯错误。也就是说,它们会乐意让你以各种方式滥用机器学习流程,而不告诉你做错了什么。尽管如此,帮助以实验跟踪框架的形式存在,这些框架自动记录你训练的模型以及你如何训练它们,这对于发现数据泄露和训练到测试集等问题很有用。一个开源选项是MLFlow,但有很多商业产品。MLOps工具更进一步,帮助管理机器学习工作流中的所有变动部分,包括人员。
最终思考
训练一个能很好地泛化到未见数据的优秀模型是可能的,但除非你确信没有任何可能出错的地方出错,否则我不会相信这一点。健康的怀疑感是好事:一定要查看你训练的模型,确保它在做合理的事情,一定要分析你的指标以了解它在何处犯错,一定要将你的结果与适当的基线进行校准,并一定要考虑使用检查清单来确保你没有忽略重要的事情。
Michael 是爱丁堡赫瑞瓦特大学的副教授。他过去大约 20 年一直从事机器学习和仿生计算的研究。更多信息请参见他的学术网站。他还在其 Fetch Decode Execute substack 中更广泛地撰写关于计算机科学的文章。
引用
在学术语境或书籍中引用时,请按以下方式引用本作品
Michael Lones, "Why Doesn’t My Model Work?", The Gradient, 2024.@article{lones2024why,
author = {Michael Lones},
title = {Why Doesn’t My Model Work?},
journal = {The Gradient},
year = {2024},
howpublished = {\url{https://thegradient.pub/why-doesnt-my-model-work},
}转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:The Gradient
原文作者:Michael Lones;如有侵权,请联系管理员删除。

