现代云应用程序通常构建为一组松散耦合的微服务,运行在 Amazon Elastic Kubernetes(容器编排平台) Service(Amazon EKS)、Amazon Elastic Container Service(Amazon ECS)或 AWS Lambda 等服务上。这种架构为工程团队提供了灵活性和可扩展性,但其固有的分布式特性也使得故障排查更加困难。当出现问题时,工程师往往需要翻阅分散在不同可观测性层中的日志、事件和指标。以 Kubernetes 为例,如果对服务缺乏深入理解,故障排查可能会变成一项耗时的工作,需要手动关联来自不同来源的信息。
在本文中,我们将介绍如何为 Kubernetes 构建一个由生成式 AI 驱动的故障排查助手。目标是让工程师能够以更快速、自助的方式诊断和解决集群问题,缩短平均恢复时间(MTTR),并减少专家在复杂分布式系统中寻找问题根因所花费的周期。
概述
构建现代云应用程序的挑战之一是在众多动态组件之间保持可观测性的完整性。任何曾经在一个终端中跟踪日志、同时在另一个终端中运行 kubectl describe 和 curl 命令的人都知道这有多繁琐。分布式系统功能强大,但也十分复杂。以 Kubernetes 为例,它提供了强大的编排能力,但在集群内部进行故障排查往往意味着要穿越多层抽象,如 Pod、节点、网络、日志和事件。除此之外,系统还会产生大量遥测数据,包括 kubelet 日志、应用程序日志、集群事件和指标。要理解这些层次,既需要系统方面的专业知识,也需要应用程序知识。
这种技能差距在数据中有所体现。根据《2024 年可观测性脉搏报告》,48% 的组织表示团队知识不足是他们在云原生环境中实现可观测性的最大挑战。MTTR 也已连续三年上升,大多数团队(82%)表示解决生产问题可能需要超过一个小时。
当出现问题、应用程序因未知原因开始失败时,工程师往往必须开始从多个来源拼接信号以找到根因。这对专家来说可能很繁琐,而当问题间歇性出现或跨服务时,情况会更糟。通常需要多个团队参与——应用程序工程师可能不太了解 Kubernetes,而平台团队可能对应用程序缺乏深入洞察。这可能导致更长的故障排查周期、潜在的用户体验下降,并使工程师偏离推动业务目标的计划工作。
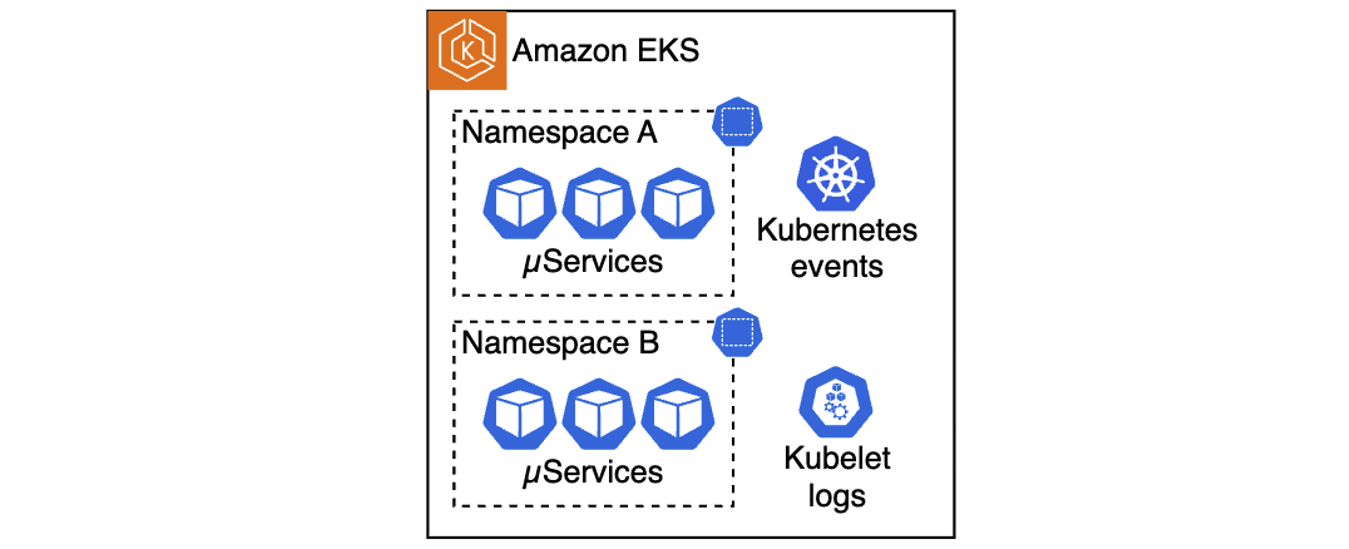
这正是生成式人工智能(AI)可以发挥作用的地方。用户可以构建一个 AI 助手,将大语言模型(LLM(大语言模型))驱动的分析和指导与现有遥测数据相结合。该助手使工程师能够以自助方式更快地排查问题,而无需每个团队都成为 Kubernetes 专家。在以下章节中,我们将展示如何为 Amazon EKS 构建这样一个助手,但请记住,类似的方法可以扩展到其他计算服务,如 Amazon ECS 或 AWS Lambda。
解决方案架构
构建这个 AI 驱动的故障排查助手包含三个主要部分:
部署方式选择:该解决方案支持两种架构——传统的基于检索增强生成(RAG(检索增强生成))的聊天机器人,以及基于 Strands 的现代智能体系统,后者使用 Strands Agents SDK(软件开发工具包) 并集成 EKS MCP Server 以直接访问 EKS API(应用程序编程接口)。
遥测数据收集与存储:从各种来源收集遥测数据,并将其作为向量嵌入存储在 Amazon OpenSearch 中(RAG 方式),或作为 1024 维嵌入存储在 Amazon S3 Vectors 中(Strands 方式)。
交互式故障排查界面:构建基于 Web 的聊天机器人,检索相关遥测数据并将其注入 LLM 提示中;或构建 Slack 集成的多智能体系统,使用 MCP 工具进行实时 Kubernetes 诊断。
在本架构演练中,我们聚焦于基于 RAG 的方法。第一步是搭建一条能够可靠收集、处理和存储遥测数据的管道。该管道从相关数据源(如应用程序日志、kubelet 日志和 Kubernetes 事件)聚合遥测数据。在 Kubernetes 环境中,这可以通过遥测处理器和转发器(如 Fluent Bit)来实现,它将遥测数据流式传输到 Amazon Kinesis Data Streams。在接收端,我们使用 Lambda 函数对收集到的数据进行规范化处理,使用 Amazon Bedrock 生成向量嵌入,并使用 OpenSearch Serverless 存储这些嵌入表示以实现高效检索。由于这些服务都是无服务器的,我们可以避免管理基础设施的开销,专注于故障排查工作流本身。
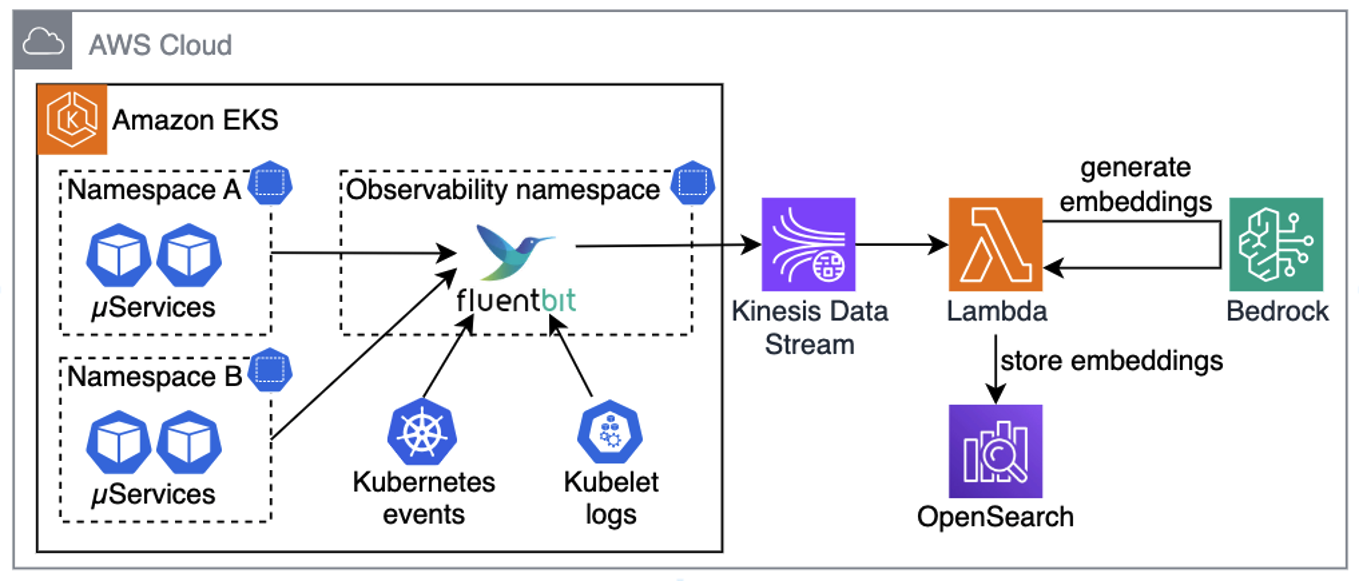
专业提示:为了获得更好的性能和成本效益,您的 Lambda 函数在从 Kinesis 摄取数据、生成嵌入并将其存储到 OpenSearch 时,应使用批处理。
一旦遥测数据被收集、转换为嵌入并存储到 OpenSearch 中,下一步就是构建一个使用 RAG 的聊天机器人。使用 RAG 意味着当用户提问时,聊天机器人会在 OpenSearch 中查找语义相似的遥测数据,将其添加到提示中,然后发送给 LLM。模型不再给出通用答案,而是拥有相关的遥测数据和集群特定细节,可以用来生成有用的后续步骤,例如为故障排查助手提供精确的 kubectl 命令,如下图所示。
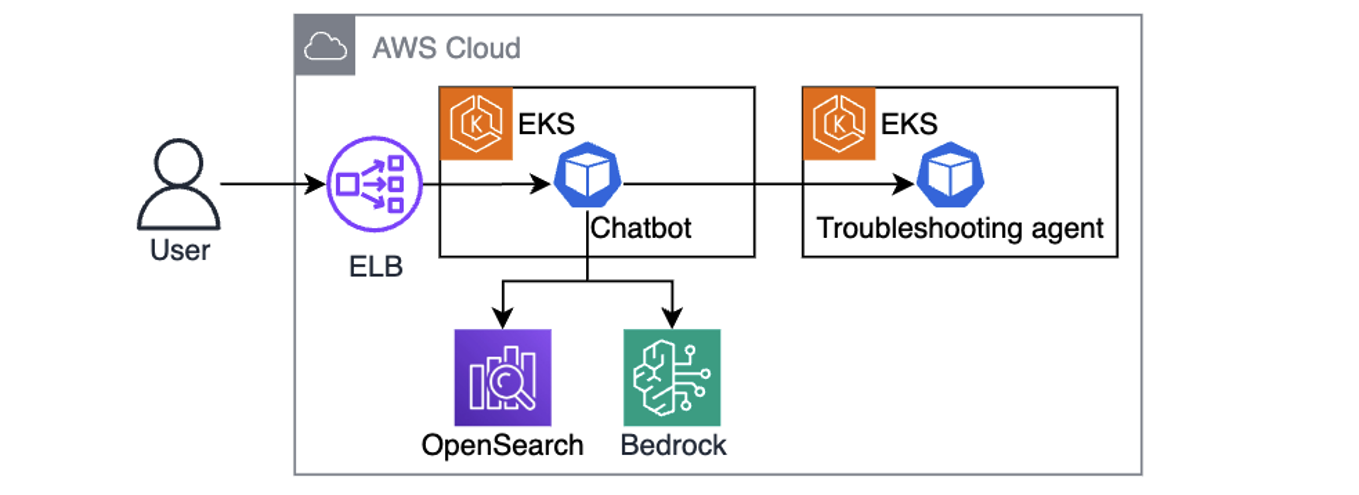
这种设计的一个强大之处在于其迭代特性。聊天机器人将指令传递给运行在集群中的故障排查助手,后者执行一组允许列表中的只读 kubectl 命令。输出返回给 LLM,LLM 可以决定是否需要进一步调查(通过要求故障排查助手运行更多 kubectl 命令),或者向工程师呈现清晰的解决方案路径。这个循环通过结合历史遥测数据和实时集群状态,逐步构建出更丰富的问题图景,从而加速根因分析。
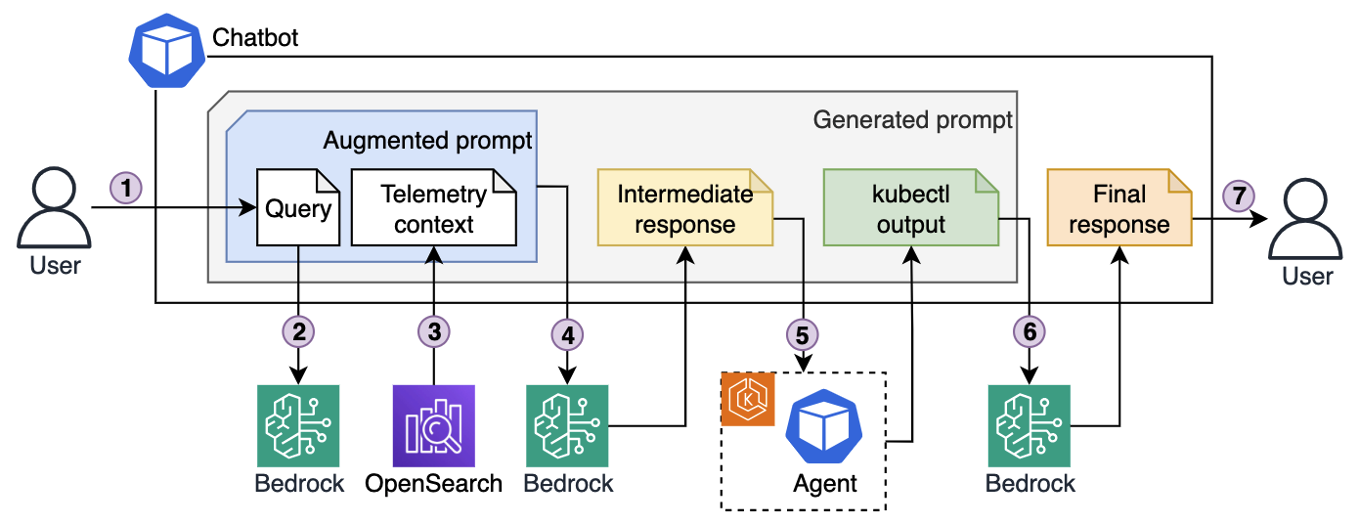
上图所示的端到端故障排查流程:
工程师在聊天机器人界面中输入查询,例如“我的 Pod 卡在 Pending 状态。请调查。”
聊天机器人将查询发送给 Bedrock,后者将其转换为向量嵌入。
使用这些嵌入,聊天机器人检索之前存储在 OpenSearch 中的语义匹配遥测数据。
聊天机器人生成一个增强提示,其中包含原始查询和语义相关的遥测数据,并将其传递给 LLM。LLM 返回一组用于进一步诊断的 kubectl 命令。
聊天机器人将这些命令转发给运行在 EKS 集群中的故障排查助手。智能体使用具有只读权限的服务账户执行这些命令,遵循最小权限原则,并将输出发送回来。
基于输出,聊天机器人要求 LLM 决定是继续调查(通过要求智能体运行更多命令),还是已有足够的上下文来生成答案。
一旦收集到足够的信息(调查结束),聊天机器人会组合一个最终提示,包括查询、遥测数据和调查结果,并要求 LLM 给出最终解决方案,然后将其返回给工程师。
示例实现
使用示例仓库在您的 AWS 账户中部署该解决方案。按照 README.md 中的说明,使用 Terraform 配置和测试示例项目。示例项目所配置的资源会在您的 AWS 账户中产生费用。请务必按照 README.md 中的说明清理项目,以避免意外费用。
该仓库提供了两种部署架构,由 deployment_type Terraform 变量控制:
基于 RAG 的部署(默认):请参阅 ./terraform/modules 目录中的“ingestion-pipeline”模块,该模块创建一个 Kinesis Data Stream 和一个 Lambda 函数,使用 "amazon.titan-embed-test-v2:0" 生成嵌入并将其存储到 OpenSearch 中。“agentic-chatbot”模块负责处理 Gradio Web 界面和 kubectl 命令执行。
Strands 智能体部署:此方法使用 Strands Agents SDK 创建一个多智能体系统,包含三个专门的智能体:Agent(智能体) Orchestrator:协调故障排查工作流;Memory Agent:管理对话上下文和历史洞察;K8s Specialist:处理 Kubernetes 诊断。
该智能体系统将知识以 1024 维嵌入的形式存储在 Amazon S3 Vectors 中,为 AI 智能体提供成本优化的向量存储。EKS MCP Server 集成通过位于 ./apps/agentic-troubleshooting/src/tools/ 中的标准化 MCP 工具实现了对 EKS API 的直接访问。工程师通过 Slack 机器人集成进行交互,Strands 智能体可以通过 MCP 协议执行 kubectl 命令,同时保持 Pod Identity 安全性以访问 AWS 服务。
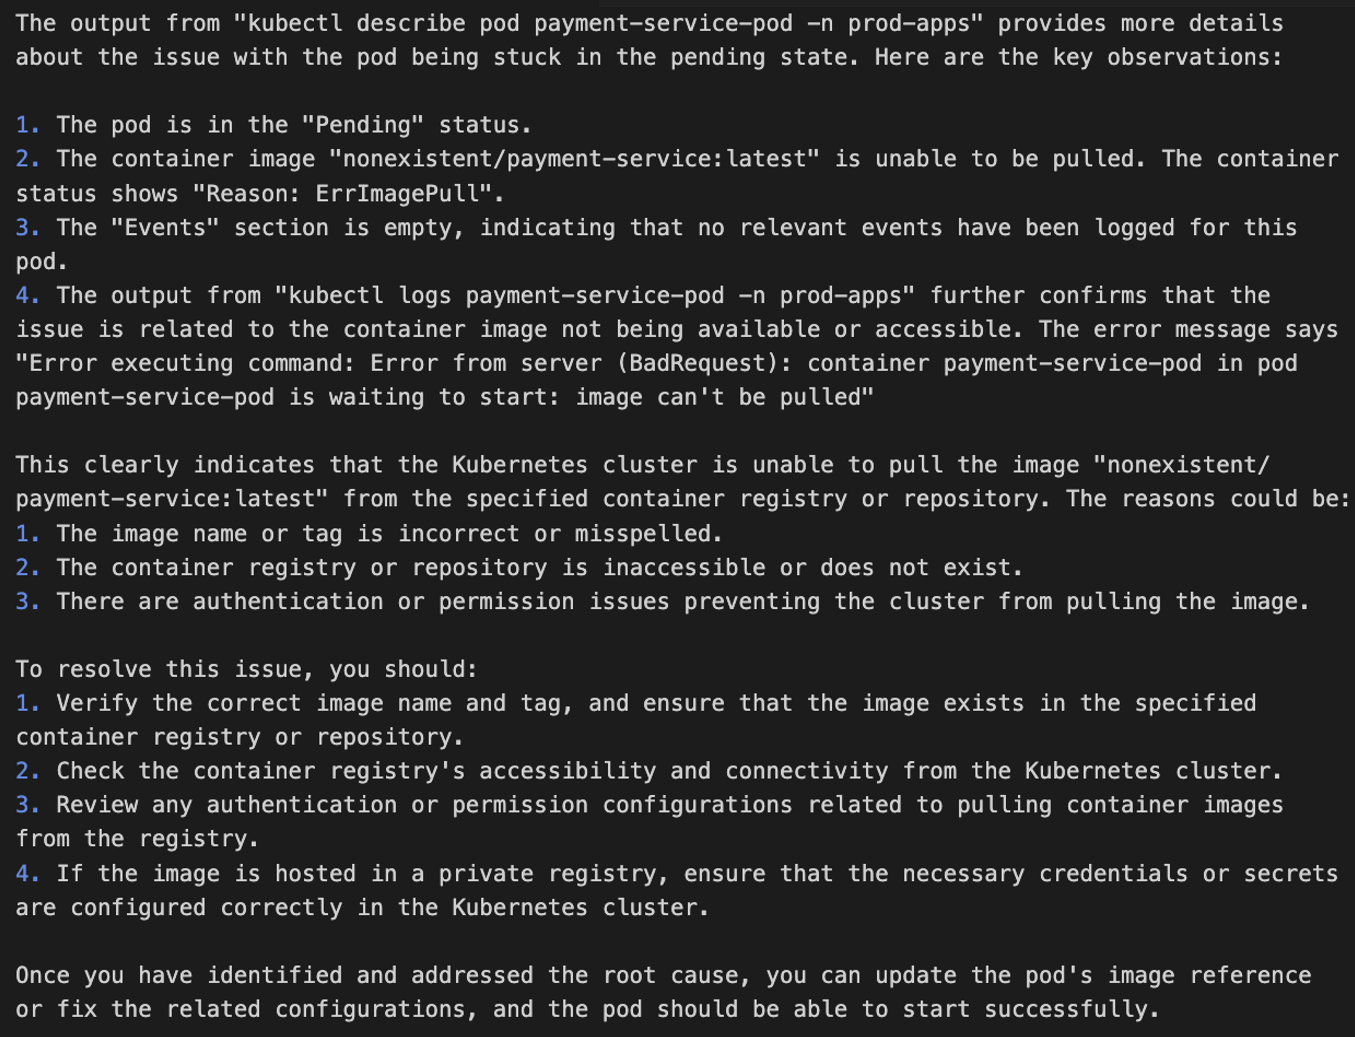
以下截图展示了一个聊天机器人针对 Pod 卡在 Pending 状态查询的示例响应。助手生成并运行了多个 kubectl 命令来构建输出,并提出了问题修复建议。
请参阅 AWS re:Invent 2025 – Streamline Amazon EKS operations with Agentic AI 和 KubeCon – From Logs To Insights: Real-time Conversational Troubleshooting for Kubernetes with GenAI 会议,深入了解解决方案实现。
## 安全注意事项
在为 Kubernetes 环境实施 AI 智能体时,安全性必须贯穿整个架构的首要考量。该解决方案需要在聊天机器人和 EKS 集群之间建立安全的通信通道,并通过 AWS Identity and Access Management (AWS IAM) 角色对交互进行身份验证。
在权限方面,命令执行的安全性至关重要。实施严格的白名单,仅允许只读 kubectl 操作,有助于防止未经授权的集群修改,同时保持诊断能力。故障排查助手还应以最小化的 Kubernetes RBAC 权限运行,仅限于查看特定命名空间内的 Pod、服务、事件和日志。
数据保护措施必须包括:在生成嵌入之前对应用程序日志进行脱敏处理,以帮助防止敏感信息泄露;使用 AWS Key Management Service (AWS KMS) 对通过 Kinesis 传输中的遥测数据以及存储在 OpenSearch 中的静态数据进行加密。
遵循 AWS Well-Architected Framework 安全支柱原则,使用私有子网和 VPC 终端节点在 Amazon Virtual Private Cloud (Amazon VPC) 内部署组件以最小化网络暴露,实施故障排查活动的全面日志记录以用于审计目的,并验证用户输入以防止可能操纵 AI 助手行为的提示注入攻击。
## 结论
在本文中,我们介绍了如何构建一个由生成式 AI 驱动的故障排查助手,让工程师能够以自助方式解决 Kubernetes 问题,而无需总是依赖服务专家介入。通过将遥测分析与 AI 驱动的上下文相结合,工程师可以更快地找到根本原因并保持较低的 MTTR。该助手能够从多个遥测来源获取数据、运行安全的诊断命令并提供可操作的建议,有助于使故障排查过程更加高效,并减少对正在进行的工作的干扰。
随着分布式系统规模和复杂性持续增长,本文所述的解决方案变得至关重要。将 AI 置于可观测性数据之上,有助于在当下切实应对这些挑战,同时也为未来更加自主、更具韧性的运营奠定基础。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文作者:AWS Architecture Blog;如有侵权,请联系管理员删除。

