深度解析 Cursor(逐行解析系统提示词、分享高效制定 Cursor Rules 的技巧...)
编者按: 我们今天为大家带来的这篇文章,作者的观点是:只有深入理解 AI 编程工具的底层原理和能力边界,才能真正驾驭这些工具,让它们成为提升开发效率的“外挂神器”。
本文从 LLM 的基础工作机制出发,解释了 Cursor 等工具本质上是 VSCode 的复杂封装,通过聊天界面、工具集(如 read_file、write_file 等)和精心设计的提示词来实现智能编程辅助。作者还逐行解析了 Cursor 的系统提示词,分析了其中的工程设计细节。此外,作者还提供了制定高效 Cursor Rules 的具体指导,强调 Cursor Rules 应该像百科词条般详实,而非简单的命令列表。
作者 | Shrivu Shankar
编译 | 岳扬
透彻了解 Cursor[1]、Windsurf[2] 和 Copilot[3] 这类 AI 编程工具的运作原理细节,能大大提升你的开发效率,并让这些工具在不同场景下都更加稳定地工作 —— 尤其在庞大、复杂的代码库中。当人们难以让 AI 编程工具高效工作时,往往是把它们当成了传统工具来使用,却忽略了一个关键:只有清楚这些工具的先天不足和最佳应对策略,才能真正驾驭它们。一旦摸透这些工具的运作逻辑和能力边界,它们就会化身成为提升开发效率的“外挂神器”。在我写作此文时,我约 70% 的代码1都由 Cursor 产出。
在本文,我将深入解析这些 AI 编程工具的实际运行原理、Cursor 的系统提示词,以及如何优化你的编码方式与 Cursor rules。
01 从 LLM 到代码编写智能体
1.1 LLM
LLMs 的核心工作方式是不断重复预测下一个词,正是基于这个简单的原理,我们得以构建出各种复杂的应用。
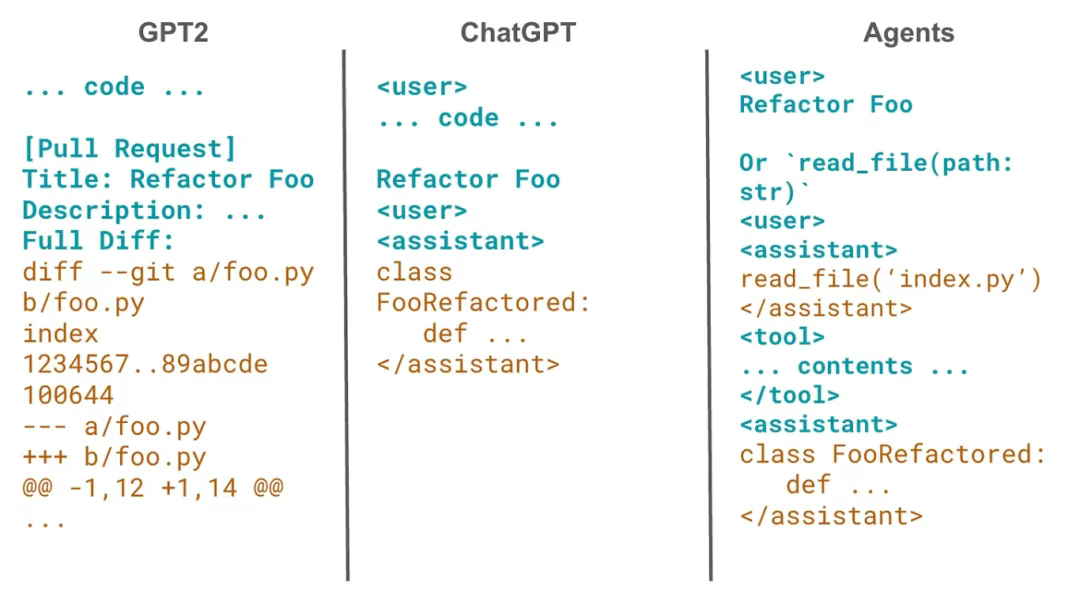
从基础的编程 LLM 到智能体主要经历三个阶段:蓝色部分表示我们设定的前缀(即 prompts),橙色部分则为 LLM 自动补全的内容。在智能体中会反复运行 LLM,直到它生成面向用户的输出(response)。每次运行时,由客户端代码(而非 LLM)负责计算工具(tool)运行结果并将其反馈回智能体(agent)。
在早期解码器 LLM(如 GPT-2[4])的提示词实践中,需要精心构造一个前缀字符串(prefix) —— 当其被补全时,便能得到想要的结果。相比于直接的指令“Write a poem about whales”,不如说 “Topic: Whales\nPoem: ”,甚至是“Topic: Trees\nPoem: … actual tree poem …\nTopic: Whales\nPoem: ”。在编程场景下,需要构造类似“PR Title: Refactor Foo Method\nDescription: …\nFull Diff: ”这样的前缀。所谓的“Prompt engineering”,其核心就是巧妙地构建理想前缀,从而引导模型自动补全出所需答案。
随后引入了指令微调[5](例如 ChatGPT),大幅降低了大语言模型的使用门槛。现在你如果输入“Write a PR to refactor Foo”,它就会直接返回代码。其内在机制几乎完全等同于上述的自动补全过程,只是前缀变成了“<user>Write a PR to refactor Foo</user><assistant>”,此时大语言模型正扮演着聊天中的助手角色。即使在今天,你仍会看到一些奇怪的情况 —— 模型有时会越过“</assistant>”标签继续自动补全生成内容,开始给自己写提问。
当模型规模达到一定程度时,我们更进一步,加入了“工具调用(tool calling)[6]”功能。不再局限于填充 assistant 文本,我们可以在前缀中输入“Say \read_file(path: str)` instead of responding if you need to read a file”。当遇到编码任务时,模型现在会补全出“read_file(' index.py')</assistant>”,我们(客户端)则会再次输入提示词“<tool>... full contents of index.py ...</tool><assistant>`”并要求其继续补全文本。虽然本质上仍是自动补全,但大语言模型已能借此与外界及外部系统互动了。
1.2 Agentic Coding
像 Cursor 这样的 AI 编程工具,其本质就是这个简单概念的复杂封装。
要构建一个 AI 编程工具,你需要:
-
Fork VSCode[7]
-
添加聊天界面,并选择一个强大的大语言模型(例如 Sonnet 3.7)
-
为编码智能体实现一套工具集
a. read_file(full_path: str)
b. write_file(full_path: str, content: str)
c. run_command(command: str)
-
优化内部提示词(Prompts):例如“你是一位编码专家”、“不要假设,请使用工具”等
总的来看,核心流程基本就是这些了。 真正的难点在于设计提示词和工具链,确保它们能稳定可靠地工作。 如果完全按照上述描述来构建,系统虽能勉强运行,但会频繁出现语法错误、幻觉问题(hallucinations)且相当不稳定。
1.3 优化 Agentic Coding
打造优秀 AI 编程工具的诀窍,在于找出大语言模型擅长的领域,并围绕其局限性精心设计提示词和工具。这通常意味着需要减轻主智能体的任务负担 —— 通过使用更小的模型来完成子任务。

图表说明:当你使用 AI 编程工具时,其底层发生了什么?我们简化了主智能体的工具集,将“认知负担”转移到其他大语言模型上。AI 编程工具会将你的 @标签注入上下文,调用多个工具来收集更多信息,使用专用的代码变更标记规则(diff syntax)编辑文件,最后向用户返回摘要响应。
1.4 优化措施与面向终端用户的操作建议(Optimizations & User Tips)
-
通常情况下,用户自己知道需要哪些具体文件或上下文。因此,我们在聊天界面(Chat UI)中添加了“@file”语法。当调用大语言模型时,我们会将所有附加文件的内容整体打包放入一个“<attached-files>”区块中传递。这本质上是为用户提供语法糖(syntactic sugar),免去了手动复制粘贴整个文件或文件夹的麻烦。
- 操作建议 (Tip): 在这些编程工具中建议积极使用 @folder/@file(优先提供更明确的上下文,以获取更快更准确的响应)。
-
搜索代码可能很复杂,尤其对于“我们在哪里实现了认证功能相关的代码?”这类语义查询。我们没有让智能体精通编写搜索正则表达式(regexes),而是选择在索引阶段使用一个编码器大模型(encoder LLM)将整个代码库索引到向量数据库(vectorstore)中,从而将文件内容及其功能嵌入到向量中。在查询时,另一个大语言模型会根据相关性对文件进行重排序和过滤。这确保了主智能体在询问认证功能代码相关问题时能获得“完美”的结果。
- 操作建议 (Tip): 代码注释(Code comments)和文档字符串(doc-strings)能引导嵌入模型(embedding model)理解代码,这使得它们的重要性甚至超过了仅写给人类同事看的情况。 务必在文件顶部用一段文字说明:该文件的作用、实现的语义功能以及应何时更新。
-
要生成字符层级上零缺陷(character-perfect)的代码既困难又昂贵,因此优化 write_file(…) 工具成为众多此类 AI 编程工具的核心。大语言模型通常不会输出完整的文件内容,而是生成一个 “semantic diff” —— 仅提供已更改的内容,并附带代码注释,以指导在何处插入更改的文件内容。随后,另一个更轻量、更快的代码应用大模型(code-apply LLM) 会将该 “semantic diff” 作为输入提示词,并在修复那些微小语法问题的同时写入实际文件内容。新文件经过 linter 校验器处理后,工具返回主智能体的结果时会包含实际文件差异(actual diff)和 lint 校验结果,可用于自我修正文件的错误改动。我将此机制类比为:与一位懒散的资深工程师协作,他只需写出核心片段,后续细节交由实习生完成。
- 操作建议 (Tip):你无法直接将提示词发送给应用模型(apply-model)。 类似“别乱删代码”或“别随意增删注释”的建议完全无效,因为这些问题本质上是应用模型(apply-model)工作机制的固有产物。 应该让主智能体获得更多控制权,例如在指令中明确要求:“在 edit_file 指令中提供完整的文件内容”
- 操作建议 (Tip):应用模型处理超大文件时缓慢且易错, 务必将文件拆分至每部分小于 500 行代码
- 操作建议 (Tip):lint 反馈对智能体具有极高价值,应投资构建能提供高质量建议的增强型 linter2。使用编译型语言和静态类型语言能提供更丰富的 lint 时反馈(lint-time feedback)
- 操作建议 (Tip): 使用唯一的文件名(不要在代码库中使用多个不同的 page.js 文件,最好改用 foo-page.js、bar-page.js 等), 在文档中应使用完整的文件路径,并将高频修改的代码段(hot-paths)集中到同一文件或文件夹中,以降低编辑工具的操作歧义
-
选用擅长在此类智能体(Agent)工作流中编写代码的模型(而非仅具备通用编码能力)。这就是 Anthropic 模型在 Cursor 等 AI 编程工具中表现出色的原因 —— 它们不仅代码质量高,更擅长将编程任务拆解为这种类型的工具调用(tool calls)。
- 操作建议 (Tip): 选用模型时,不应仅关注“编码能力”,应优先选择专门为智能体驱动型编程工具(agentic IDEs)优化的模型。 目前(据我所知)能有效评估此能力的唯一排行榜是 WebDev Arena[8] 3。
我在自研 AI 编程工具 sparkstack.app 中采用过一个(极其昂贵的)技巧,大幅提升了系统的自我修正能力:为其配备 apply_and_check_tool。该工具会执行更严苛的 linting,并启动无头浏览器(headless browser),沿应用的用户流程(user-flows)获取控制台日志和截图,为智能体提供反馈。正是在此类场景中,MCP(Model Context Protocol)[9]协议将大放异彩 —— 它能赋予智能体更强的自主权和上下文理解能力。
02 逐行解析 Cursor 的系统提示词
通过基于 MCP 协议的提示词注入技术,我提取了 Cursor 智能体模式(agent mode)最新(2025 年 3 月)的提示词内容。作为一名长期深耕大语言模型领域的开发者,我必须表达对 Cursor “提示词工程师(prompt engineers)”的高度敬意 —— 相比其他 AI 编程工具的提示词设计,他们的专业水准令人赞叹(个人观点)。我认为这正是 Cursor 能成为领先编程工具的核心因素。剖析此类提示词也是提升自身提示词编写能力与智能体架构能力的绝佳途径 —— 从某种意义上看,大多数基于 GPT 的封装工具采用“开放提示词(open-prompt)”实现方案,这种特性极具价值。

Cursor Agent 系统提示词片段。完整提示词及工具定义( https://gist.github.com/sshh12/25ad2e40529b269a88b80e7cf1c38084)
- “<communication>”、“<tool_calling>”等标签 → 混合使用 Markdown 和 XML 标签能大大降低人类和模型对提示词的阅读难度4。
- “由 Claude 3.5 Sonnet 驱动(powered by Claude 3.5 Sonnet)” → 大模型通常不会主动声明自身模型版本。显式标注此信息可减少用户对计费模型与实际运行模型不一致的抱怨5。
- “全球最佳 IDE(the world's best IDE)” → 该表述简洁地禁止模型在故障时推荐竞品,这对那些代表品牌形象的智能体来说至关重要6。
- “我们会自动附上某些信息…遵循 <user_query> 标签内的用户指令(we may automatically attach some information…follow the USER’s instructions…by the <user_query> tag)” → Cursor 并未直接将用户提示词传递给模型,而是将其置于专用标签中。这使得系统能在 <user> 消息中传递更多与用户相关的文本,既不会让大语言模型(LLM)混淆,也不会让用户感到困惑。
- “避免道歉(Refrain from apologizing)” → 这显然是为抑制 Sonnet 模型的致歉倾向而添加的规则。
- “绝对不要提及工具名称(NEVER refer to tool names when speaking)” → Cursor 特别以加粗格式添加此指令。但讽刺的是,我仍常见到类似“使用 edit_tool”的违规输出 —— 近期 Sonnet 模型在此方面的表现确实恼人。
- “调用每个工具前需先解释(Before calling each tool, first explain)” → 当大模型在流式传输(streaming)工具调用时,用户界面会出现短暂卡顿。此指令能帮助用户确信系统正在处理他们的请求,避免因界面停滞而产生不安。
- “若部分满足了用户查询,但你还不确定,则请收集更多信息(partially satiate the USER's query, but you're not confident, gather more information)” → 大模型智能体常因过度自信而过早终止任务。此指令为其提供“退路”,促使其深度探索后再响应。
- “禁止直接向用户输出代码(NEVER output code to the USER)” → 默认情况下,大模型倾向以内联代码块(inline markdown codeblocks)形式输出代码。此规则强制其仅通过工具操作代码,并依赖 UI 间接向用户展示变更结果。
- “若从零构建 Web 应用,必须设计精美的、现代感的 UI(If you're building a web app from scratch, give it a beautiful and modern UI)” → 此为针对演示场景的优化(demo-hacking),确保单提示词(single-prompt)即可生成华丽的应用。
- “在编辑之前,你必须读取你要编辑的内容7(you MUST read the contents or section of what you're editing before editing it)” → 编码智能体常急于写代码而忽略收集上下文。此类直接的、显式的指令用于校正该行为。
- “修复 linter 错误时循环次数不得超过 3 次(DO NOT loop more than 3 times on fixing linter errors)” → 旨在防止 Cursor 陷入代码编辑的死循环。此措施虽有帮助,但 Cursor 的深度用户都知道,系统仍易因此卡顿。
- “解决根本原因而非仅处理表象(Address the root cause instead of the symptoms)” → 这一点是针对大模型常见的对齐问题(alignment issues):模型常倾向于直接删除报错代码而非修复问题本身。
- “禁止硬编码 API 密钥(DO NOT hardcode an API key)” → 众多安全方面的最佳实践之一,至少可以防止一些明显的安全问题。
- 工具 codebase_search/read_file/grep_search/file_search/web_search → 鉴于编码前获取正确上下文是非常重要的,Cursor 提供多种形态的搜索工具,确保智能体能够轻松定位要做的修改。
- 一些工具中的“单句解释...说明为何需要运行此命令...”("One sentence explanation...why this command needs to be run...") → 大多数工具都包含这个非功能性参数,它迫使大模型推理论证它将传递哪些参数,此为提升工具调用准确性的常规技巧。
- reapply 工具“调用更强大模型执行上次编辑的内容(Calls a smarter model to apply the last edit)” → 允许主智能体动态升级应用模型(即使用更高成本模型),自主解决低级应用错误。
- edit_file 工具要求“用对应语言的注释表示未修改代码(represent all unchanged code using the comment of the language you're editing)” → 此规则解释了自动生成的随机注释的来源,也是应用模型正常工作的必要前提。
- 您会注意到整个系统提示词和工具描述均为静态内容(未注入用户或代码库个性化文本)。 该设计使 Cursor 能充分利用提示词缓存(prompt caching) 优势[10],大幅降低推理成本并减少输出首 个 token 的延迟时间(time-to-first-token latency) —— 这对每次使用工具都需调用大模型的智能体架构至关重要。
03 如何高效制定 Cursor Rules
现在最大的问题是,编写 Cursor rules 的“正确方式”是什么?虽然我的整体答案是“以实际效果为准,适合你的才是最好的”(whatever works for you),但基于提示词工程经验和对 Cursor 内部原理的认知,我确实有大量具体建议。

大语言模型如何看待你的 Cursor 项目规则?模型会看到规则的名称和简介列表,然后根据需要调用 fetch_rules(...) 函数来获取和查看具体的规则内容
关键是要明白,这些规则并非是附加到系统提示词中的,而是作为具名指令集(named sets of instructions)被引用。因此,建议采用编写百科词条(encyclopedia articles)而非命令(commands)的思维方式设计 Cursor rules。
- 切勿在 Cursor rules 中声明身份(例如“您是精通 TypeScript 的资深前端工程师”)。 此类规则虽见于 cursor.directory 且看似有效,但会与内置提示词赋予的身份产生冲突,导致智能体行为异常。
- 避免尝试覆盖系统提示词指令,或通过特定提示词(prompt)引导应用模型(apply model)的行为。 类似“别添加注释”、“编码前先提问”、“勿删除未提及代码”的指令会直接破坏工具使用机制并干扰智能体运作。
- 减少使用否定性指令。 大模型更擅长遵循正向指令(“若遇<此情况>,则<执行此操作>”),而非单纯列出限制条件。此原则亦体现在 Cursor 的官方提示词中。
- 请务必花时间编写高度明显的规则名称和描述。 关键在于,即使智能体(Agent)对您的代码库所知甚少,也能凭直觉知道何时适合应用某条 Cursor rules 来使用其 fetch_rules(…) 工具。类似于手动建立文档索引的做法,你应该适当地创建一些内容相同但名称和描述不同的规则副本,这样可以提高 AI 找到相关规则的概率。规则描述应当力求信息密集,避免过度冗长。
- 把你的模块规则和常见代码修改规则写得像百科词条一样详细和完整。 如同维基百科那样,将关键术语(使用 mdc 链接语法)链接到代码文件,这在智能体确定代码变更所需的关键上下文时能提供巨大助力。有时,这也意味着,要避免按部就班地进行说明(专注于“做什么”而非“怎么做”),除非真的没办法,否则不要让智能体过度专门化,只会处理某一种特定的代码修改模式。
- 请务必使用 Cursor 本身来起草您的 Cursor rules 。 大语言模型(LLMs)非常擅长为其他大语言模型撰写内容。如果您不确定如何组织文档格式或编码上下文,请执行 “@folder/ generate a markdown file that describes the key file paths and definitions for commonly expected changes”。
- 要意识到制定太多规则其实是个不好的做法。 这一点看似违反直觉 —— 虽然规则确实是让 AI 开发工具处理大型项目的关键,但需要很多规则本身就暴露了一个问题:你的代码库对 AI 来说不够友好。我在《AI-powered Software Engineering》[11]一书中深入探讨了这个话题。未来理想的代码库应该设计得足够清晰直观,AI 编程工具光靠基础功能就能完美胜任所有工作。
请参考我生成的一些示例[12]。
04 Conclusions
一个基于近乎开源的智能体提示词和公开模型 API 构建的 VSCode 分支,其估值竟能接近 100 亿美元 —— 带着 68 倍的“wrapper multiple”8 —— 这着实令人惊叹。我们将拭目以待 Cursor 最终是否会开发自己的智能体模型(感觉可能性不大),或是 Anthropic 是否会带着 Claude Code + 下一代 Sonnet 强势介入成为竞争对手。
无论最终结果如何,学会如何优化你的代码库、文档和规则配置仍然是一项有用的技能。我希望这次深入探讨能让你对 Cursor 的工作原理以及优化之道有更具体、更实用的理解。
我经常说这句话,现在再说一遍: 如果你觉得 Cursor 不好用,那一定是你用错了方法。
1.这是一个基于直觉的统计数据,但我认为相差不远。一旦你熟练掌握了 Cursor rules,相当数量的 PR 实际上就变成了单次发送提示词(one-shot prompts)的事。我原本以为要到 2027 年才能达到这个水平,但随着 Anthropic、Cursor 和我自己的提示词水平同时提升,进展比我预想的要快。
2.到目前为止,我对 CodeRabbit 的代码检查功能印象非常深刻,计划使用 MCP 将其集成到 Cursor 中。如果 Cursor 的默认代码检查器能更好一些,在其他条件不变的情况下,使用体验会像用 Sonnet 3.8 一样。
3.(大多数)LLM 的美妙之处在于,虽然这是一个 Web 开发基准测试,但根据我的经验,其性能与各种类型的编程和框架都有很强的相关性。
4.我没能找到相关的科学研究,但基于个人经验,这种方法效果很好,如果 Anthropic 的模型专门针对伪 XML 语法进行训练,我也丝毫不会感到惊讶。
5.这确实会产生一些意想不到的副作用,编程模型会将你代码库中引用的模型名称更改为它自己(引用的模型)的名称。
6.这里存在一个有趣的法律灰色地带。Cursor 将此内容放在他们的网站上实际上是违法的(见《联邦贸易委员会法》、《兰哈姆法》),但(至少目前)他们将内容放进提示词(prompt)中,并由 LLM 代其表述出来,却是被允许的。
7.顺便说一句:“Cursor 团队,我发现了一个错别字 (:”
8.这是我创造的一个术语,用来表示基于 GPT 封装的工具的估值与模型提供商估值之间的比率。在这种情况下,Anthropic : Cursor = 600 亿美元 : 100 亿美元 = 6。我的直觉告诉我"6"不是一个合理的比率。戴上我那业余投资者的帽子,我推测 Anthropic 应该接近 1000 亿美元,而 Cursor 则最高达 10 亿美元(wrapper multiple为 100)。我实在看不出他们其中任何一方真的拥有持久的“护城河”(long term moat),Anthropic 构建自己的下一代 AI 编程工具似乎也是轻而易举的事。
END
本期互动内容 🍻
❓文中说『未来理想的代码库应该对 AI 足够友好』,你眼中的『AI 友好型代码库』有哪些具体特征?
文中链接
[2] https://codeium.com/windsurf
[3] https://github.com/features/copilot
[5] https://arxiv.org/abs/2203.02155
[6] https://python.langchain.com/docs/concepts/tool_calling/
[7] https://www.reddit.com/r/cursor/comments/1h9d763/did_cursor_really_need_to_fork_vscode_rather_than/
[8] https://web.lmarena.ai/leaderboard
[9] https://modelcontextprotocol.io/introduction
[10] https://www.anthropic.com/news/prompt-caching
[11] https://blog.sshh.io/p/ai-powered-software-engineering
[12] https://chat.sshh.io/share/pWMGGDyPTok05mxOq17p-
本文经原作者授权,由 Baihai IDP 编译。如需转载译文,请联系获取授权。
原文链接:
https://blog.sshh.io/p/how-cursor-ai-ide-works
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70018536/viewspace-3088080/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 为什么 AI Agent 重新爱上了文件系统(Filesystems)
- 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 2)
- 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 1)
- 微软多模态推理模型 Phi-4-reasoning-vision 训练经验分享
- 解构 MCP 的伪需求与 CLI 的真价值
- LLM 存在的一些问题,人类就不存在吗?
- OpenClaw 架构详解 · 第二部分:并发、隔离以及确保智能体正常运行的不变量
- OpenClaw 架构详解 · 第一部分:控制平面、会话管理与事件循环
- 目前市场上似乎只有三类真正可行的 AI 产品
- 为什么 AI 巨头们放弃私有壁垒,争相拥抱 Agent Skills
