「模型量化技术」可视化指南:A Visual Guide to Quantization
编者按:随着大语言模型(LLMs)规模的不断扩大,如何在有限的计算资源下高效部署这些模型成为了一个迫切需要解决的问题。模型量化作为一种有效的模型压缩技术,在保持模型性能的同时大大降低了计算和存储开销,因此广受关注。但对于许多人来说,模型量化的具体原理和实现方法仍然是一个"黑盒"。
我们今天为大家带来的这篇文章,通过可视化图示详细解析各种模型量化技术的原理和实现方法,为各位读者提供一个全面且直观的模型量化技术指南。
本文旨在帮助各位读者涉猎以下技能领域:
- 理解模型量化技术的基本原理和作用
- 掌握多种模型量化方法及其优缺点
- 学会如何选择合适的量化方法,并根据实际场景进行调整
我们分享这篇全面且深入的技术解析,期望各位读者不仅能够理解模型量化的基本原理,还能洞察该领域的最新发展趋势。随着模型量化技术的不断进步,我们有理由相信,未来将会出现更加高效、更轻量级的大语言模型,为 AI 技术的更广泛应用铺平道路。
作者 🕶 | Maarten Grootendorst
编译 🐣 | 岳扬
目录🧾
01 第 1 部分:LLMs 存在的"问题"
1.1 参数数值(value)的表示方法
1.2 内存限制问题
02 第 2 部分:模型量化技术简介
2.1 常用的数据类型
2.1.1 FP16
2.1.2 BF16
2.1.3 INT8
2.2 对称量化 Symmetric Quantization
2.3 非对称量化 asymmetric quantization
2.4 取值范围的映射与裁剪
2.5 校准过程 Calibration
2.5.1 权重(和偏置项) Weights (and Biases)
2.5.2 激活值
03 第 3 部分:Post-Training Quantization
3.1 动态量化(Dynamic Quantization)
3.2 静态量化(Static Quantization)
3.3 探索 4-bit 量化的极限
3.3.1 GPTQ
3.3.2 GGUF
04 第 4 部分:Quantization Aware Training
4.1 1-bit LLM 的时代:BitNet
4.2 权重的量化 Weight Quantization
4.3 激活值的量化 Activation Quantization
4.4 反量化过程 Dequantization
4.5 所有 LLMs 实际上均为 1.58-bit
4.5.1 The Power of 0
4.5.2 Quantization 量化过程
05 Conclusion
Resources
文中链接🔗
顾名思义,大语言模型(Large Language Models,LLMs)的特点就是庞大,以至于普通的消费级硬件都难以承载。 这些模型的参数量级可达数十亿,而且在进行推理时,往往需要依赖拥有大量显存(VRAM)的 GPU 来加快推理速度。
鉴于此,越来越多的研究者将目光投向如何通过优化训练方法、使用适配器(adapters)等技术来缩小模型体积。在这一领域,模型量化(quantization)技术成为了一个重要的研究方向。
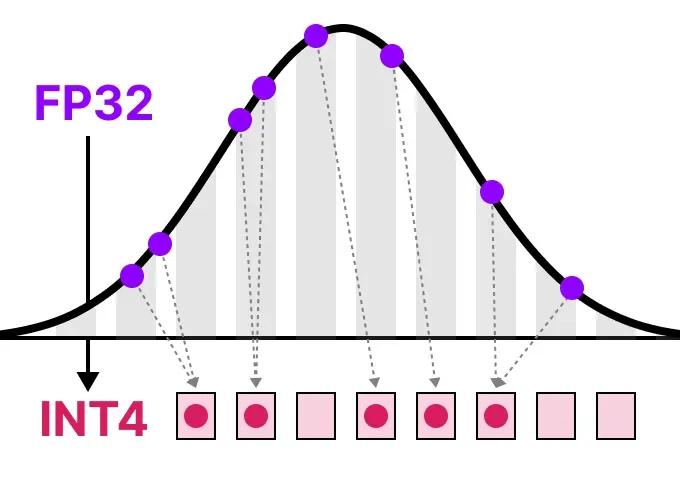
本篇文章将带领大家深入了解语言模型领域的量化技术,并逐一探讨相关概念,帮助大家建立起对这一领域的直观认识。我们将一起探索不同的量化方法、实际应用场景,以及模型量化技术的基本原理。
本文将提供许多图表(visualizations)来帮助各位读者更好地理解和掌握模型量化技术这一概念,希望大家能够直观、深入地理解模型量化技术。
01 第 1 部分:LLMs 存在的"问题"
大语言模型之所以被称为"大",是因为其参数数量十分之庞大。目前,这类模型的参数数量通常能够达到数十亿之巨(主要是指权重参数(weights)),这样的数据量其存储成本无疑是一笔巨大的开销。
在模型的推理过程中,激活值(译者注:activations,神经网络中某个层对输入数据应用激活函数后产生的输出值。)是通过输入数据(input)与模型权重(weights)相乘等一系列步骤来生成的,这些激活值的数据量也可能非常庞大。

因此,我们的目标是找到一种尽可能高效的方式来表达数十亿个参数,以减少存储每个参数所需的空间。
在开始对这些参数进行优化之前,我们从最基本的部分入手,先探讨一下参数数值(value)在计算机中最初是如何表示的。
1.1 参数数值(value)的表示方法
在计算机科学中,特定的数值(value)通常都以浮点数的形式来表示,即带有正负号和小数点的数字。
这些数值是由 "bits" 组成的,也就是由二进制数字表示。根据 IEEE-754 标准[1],这些 "bits" 可以用来表示三个不同的部分,从而构成一个完整的数值(value): 符号位、指数部分以及小数部分(也称为尾数)。

这三个部分结合起来,就能根据一组特定的 "bit" 值来计算出一个具体的数值(value):

一般来说, 用来表示数值(value)的 "bit" 越多,得到的数值(value)精确度就越高:

1.2 内存限制问题
可用的 "bits" 数量越多,所能表示的数值范围就越大。

一个特定的数值表示法能够表示的所有数值的区间被称为 动态范围(dynamic range) ,而相邻两个数值之间的间隔则被称为 精度(precision) 。

使用这些 "bits" 的一个有趣功能是,我们可以计算出存储一个特定数值(value)所需的设备内存量。由于一个字节(byte)占 8 位(bits),我们可以为大多数浮点表示形式(floating point representation)制定一个基本的计算公式。

Note:在实际应用中,模型推理阶段所需的显存(VRAM)量还受到诸多因素的影响,比如模型处理上下文的大小和模型架构设计。
假设我们有一个拥有 700 亿参数的模型。通常情况下,这些模型默认使用 32 位浮点数(常称为全精度)进行表示,仅加载模型就需要 280GB 内存。

因此,尽可能地减少用于表示模型参数的 "bits" 数量(包括模型训练过程中也是如此)是非常有必要的。但是,有一点必须注意, 精度的降低往往会导致模型准确性下降。
我们的目标是 减少用于表示模型参数的 "bits" 数量,同时又不损害模型的准确性...... 这就是模型量化技术的作用所在!
02 第 2 部分:模型量化技术简介
模型量化的核心在于将模型参数的精度从较高的位宽(bit-widths)(例如 32 位浮点数)降低到较低的位宽(bit-widths)(例如 8 位整数)。

在减少参数的 "bits" 数量时,通常会出现一定的精度损失(即丢失一些数值细节)。
为了更直观地说明这种影响,我们可以尝试将任意一张图片仅用 8 种颜色来表示:

该图像基于 Slava Sidorov 的原作[2]进行了修改
观察放大区域,我们可以发现它比原始图片看起来更加"粗糙",因为使用的颜色种类减少了。
模型量化的主要目的就是减少表示原始参数所需的 "bits" 数量(在上述案例中即为颜色种类),同时尽可能保留原始参数的精度。
2.1 常用的数据类型
首先,我们来看看一些常见的数据类型,以及它们与 32-bit(全精度(full-precision)或 FP32 )表示法相比的影响。
2.1.1 FP16
以从 32-bit 转换到 16-bit(半精度或 FP16 )的浮点数为例:

可以看到,FP16 的数值范围比 FP32 要窄得多。
2.1.2 BF16
为了保持与原始 FP32 相似的数值范围,引入了 bfloat 16 这一数据类型,它类似于"截断版的FP32":

BF16 虽然使用的 "bits" 数量与 FP16 相同,但能表示的数值范围更广,因此在深度学习领域内得到了广泛应用。
2.1.3 INT8
当我们需要再进一步减少 "bits" 的数量时,就到了整数表示法施展身手的领域,而不再是浮点数表示法。例如,从 FP32 转换为仅有 8 bits 的 INT8,其占用的 bits 数量仅仅是原来的四分之一:

有些硬件优化了整数运算,因此在这些硬件上整数运算可能会更高效。然而,并不是所有硬件都进行了这样的优化。不过, 一般来说,使用较少的 "bits" 数量,计算速度通常会更快一些。
每减少一个 bits ,就需要进行一次映射(mapping)操作,将原本的 FP32 表示形式"压缩"到更少的 "bits" 数量。
在实际应用中,我们并不需要将 FP32 所表示的全部数值范围 [-3.4e38, 3.4e38] 都映射到 INT8。我们只需找到一种方法,将数据(即模型参数)范围映射到 INT8 即可。
常用的压缩(squeezing)和映射(mapping)方法包括对称量化(symmetric quantization)和非对称量化(asymmetric quantization),它们都是线性映射(linear mapping)的不同形式。
接下来,我们将探讨一下这些将 FP32 量化为 INT8 的方法。
2.2 对称量化 Symmetric Quantization
在对称量化过程中,原本浮点数的值域会被映射到量化空间(quantized space)中一个以零为中心的对称区间。从前面的例子可以看出, 量化前后的值域都是围绕零点对称的。

这就意味着,在浮点数中表示零的值,在量化空间中仍然是正好为零。
对称量化(symmetric quantization)有一种经典方法是绝对最大值(absmax,absolute maximum)量化。
具体操作时,我们会从一组数值中找出最大的绝对值(α),以此作为线性映射的范围(译者注:从 -α 到 +α)。

Note:值域 [-127, 127] 代表的是受限制🚫的范围,而 8-bit 整数可以表示的完整范围是[-128, 127],选择哪种范围取决于所采用的量化方法。
由于这是一种以零为中心的线性映射(linear mapping),所以计算公式相对简单。
我们首先根据以下公式计算比例因子(s):
- b 是我们想要量化到的字节数(译者注:原文为"Byte",此处保留原义,译为字节数,译者认为可能为 bits 数量)(这里是 8 ),
- α 是最大绝对值,
接着,我们用这个比例因子 s 来量化输入值 x:

将这些数值代入公式后,我们将得到以下结果:

为了恢复原始的 FP32 值,我们可以使用之前计算出的比例因子(s)来对量化后的数值进行反量化(dequantize)。

先量化后再反量化以恢复原始值的过程如下所示:

我们可以观察到,某些值(如 3.08 和 3.02 )在量化到 INT8 后,都被分配了相同的值 36。当这些值反量化(dequantize)回 FP32 时,会丢失一些精度,变得无法再区分。
这种现象通常被称为 量化误差(quantization error) ,我们可以通过比较原始值(original values)和反量化值(dequantized values)之间的差值来计算这个误差。

一般来说,"bits" 的数量越少,量化误差往往越大。
2.3 非对称量化 asymmetric quantization
与对称量化(symmetric around)不同,非对称量化并不是以零为中心对称的。 它将浮点数范围中的最小值(β)和最大值(α)映射到量化范围(quantized range)的最小值和最大值。
我们在此要探讨的方法称为零点量化。

各位注意到 0 的位置是如何移动的吗?这正是它被称为"非对称量化"的原因。在区间 [-7.59, 10.8] 中,最小值和最大值与零点之间的距离是不相等的。
由于零点位置的偏移,我们需要计算 INT8 范围的零点来进行线性映射(linear mapping)。与之前一样,我们还需要计算一个比例因子(s),但这次要使用 INT8 范围( [-128, 127] )的两个端点之间的差值。

请注意,由于需要计算 INT8 取值范围中的零点(z)来调整权重,这个过程稍微复杂一些。
和之前一样填入公式:

要将从 INT8 量化后的数值反量化回 FP32 ,需要使用之前计算的比例因子(s)和零点(z)。
除此之外,反量化过程则相对比较直接:

当我们将对称量化和非对称量化放在一起对比时,我们可以迅速看出这两种方法之间的差异:

Note:请注意对称量化(symmetric quantization)以零点为中心的特性,以及非对称量化(asymmetric quantization)存在的零点偏移。
2.4 取值范围的映射与剪裁
在前文所举的例子中,我们研究了如何将向量中的数值映射到更低的位表示形式(lower-bit representation)中。虽然这样使得向量的全范围都能被映射,但有一个明显的缺点,那就是有离群值(outlier)时不太好处理。
假设有一个向量,其值如下:

请注意, 如果其中一个数值(value)远大于其他所有数值,该数值就可以被视作离群值(outlier)。 如果我们要映射这个向量的全部数值,那么所有较小的数值都将映射到相同的较低位表示,并因此失去它们的独特特性:

这就是我们之前使用的 absmax 方法。请注意,如果我们不进行剪裁(clipping),非对称量化也会出现这样的问题。
另一种选择是裁剪(clip)掉某些数值。裁剪(Clipping)操作会为原始值设定一个不同的动态范围,这样所有离群值都会被映射到相同的值。
在下文给出的案例中,如果我们手动将动态范围设置为 [-5, 5] ,所有超出这个范围的数值无论其原始值是多少,都将被映射为 -127 或 127 :

这种方法的主要优点是,显著减少了非离群值的量化误差。 然而,离群值的量化误差却增加了。
2.5 校准过程 Calibration
在前文的示例中,我展示了一种简单方法 ------ 即任意选择一个取值范围 [-5, 5]。这个过程被称为校准(calibration),其目的是 找到一个能够包含尽可能多数值(values)的范围,同时尽量减少量化误差(quantization error)。
对于不同类型的参数,执行校准步骤的方法并不相同。
2.5.1 权重(和偏置项) Weights (and Biases)
在 LLMs 中,我们可以将权重(weights)和偏置项(Biases)视为预先确定的静态值,因为这些值在运行模型之前就已经确定了。例如,Llama 3 的约 20 GB 文件[3]中大部分都是其权重和偏置项。

由于偏置项的数量(以百万计)远少于权重(以数十亿计),偏置项通常被保留在更高的精度(如 INT16 ),而量化的主要工作则集中在权重的处理上。
因为权重是静态且已知的,所以对其的量化技术可以有:
- 手动选择输入范围的百分位数
- 优化原始权重和量化权重之间的均方误差(MSE)
- 最小化原始值和量化值之间的熵(KL 散度)

例如,第一种方法(手动选择输入范围的百分位数)会导致出现与前文我们看到的相似的裁剪(clipping)行为。
2.5.2 激活值
在 LLMs 中, 那些在整个推理过程中持续更新的输入(input)通常被称为"激活值"(activations)。

请注意,这些值之所以被称为激活值,是因为它们经常需要经过某些激活函数处理,比如 sigmoid 或 relu。
与权重不同,激活值会随着每次输入数据的改变而变化,因此很难对其进行精确量化。
由于这些值在每个隐藏层之后都会更新,因此我们只能在输入数据通过模型时才能预测它们在推理过程中的具体数值。

一般来说,校准权重和激活值的量化方法主要有两种:
- Post-Training Quantization(PTQ) --- 训练完成后进行量化
- Quantization Aware Training(QAT) --- 训练/微调过程中同时进行量化
03 第 3 部分:Post-Training Quantization
在众多量化技术中,post-training quantization(PTQ)是最为流行的一种。这种方法是在训练完模型之后对模型的参数(包括权重和激活值)进行量化。
对于权重值 的量化可以采用 对称量化(symmetric quantization) 或 非对称量化(asymmetric quantization) 两种方式。
至于激活值,由于我们不知道其范围,因此需要通过模型的推理来获取它们的 potential distribution(译者注:指的是在不同的输入数据和模型参数下,激活值可能出现的一系列数值。了解这个分布有助于我们选择一个能够包含大部分激活值范围的量化级别,从而减少量化误差。),然后再进行量化。
激活值的量化主要有两种形式:
- 动态量化(Dynamic Quantization)
- 静态量化(Static Quantization)
3.1 动态量化(Dynamic Quantization)
当数据通过隐藏层时,其激活值会被收集起来:

随后,利用这些激活值的分布(distribution of activations)来计算量化输出值所需的零点(z)和比例因子(s)值:

每次数据通过一个新模型层时,都要重复上述过程。因此,每个模型层都有其独特的 z 值和 s 值,因此也有不同的量化方案。
3.2 静态量化(Static Quantization)
与动态量化不同,静态量化在模型推理过程中不实时计算零点(z)和比例因子(s),而是在模型训练或校准过程中提前计算。
为了找到这些值,会使用一个校准数据集,并让模型处理这些数据,以便收集可能的激活值分布(potential distributions)。

收集到这些数值后,我们就可以计算出必要的 s 值和 z 值,以便在推理过程中进行量化。
在实际推理过程中,s 值和 z 值不需要重新计算,而是被应用于所有激活值,实现全局量化。
通常情况下,动态量化技术可能会稍微更精确一些,因为它为每个隐藏层计算一次 s 值和 z 值。不过,由于需要计算这些值,因此可能会增加计算时间。
相比之下,静态量化虽然准确度稍低,但由于事先已知用于量化的 s 值和 z 值,因此在推理时更为高效。
3.3 探索 4-bit 量化的极限
将量化位数降至 8-bit 以下是一项艰巨的任务,因为每减少一个 bit,量化误差(quantization error)就会增加。 幸运的是,有几种巧妙的方法可以将量化位数进一步降低到 6-bit、4-bit,甚至 2-bit (不过不建议低于 4-bit )。
接下来将探讨两种在 HuggingFace** 上常用的方法:
- GPTQ --- 全模型在 GPU 上运行。
- GGUF --- 将一部分模型层从 GPU 转移到 CPU 上执行。
3.3.1 GPTQ
GPTQ 无疑是实际应用中最著 名的 4-bits 量化方法之一。1
它采用非对称量化(asymmetric quantization),并逐层处理,每一层都经过独立处理,然后再继续处理下一层:

在这个逐层量化的过程中,首先将模型层的权重转换为 Hessian 矩阵(译者注:Hessian 矩阵是二阶偏导数矩阵,用于描述函数在其输入变量上的局部曲率。对于多变量函数,Hessian 矩阵可以帮助我们了解函数在某一点上的凹凸性,以及函数值对输入变量的变化有多敏感。)的逆矩阵。它是模型损失函数的二阶导数,它告诉我们模型输出对每个权重变化的敏感程度。
简单来说, 该过程展示了模型层中每个权重的重要性(或者说是权重的影响程度)。
与 Hessian 矩阵中较小值相关的权重更为重要,因为这些权重的微小变化可能会对模型的性能产生重大影响。

在 Hessian 矩阵的逆矩阵中,数值越低,权重越 "重要"。
接下来,我们对权重矩阵的第一行权重进行量化,再进行反量化:

通过这一过程,我们可以计算出量化误差 (q),我们可以用之前计算的 Hessian 矩阵的逆矩阵(h_1)来调整这个误差。
换句话说,我们是在根据权重的重要性来构建加权量化误差(weighted-quantization error):

接着,我们将这个加权的量化误差重新分配到该行的其他权重上。这样做可以保持神经网络的整体功能(overall function)和输出(output)不变。
例如,如果要对第二个权重(如果它是 0.3(x_2))进行此操作,我们就会将量化误差(q)乘以第二个权重的 Hessian 矩阵的逆矩阵(h_2)加上去。

我们可以对第一行中的第三个权重进行同样的处理:

重复这个重新分配加权量化误差的过程,直到所有值都被量化。
这种方法之所以行之有效,是因为权重之间通常是相互关联的。因此,当一个权重出现量化误差(quantization error)时,与之相关的权重也会相应地更新(通过 Hessian 矩阵的逆矩阵)。
NOTE:本文作者[4]采用了几种技巧来加快计算速度并提高性能,例如在 Hessian 矩阵中添加阻尼因子(dampening factor)、"懒惰批处理(lazy batching)",以及使用 Cholesky 方法预先计算信息(precomputing information)。我强烈建议各位读者观看这个视频[5]。 TIP:如果你想要一种可以优化性能和提高推理速度的量化方法,可以查看 EXL2[6] 这个项目。
3.3.2 GGUF
虽然 GPTQ 是一种在 GPU 上运行完整 LLMs 的最佳模型量化方法,但我们可能很多时候没有这种条件。于是我们可以使用 GGUF 将 LLM 的某些模型层放到到 CPU 上进行处理。2
这样,当 VRAM 不足时,就可以同时使用 CPU 和 GPU。
量化方法 GGUF 仍不断在更新,并且其性能可能会根据量化位数的不同而有所变化。其基本原理如下:
首先,给定模型层的权重被分割成包含一组"子"块的"超级"块("super" blocks)。
我们从这些 blocks 中提取比例因子(s)和 α(α):

为了量化给定的"子"块("sub" block),我们可以使用之前介绍的 absmax 量化方法。这种方法会将给定权重乘以比例因子(s):

比例因子是通过"子"块的信息计算出来的,但量化时使用的是"超级"块的信息,后者有自己的比例因子:

这种基于块(blocks)的量化方法使用"超级"块的比例因子(s_super)来量化"子"块的比例因子(s_sub)。
每个比例因子的量化级别可能会有所不同,"超级"块的比例因子通常比"子"块的比例因子有更高的精度。
为了更直观地理解,观看下图进一步了解这几个量化级别相关信息( 2-bit、4-bit 和 6-bit ):

NOTE:在某些量化方法中,为了保持量化后的模型性能,可能需要一个额外的最小值来调整零点,以确保模型能够正确处理极端值。这个最小值和比例因子一样,都是量化过程中的关键参数,它们需要被正确地量化,以确保量化后的模型能够保持原有的性能。
各位读者可以查看这个 PR[7] ,了解所有量化级别的详细信息。此外,还可以查看这个 PR[8],获取更多关于使用重要性矩阵(importance matrices)进行量化的信息。
04 第 4 部分:Quantization Aware Training
在第 3 部分中,我们了解到如何在训练完成后对模型进行量化。这种方法的不足之处在于,量化过程并未考虑到实际的训练过程。

于是 Quantization Aware Training(QAT)就有了用武之地。与训练后使用 post-training quantization(PTQ)技术对模型进行量化不同,QAT 的目标是在训练过程中学习量化过程。
QAT 通常比 PTQ 更准确,因为在训练过程中已经考虑了量化。其工作原理如下:
在训练过程中,引入所谓的"伪"量化。比如先将权重量化到例如 INT4 等形式,然后将它们反量化回 FP32 :

这一过程使得模型在训练阶段进行损失值计算和权重更新时能够考虑到量化误差。
QAT 尝试探索损失函数中的"宽"最小值区域,以尽可能减少量化误差,因为"窄"最小值区域往往会导致更大的量化误差。

例如,假设我们在反向传播过程(backward pass)中没有考虑量化误差。我们将根据梯度下降法(gradient descent)选择损失值(loss)最小的权重。但是,如果它位于"窄"最小值区域,可能会引入更大的量化误差。
相反,如果我们考虑到量化误差,我们将选择在"宽"最小值区域中的不同权重进行更新,量化误差会小得多。

因此,虽然 PTQ 在高精度(例如,FP32)下具有较小的损失值,但 QAT 在低精度(例如, INT4 )下的损失值较小,这正是我们追求的目标。
4.1 1-bit LLM 的时代:BitNet
正如前文所述,将量化位数降低到 4-bit 已经非常小了,但如果我们还要进一步降低呢?
这就是 BitNet[9] 的用武之地了,它使用 1-bit 表示模型的权重,每个权重都使用 -1 或 1 表示。3
它通过直接将量化过程整合到 Transformer 架构中来实现这一点。
Transformer 架构是大多数 LLMs 的基础,它依赖于线性层来处理序列数据,并在模型中执行关键的计算操作:

这些线性层(linear layers)通常使用更高的精度,如 FP16,它们也是大部分权重所在的地方。
BitNet 将这些线性层替换为他们称之为 BitLinear 的模型层:

BitLinear 层的工作原理与普通线性层相同,根据权重(weights)和激活值(activation)的乘积计算输出值(output)。
BitLinear 层使用 1-bit 来表示模型的权重,并使用 INT8 来表示激活值:

类似于 Quantization-Aware Training(QAT)技术,BitLinear 层在训练过程中执行一种 "伪" 量化,以便用来分析权重和激活值的量化效果:

NOTE:在论文中使用的是 γ 而不是 α ,但由于在本文中所举的例子一直使用 α ,所以我使用 α 。此外,请注意此处的 β 与前文在零点量化(zero-point quantization)中使用的 β 不同,它是基于平均绝对值(average absolute value)计算得出的。
让我们一步一步来学习 BitLinear 。
4.2 权重的量化 Weight Quantization
在训练过程中,权重以 INT8 的形式存储,然后使用一种称为 signum 函数的基本策略,将其量化到 1-bit。
这种方法的核心在于,它将权重分布(distribution of weights)重新调整到以 0 为中心,然后将所有小于 0 的值(左侧)设置为 -1 ,将所有大于 0 的值(右侧)设置为 1 :

此外,它还会跟踪记录一个值 β(平均绝对值(average absolute value)),我们稍后会用到它来进行反量化(dequantization)。
4.3 激活值的量化 Activation Quantization
为了量化激活值,BitLinear 利用 absmax 量化方法将 FP16 格式的激活值转换为 INT8 格式,因为矩阵乘法 (×) 需要更高精度的激活值。

同时,它还会跟踪记录 α(最高绝对值),我们将在后续的反量化过程中使用该值。
4.4 反量化过程 Dequantization
我们跟踪记录了 α(激活值的最高绝对值)和 β(权重的平均绝对值),因为这些值将在后续的反量化过程中帮助我们把激活值从 INT8 格式恢复到 FP16 格式。
输出激活值(output activations)通过 {α, γ} 进行缩放,然后进行反量化将其恢复到原始精度:

就是这样!这个过程相对简单,只需用两个值(-1 或 1)来表示模型。
根据这一 流程,作者发现随着模型规模的扩大,1-bit 形式和 FP16 形式训练的模型之间的性能差异逐渐缩小。
不过,这只适用于较大型的模型(参数超过 300 亿(30 B)),而对于较小型的模型,这个性能差距仍然很大。
4.5 所有 LLMs 实际上均为 1.58-bit
BitNet 1.58b[10] 就是为了解决之前提到的扩展性问题而提出的。4
在这种新方法中,模型的每一个权重不仅可以是 -1 或 1 ,还可以取 0 ,从而成为了一个三元模型。有趣的是,仅仅添加了 0 这一可取值就极大地提升了 BitNet 的性能,并使得计算速度大大提升。
4.5.1 The Power of 0
那么,为什么就添加了一个可取值 0 就能带来如此大的提升呢?
这与矩阵乘法的原理紧密相关!
首先,让我们了解一下矩阵乘法的一般工作原理。在计算输出值时,我们将权重矩阵(weight matrix)与输入向量(input vector)相乘。下图展示了权重矩阵第一层与输入向量相乘的过程:

请注意,这一过程包含两个步骤:首先将每个权重与输入值相乘,然后将所有乘积相加。
与此不同,BitNet 1.58b 则省略了乘法这一步骤,因为三元权重(ternary weights)实际上传达了这样的信息:
- 1: 我想要加上这个值
- 0: 我不需要加上这个值
- -1: 我想要减去这个值
因此,当权重量化到 1.58 bit 时,只需要执行加法运算:

这样不仅可以大大加快了计算速度,还可以进行特征过滤(feature filtering)。
将某个权重设置为 0 后,我们就可以选择忽略它,而不是像 1-bit 表示法那样要么加上要么减去权重。
4.5.2 Quantization 量化过程
在 BitNet 1.58b 中,进行权重量化(weight quantization)时采用了 absmean 量化方法,这是之前看到的 absmax 量化方法的一种改进形式。
这种方法通过压缩权重的分布,并利用权重的绝对平均值(α)来进行数值(value)的量化。之后,这些数值会被归整到 -1、0 或 1 :

相较于 BitNet,激活值的量化过程基本相同,但还是有一点不同。激活值不再被缩放到 [0, 2ᵇ⁻¹] 区间,而是通过 absmax 量化方法被调整到了 [-2ᵇ⁻¹, 2ᵇ⁻¹] 区间。
就是这样!1.58-bit 量化主要需要两种技巧:
- 通过添加可取值 0 构建三元数值表示法 [-1, 0, 1]
- 对权重实施 absmean 量化方法。
"13B BitNet b1.58 在响应延迟、内存占用和能耗方面,相较于 3B FP16 LLM 更高效。"
由于仅需 1.58 个 bits ,计算效率高,我们得以构建出更为轻量的模型!
05 Conclusion
我们的量化之旅到此告一段落!但愿本文能帮助你更深入地认识到量化技术、GPTQ、GGUF 以及 BitNet 的巨大潜力。未来模型的体积又将能够缩小到何种程度?真是令人期待啊!
如果要查看更多与 LLMs 相关的可视化内容,并希望支持我们,不妨留意一下我和 Jay Alammar 正在编写的新书。该书即将发行!

你可以在 O'Reilly 网站[11]上免费试读此书,或者直接在亚马逊[12]上预订。我们还会将所有相关代码同步更新到 Github[13] 上。
Resources
Hopefully, this was an accessible introduction to quantization! If you want to go deeper, I would suggest the following resources:
- A HuggingFace blog about the LLM.int8()[14] quantization method: you can find the paper here[15]. (译者注:LLM.int8() 量化方法)
- Another great HuggingFace blog about quantization for embeddings[16].(译者注:嵌入向量的量化问题)
- A blog about Transformer Math 101[17], describing the basic math related to computation and memory usage for transformers.(译者注:介绍了与 Transformer 的计算和内存使用相关的基本概念)
- This[18] and this are two nice resources to calculate the (V)RAM you need for a given model.(译者注:计算特定模型所需(V)RAM 的数量)
- If you want to know more about QLoRA5, a quantization technique for fine-tuning, it is covered extensively in my upcoming book: Hands-On Large Language Models[19].(译者注:QLoRA 技术的学习资料)
- A truly amazing YouTube video[20] about GPTQ explained incredibly intuitively.(译者注:GPTQ 技术的学习资料)
脚注:
- Frantar, Elias, et al. "Gptq: Accurate post-training quantization for generative pre-trained transformers." arXiv preprint arXiv:2210.17323 (2022).
- You can find more about GGUF on their GGML repository here[21].
- Wang, Hongyu, et al. "Bitnet: Scaling 1-bit transformers for large language models." arXiv preprint arXiv:2310.11453 (2023).
- Ma, Shuming, et al. "The era of 1-bit llms: All large language models are in 1.58 bits." arXiv preprint arXiv:2402.17764 (2024).
- Dettmers, Tim, et al. "Qlora: Efficient finetuning of quantized llms." Advances in Neural Information Processing Systems 36 (2024).
Thanks for reading!
Hope you have enjoyed and learned new things from this blog!
Maarten Grootendorst
Data Scientist | Psychologist | Writer | Open Source Developer (BERTopic, PolyFuzz, KeyBERT) | At the intersection of Artificial Intelligence and Psychology
END
🔗文中链接🔗
[1] https://en.wikipedia.org/wiki/IEEE_754
[3] https://huggingface.co/meta-llama/Meta-Llama-3-8B/tree/main
[4] https://arxiv.org/pdf/2210.17323
[5] https://www.youtube.com/watch?v=mii-xFaPCrA
[6] https://github.com/turboderp/exllamav2
[7] https://github.com/ggerganov/llama.cpp/pull/1684
[8] https://github.com/ggerganov/llama.cpp/pull/4861
[9] https://arxiv.org/pdf/2310.11453
[10] https://arxiv.org/pdf/2402.17764
[11] https://www.oreilly.com/library/view/hands-on-large-language/9781098150952/
[12] https://www.amazon.com/Hands-Large-Language-Models-Understanding/dp/1098150961
[13] https://github.com/HandsOnLLM/Hands-On-Large-Language-Models
[14] https://huggingface.co/blog/hf-bitsandbytes-integration
[15] https://arxiv.org/pdf/2208.07339
[16] https://huggingface.co/blog/embedding-quantization
[17] https://blog.eleuther.ai/transformer-math/
[18] https://huggingface.co/spaces/NyxKrage/LLM-Model-VRAM-Calculator
[19] https://www.amazon.com/Hands-Large-Language-Models-Understanding/dp/1098150961
[20] https://www.youtube.com/watch?v=mii-xFaPCrA
[21] https://github.com/ggerganov/ggml/blob/master/docs/gguf.md
本文经原作者授权,由 Baihai IDP 编译。如需转载译文,请联系获取授权。
原文链接:
https://newsletter.maartengrootendorst.com/p/a-visual-guide-to-quantization
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70018536/viewspace-3025644/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 为什么 AI Agent 重新爱上了文件系统(Filesystems)
- 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 2)
- 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 1)
- 微软多模态推理模型 Phi-4-reasoning-vision 训练经验分享
- 解构 MCP 的伪需求与 CLI 的真价值
- LLM 存在的一些问题,人类就不存在吗?
- OpenClaw 架构详解 · 第二部分:并发、隔离以及确保智能体正常运行的不变量
- OpenClaw 架构详解 · 第一部分:控制平面、会话管理与事件循环
- 目前市场上似乎只有三类真正可行的 AI 产品
- 为什么 AI 巨头们放弃私有壁垒,争相拥抱 Agent Skills
