定位问题 和 分析影响 。
以一次线上故障为例,工程师首先需要在日志中搜索
"out of memory"
、异常码或调用栈,快速定位相关日志;随后,还需要统计错误率、受影响请求数量、P99 延迟等指标,评估故障影响范围。
这两类工作看似属于同一个分析流程,但长期以来通常由不同系统完成:Elasticsearch 等搜索引擎负责全文检索, 等 OLAP 数据库负责聚合分析, 由此形成了日志平台中较为常见的“搜索引擎 + OLAP 数据库”双引擎架构。
近年来,分析数据库开始逐步引入原生全文检索能力,希望将文本搜索与 SQL 分析统一到同一个查询框架中。Apache Doris 提供的 函数,就是这一方向的实践 。
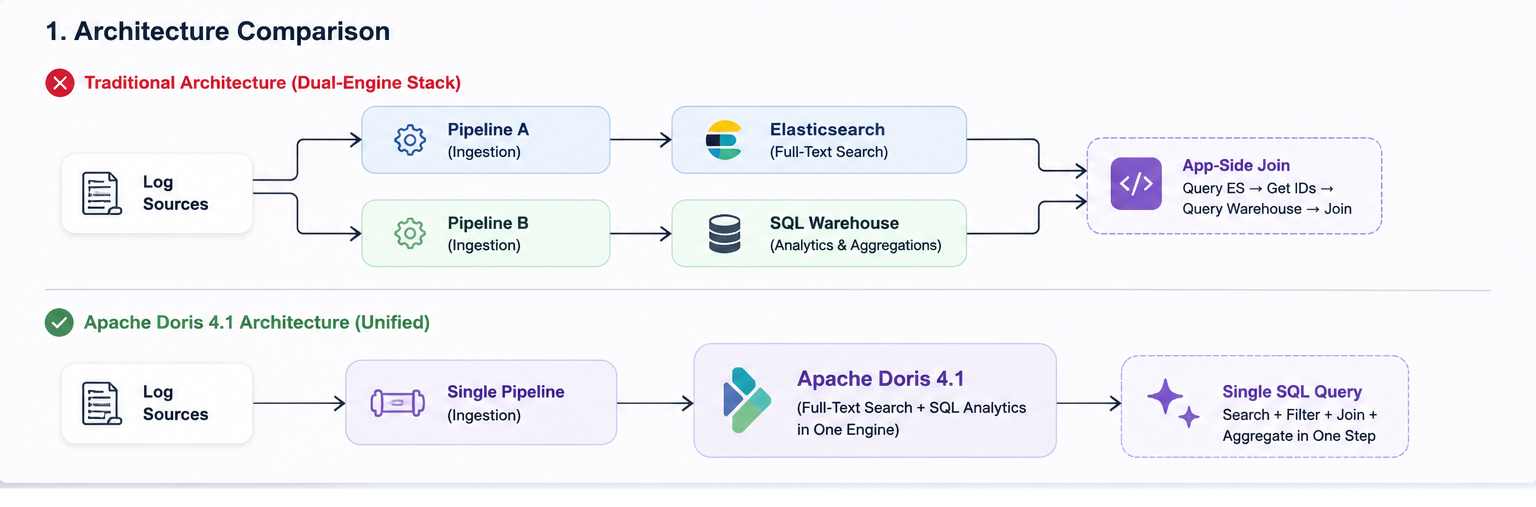
本文将结合日志分析场景,介绍这种实现方式,以及它如何简化传统双引擎架构中的查询流程。
双引擎架构带来了哪些挑战?
搜索引擎和分析数据库长期以来沿着不同的技术路线发展。
Elasticsearch、OpenSearch 等搜索系统以 Lucene 为核心,通过倒排索引(Inverted Index)支持关键词搜索、短语匹配、正则表达式和 BM25 相关性排序,更擅长从海量文本中快速定位目标内容。
OLAP 数据库则更关注大规模聚合分析,通过列式存储、向量化执行和数据压缩等技术,高效完成错误率、P99 延迟、请求分布等统计计算。
这种组合方式能够满足绝大多数业务需求,但随着数据规模和查询复杂度不断增加,两套系统之间的协同成本也开始显现。
-
首先,同一份日志通常需要分别写入搜索引擎和分析数据库,意味着需要维护两套存储、索引和数据链路。
-
其次,两套系统往往采用异步写入或同步机制。当数据写入高峰或同步链路出现延迟时,搜索结果和分析结果之间可能出现短暂的数据差异。
-
最后,一次完整查询往往需要跨系统完成。应用通常先从搜索系统获取符合条件的日志,再将结果转换为 SQL 条件,在分析数据库中继续完成聚合统计,这也增加了应用侧的查询协调逻辑。
这些问题并不会影响双引擎架构本身的可用性,但也推动分析数据库探索另一种实现方式: 将全文检索直接纳入 SQL 查询执行流程。
将全文检索融入 SQL 查询
提供的
search()
并不是
LIKE
或正则表达式的简单封装,而是建立在原生
之上,使全文检索能够直接作为 SQL 查询条件参与执行。
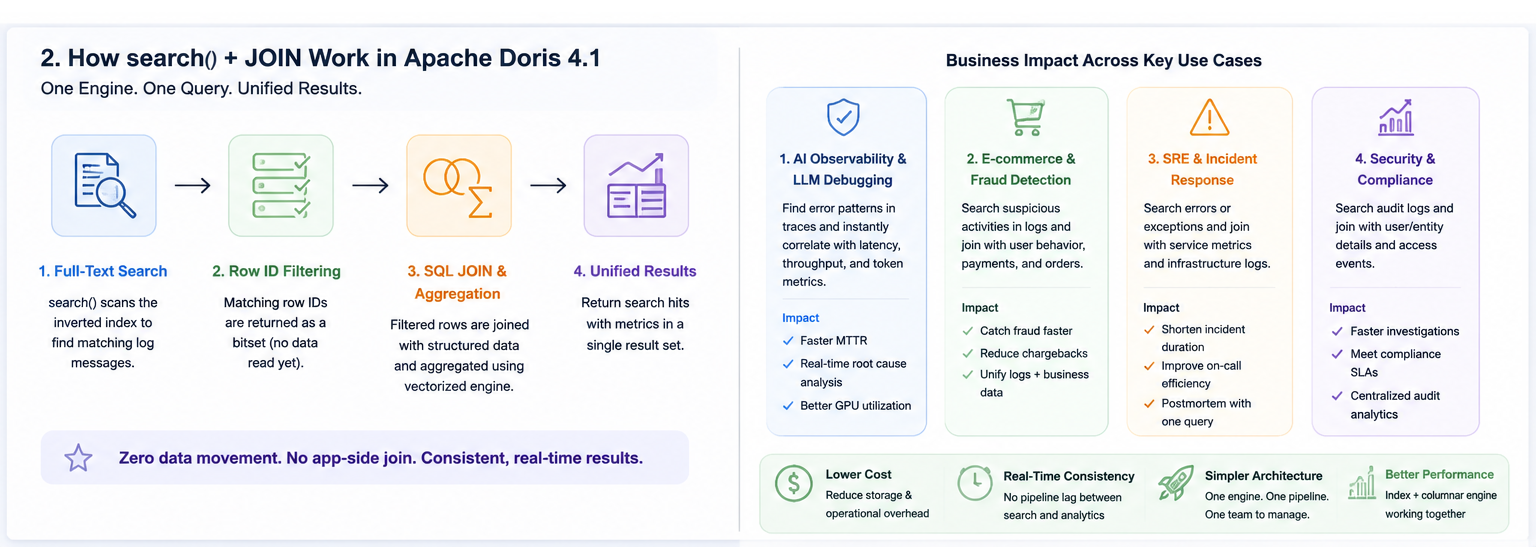
例如:
SELECT model_name, COUNT(*)FROM ai_inference_logsWHERE SEARCH( 'log_message:"out of memory" OR log_message:/cuda.*error/')GROUP BY model_name;
这条查询先通过倒排索引筛选包含
"out of memory"
或匹配
cuda.*error
正则表达式的日志,再直接按模型统计错误数量。对于使用者来说,文本搜索和聚合分析可以在同一条 SQL 中完成。
那么,
search()
是如何做到这一点的?
search()
是如何执行的?
search()
的执行过程可以简单理解为:
先通过倒排索引缩小数据范围,再交给查询引擎完成后续分析。
-
索引与数据同步维护。日志写入 Doris 时,会为配置了倒排索引的字段生成对应索引,并与数据保持一致的生命周期管理。
-
先通过倒排索引过滤。查询执行时,Doris 根据
search()条件从索引中定位匹配数据,在读取查询所需列之前缩小扫描范围。 -
继续完成 SQL 分析。过滤后的数据直接进入 Doris 查询引擎,继续执行聚合和排序。如需相关性排序,可以使用
score(),但它需要配合ORDER BY score() DESC和LIMIT形成 Top-K 查询,不能直接用于聚合函数。
当查询还需要关联维表时,应先在直接作用于单表扫描的子查询中完成
search()
过滤,再将过滤结果参与 JOIN 和后续聚合。
常见使用场景
search()
的价值并不局限于单纯的日志检索。对于同时包含非结构化文本和结构化指标的数据场景,全文检索结果可以直接参与后续聚合分析。下面以三个典型场景说明这种查询方式的应用。
AI 可观测性和 LLM 基础设施调试
LLM 推理平台通常同时产生两类数据:一类是延迟、Token 数量、模型名称等结构化指标,另一类则是 CUDA Error、Out of Memory、Timeout 等非结构化运行日志。
在实际故障排查中,工程师通常不只需要定位异常日志,还需要进一步判断哪些模型受到影响、错误出现了多少次,以及故障期间的请求延迟是否发生明显变化。
例如,可以为日志字段建立倒排索引,并按天自动创建分区:
CREATE TABLE ai_inference_logs ( log_time DATETIME NOT NULL, trace_id VARCHAR(64), model_name VARCHAR(64), prompt_tokens INT, completion_tokens INT, latency_ms INT, log_message STRING, INDEX idx_log_message (log_message) USING INVERTED PROPERTIES( "parser" = "unicode" ))ENGINE = OLAPDUPLICATE KEY(log_time, trace_id)AUTO PARTITION BY RANGE(date_trunc(log_time, 'day')) ()DISTRIBUTED BY HASH(trace_id) BUCKETS 16PROPERTIES ( "inverted_index_storage_format" = "V3");
当需要分析最近两小时内的模型异常时,可以直接通过
search()
匹配相关错误信息,并在同一查询中统计错误次数、P99 延迟和 Token 使用情况:
SELECT model_name, COUNT(*) AS total_errors, PERCENTILE(latency_ms, 0.99) AS p99_latency_ms, AVG(prompt_tokens + completion_tokens) AS avg_tokens_per_requestFROM ai_inference_logsWHERE log_time >= NOW() - INTERVAL 2 HOUR AND model_name IN ('llama-3-70b', 'mistral-large') AND SEARCH( 'log_message:"out of memory" OR log_message:/cuda.*error/ OR log_message:timeout*' )GROUP BY model_nameORDER BY total_errors DESC;
这条查询通过
search()
匹配
"out of memory"
、
cuda.*error
和
timeout*
等异常日志,同时按模型统计错误数量、P99 延迟和平均 Token 消耗。
如果还需要查看相关性较高的代表性错误日志,应将
score()
放在独立的 Top-K 查询中:
SELECT trace_id, model_name, log_message, score() AS relevance_scoreFROM ai_inference_logsWHERE log_time >= NOW() - INTERVAL 2 HOUR AND model_name IN ('llama-3-70b', 'mistral-large') AND SEARCH( 'log_message:"out of memory" OR log_message:/cuda.*error/ OR log_message:timeout*' )ORDER BY relevance_score DESCLIMIT 100;
对于 AI Observability 场景来说,日志搜索不再局限于定位错误,还可直接与结构化指标结合,以进一步评估故障影响。
网络安全与 SIEM 威胁狩猎
在安全分析场景中,关注点与普通日志排障有所不同。
SOC 通常需要从大量认证、Firewall 和系统审计日志中识别特定事件模式,例如
"failed password"
、
UNAUTHORIZED_ACCESS
或
sudo denied
,随后再判断这些异常事件是否集中来自某些 IP,以及涉及多少用户账号。
例如:
SELECT source_ip, COUNT(*) AS total_suspicious_events, COUNT(DISTINCT user_id) AS targeted_account_count, GROUP_CONCAT(DISTINCT action) AS observed_actionsFROM security_audit_logsWHERE event_time >= NOW() - INTERVAL 15 MINUTE AND SEARCH( 'raw_event:"failed password" OR raw_event:UNAUTHORIZED_ACCESS OR raw_event:/sudo.*denied/' )GROUP BY source_ipHAVING total_suspicious_events > 20ORDER BY total_suspicious_events DESC;
这里,文本检索用于识别具有特定安全特征的事件,而
GROUP BY
、
COUNT()
和
COUNT(DISTINCT)
则进一步将离散日志转换成 IP 维度的行为特征。
相比单纯搜索某条异常日志,这类查询更关注“异常是否形成持续性或集中性行为”。例如,同一来源 IP 在短时间内针对多个账号持续触发认证失败,就可以通过聚合结果进一步识别出来。
因此,在 SIEM 场景中,
search()
更像是事件模式筛选器,而 SQL 聚合负责完成后续行为分析。
电商产品搜索与业务分析
商品销售团队希望将搜索行为与销售额挂钩。例如,在电商场景中,商品运营人员可能希望筛选商品描述中同时包含
"noise cancelling"
和以
wireless
开头词项的商品,并进一步观察不同品牌的商品数量、平均价格和销售额:
SELECT brand_id, COUNT(*) AS matching_product_count, AVG(price) AS average_price, SUM(sales_count * price) AS total_revenue_generatedFROM product_catalog_eventsWHERE SEARCH( 'product_description:"noise cancelling" AND product_description:wireless*' ) AND price BETWEEN 50.00 AND 300.00GROUP BY brand_idORDER BY total_revenue_generated DESC;
在这一场景中,全文检索用于描述商品属性;后续 SQL 分析则直接关联价格、销量和销售额等业务指标。
从这几个场景可以看到,
search()
所解决的问题并不局限于某一种数据类型。只要查询同时包含“从文本中筛选目标数据”和“围绕筛选结果进行结构化分析”两个步骤,都可以考虑将全文检索直接纳入 SQL 查询流程。
Apache Doris 4.1日志索引实践建议
在日志场景中使用倒排索引时,可以重点关注三个方面:
-
选择合适的 Parser。对于通用、多语言系统日志,可以使用
unicode或standard;英文或中文文本可以根据实际内容选择对应的语言解析器。对于trace_id、user_id等需要精确匹配的标识符,则更适合使用none,避免对字符串进行分词。需要注意,对于分词倒排索引,/cuda.*error/一类正则表达式作用于索引词项,不等同于对完整原始日志执行 SQLREGEXP,因此不能保证匹配跨多个 Token 的文本。 -
按时间分区。日志表可以通过
AUTO PARTITION BY RANGE(date_trunc(log_time, 'day')) ()按天自动创建分区,也可以显式定义 Range 分区。结合 Partition Pruning,可在查询最近几小时或几天的数据时提前排除无关历史分区。 -
存储分层控制成本。对于需要长期保留的日志,还可以结合冷热分层存储,将近期高频访问的数据保存在本地 SSD,将较早的数据迁移至 Amazon S3、HDFS 等成本更低的存储介质,在查询性能与长期存储成本之间取得平衡。
结束语
由上可知,
search()
这种统一的查询方式,有助于简化日志分析流程,减少跨系统的数据流转,为 Observability、AI 基础设施运维以及安全分析等场景提供更加一致的使用体验。
对于企业生产环境,如果需要云原生部署、弹性资源管理、企业级安全保障以及商业技术支持,
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70017904/viewspace-3181358/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Apache Doris x Fluss:面向湖流一体的统一查询与分析
- Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
- StarRocks 迁移至 Apache Doris 完整指南:三步完成结构、数据与业务平滑切换
- 快手基于 Apache Doris 千亿多模态检索的实践
- 某头部保险公司基于 SelectDB 的统一 OLAP 架构实践
- Doris 直查 Paimon 索引:快手湖上向量检索的共建与落地
- Apache Doris+ Paimon 2.0:构建 Agentic AI 数据闭环
- Apache Doris + Lance:让多模态数据真正进入智能驾驶与具身智能的分析闭环
- Apache Doris 5.0 年度版本前瞻(一):构建统一的多模湖仓实时分析平台
- 开源!Apache Doris 上线 Profile 可视化诊断:基于 Doris Skills 破解 AI 误诊难题
