计算机技术的四十年发展:站在巨人的肩膀上
1984 年 5 月,距今四十年前,那时我还在读高一。我们高中的物理老师邀请了湖南物理学会会长陈积华老师来校作报告,题目就是《第三次浪潮》这本书的名字。听完报告后,我们感到无比振奋,简简单单的 0101 数字串竟然蕴含如此巨大的魔力,让我们意识到信息革命的曙光已经到来。
更为幸运的是,受邓小平同志“电脑要从娃娃抓起”指示的影响,我所在的长沙县一中获赠了共青团中央的六台 Laser 310 个人电脑。当时,正在参加无线电兴趣小组的我立即放下了对收音机的研究,转而加入计算机兴趣小组,开始学习 Basic 语言编程。当时的 Laser 310 电脑,仅仅是一个键盘,需要连接电视机作为显示器,内存只有 64K,但在当时,它是一件极其神奇的设备,因为绝大多数中国人从未见过计算机,更别说使用过。
八十年代,个人电脑开始逐渐普及。幸运的是,1994 年我有幸赴美国印第安纳大学留学,初到校园就使用上了 Mosaic 浏览器。我如饥似渴地浏览各种信息,Mosaic 的推出标志着人类正式步入互联网时代,也由此催生了谷歌、亚马逊、阿里巴巴和腾讯等伟大公司。
2007 年,在我任职于摩托罗拉手机部门期间,一件具有里程碑意义的事件发生了:iPhone 正式发布。这标志着人类步入移动互联网时代,彻底改变了我们的日常生活,从阅读、出行、健身到饮食。同时,通过互联网,不仅人与人之间建立了联系,各种设备也相互连接起来,汽车、自行车、轮船、充电宝等都实现了联网,真正进入了万物互联的时代。
2016 年底,我意识到这一趋势不可阻挡,这些联网设备将产生海量的时序数据,需要一个高效、具有极强水平扩展能力且简单易用的工具来处理。因此,我开启了第三次创业之旅。2017 年 6 月,涛思数据正式成立。2018 年底,我们推出了产品 TDengine。2019 年 7 月,我们将 TDengine 开源,这也让我们今天有这个缘分能够聚集在此,共同探讨。
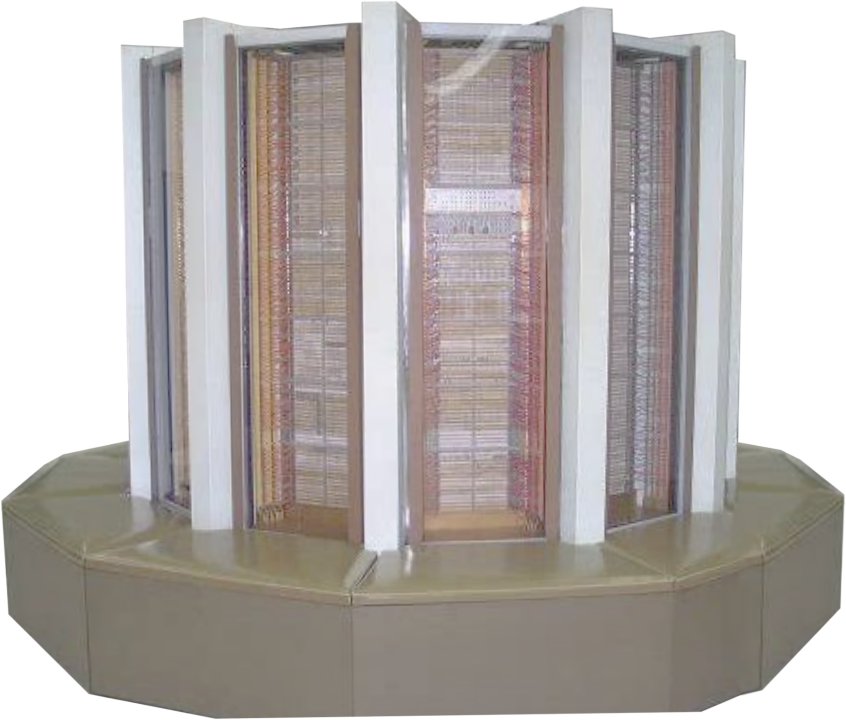
在这里,我想与大家分享一张图片。这是 1983 年底国防科大研制的银河亿次巨型计算机。当时,它是世界领先的计算机系统,与美国的 Cray 巨型机比肩。作为一个长沙人,当时我正在读高一,对此感到无比自豪。现在回过头看,iPhone 体积虽小,但运算速度已超过 2 万亿次,是当年银河巨型机和 Cray 巨型机的 2 万倍以上。人类科技发展的速度令人难以想象。
用历史数据预测未来数据:TDgpt 初次面世
这些技术的变革和发展,不仅展示了信息革命的力量,也激励着我们不断创新、追求卓越。而人类科技的进步从未停止,而且还在加速。
十年前,移动互联网浪潮之后,2012 年,Hinton 的关于 ImageNet 分类的论文发表,2016 年 AlphaGo 战胜围棋名将李世石,标志着人类正式进入 AI 时代。如今,人脸识别无处不在,各种图像处理工具不再是设计师的专利。本来,AI 的热潮似乎已经降温,但谷歌在 2017 年发表的一篇标志性论文再次将 AI 推向高潮。2022 年 11 月,ChatGPT 问世,其生成式 AI 的惊艳表现让全球陷入了 AI 的狂热之中。现在,大家都可以用 AI 生成文字、报告、图片、视频,甚至是代码和考试题。大家也可以用 ChatGPT 来写 TDengine SQL 语句,会有意想不到的结果。
就在本周三(2024 年 7 月 24 日),Meta 又宣布推出 405B 的 Llama 3.1,使开源的 LLM 各项指标紧逼甚至超过了闭源的 GPT-4。这真是一个令人激动的时代,AI 的浪潮势不可挡。我们在座的各位,来自智能制造、石油、石化、钢铁、电力、新能源、汽车等行业,都是 IT 从业者。我相信大家都已经感受到 AI 的这股浪潮,一个典型的问题便是:“我能做什么?”大家心中难免忐忑:我这个年龄,还能学会 AI 吗?我的工作是否会被 AI 取代?我如何将 AI 技术应用到我的工作中去?
taos> select _rowts, forecast(ts, val, 300) from demo.d100;
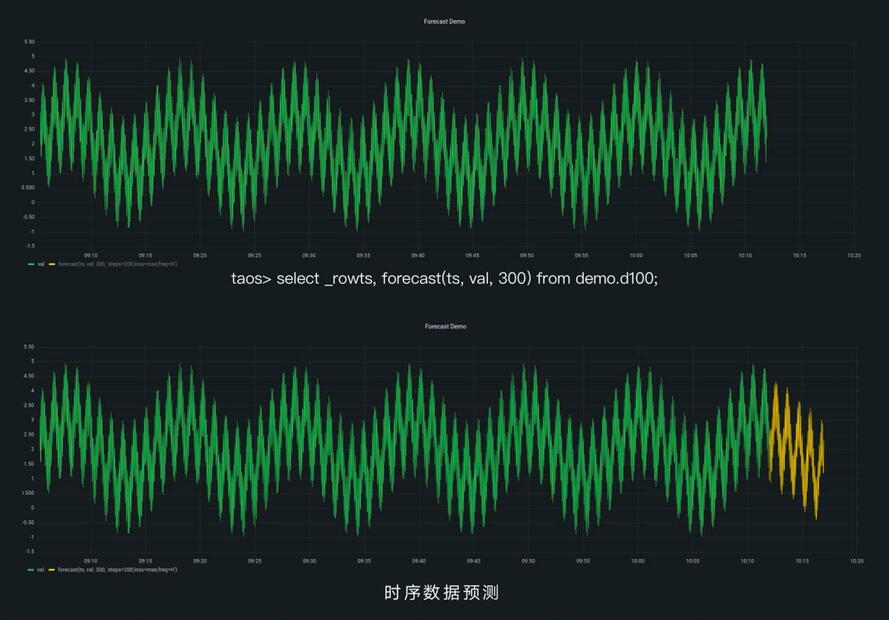
使用 Grafana 绘制而成的时序数据预测图
大家看,这数据预测的是不是很完美?因此,我要告诉大家的是,AI、大语言模型与工业的距离并不遥远,是可以打通的,它不仅能生成文字、视频,还能帮你预测时序数据。TDengine 用一条 SQL,就带你进入了 AI 时代。时序数据预测这项功能很重要,它有很多应用场景,包括:发电机组、变压器、采油设备、数控机床等设备的预测性维护,风能、太阳能等可再生能源的发电量预测,汽车零件、芯片、视频、药品、工业产品的质量控制改进,石油、天然气、新能源等产量及用量预测。
下面我再给大家展示一个 Demo。这是一个传感器采集的数据,很有规律,但很明显,有些数据点有异常,而且无法依靠简单的阈值判断来检测。那 AI 能检测出异常数据吗?我们再在 TDengine 里执行一条 SQL:
taos> select _rowts, anomaly(ts, val, 99) as anomaly from demo.d200;
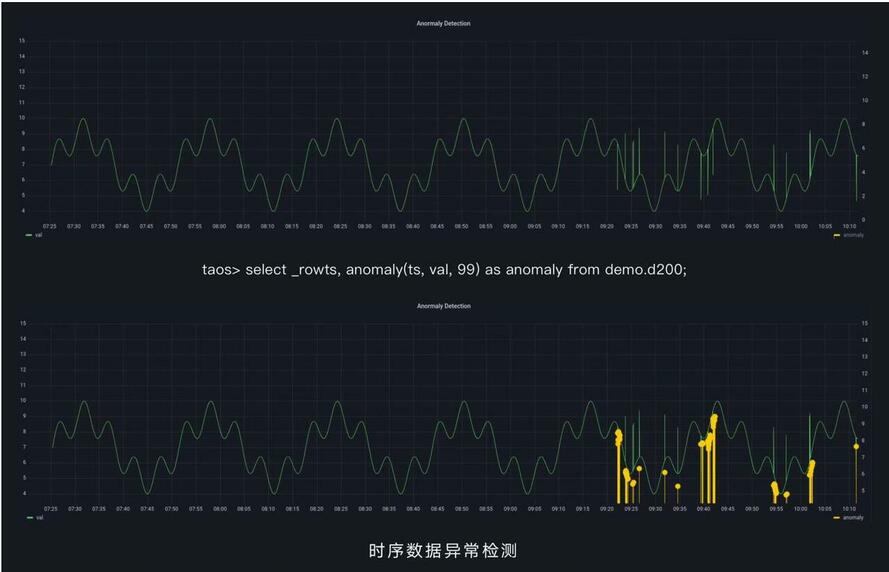
如上图所示,这些异常的时间片段都被标注出来了,这真的很神奇。除了做时序数据的预测,AI 还能帮我们进行时序数据的异常检测。这一功能的应用场景也非常广泛:在质量控制上,它能帮助我们监测生产过程中的异常,及时调整生产参数;它还能实时检测分析电网数据,检测电网中的异常情况,保障电网稳定性;再能耗分析上,能检测能耗模式中的异常,发现能源浪费的情况,识别改进区域;还能维护网络安全,通过检测车载通信数据异常,识别可能的网络入侵或攻击。
此外,TDengine 还可以通过 AI 对时序数据做更多的分析和处理,比如数据清洗、缺失数据的填充等等,也可以帮助大家优化工业流程,提升效率。而且通过 TDengine 特有的 SQL 命令扩展,用起来极为简单。

科技的发展速度真的超出了大家的想象。技术已经准备好了,但我们来自各传统行业的朋友们,你们准备好了吗?从我的角度来看,在采用先进的 AI 大语言模型技术之前,我还看到了数字化转型的五大挑战,下面让我一一道来。
AI 时代下企业数字化转型面临的五大挑战,如何解决?
挑战一:数据质量
第一个挑战是数据质量问题,这在各类数据源中表现得尤为突出。不管是油田企业还是烟机企业,都面临着各条产线的数据源数量繁多且标准不一的问题。举例来说,数据的物理单位可能有所不同,有的使用秒,有的则用毫秒。同一物理量的命名也不统一,有些地方称为“温度”,而另一些可能用英文缩写“WD”表示。此外,采样频率、时区也存在差异。随着中国制造业走向全球,在多个国家设有工厂,如何有效地将这些数据整合在一起成为一大难题。
挑战二:数据语境
过去两年里,我在欧美有过长时间的停留,除了数据质量问题外,我观察到的另一个重大挑战是数据语境(Data Contextualization)。当我们采集了上亿个时间线并存储到数据库中后,想要弄清每一个时间线具体代表什么其实是非常困难的。通常,我们需要为每个传感器、每条时间线打上各种标签和层次信息。对于智能制造领域,如石油、烟机和电力行业,还需要附加批次、工班等信息,并将数据与 ERP、MES 系统关联起来。只有在这种情况下,数据才真正有意义,仅仅看存在数据库中的数据是没有价值的,语境的赋予至关重要。
- 每张表可以支持多达 128 个标签,每个标签代表一个维度,维度可以是树状结构。
- 不同的管理角色可以对应不同的维度,从而实现更精细的权限管理。
- 列支持标签功能。
- 树状结构中的任一节点都可以挂载任意类型的数据。
- 支持与其他数据库的关联查询,无论数据是来自 Oracle 还是 PI 系统,都可以轻松获取。
- 可以任意获取树状结构中任一节点在任一时刻的断面数据。
挑战三:边云协同
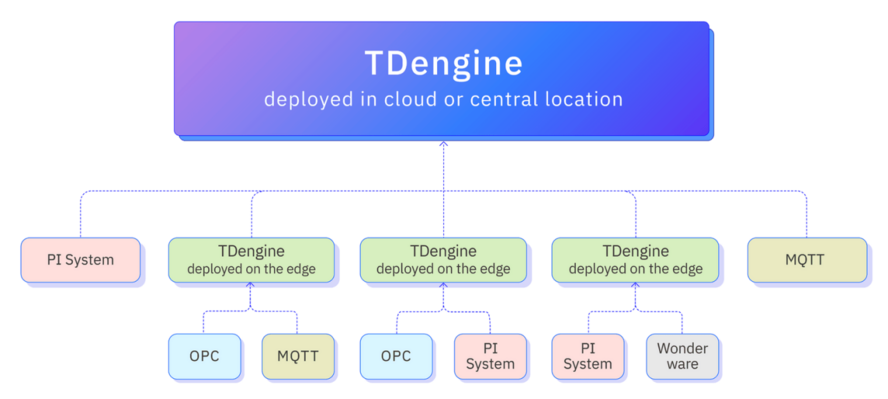
我们面临的第三个挑战是“边云协同”,这是一个大家经常讨论的话题。边云协同的理解起来很简单,边缘侧一般不会搞云端部署而是做本地部署,计算资源有限,并且有着严格的实时性要求,多个边缘节点的数据最终需要汇聚到云端。
挑战四:数据规模
第四个挑战是数据规模的问题,这也是 TDengine 最初设计时就着力解决的核心问题之一。传统行业中,一个实时数据系统拥有 10 万个测点已经相当不错,但如今,百万测点的系统已成为常态,这给传统的实时数据库带来了巨大的挑战。此外,随着数据汇聚趋势的兴起,集中监测需求不断增加,尤其是在新能源领域,数据量呈现爆炸式增长。我们的一些客户每天产生的数据量超过 3TB,而有的客户传感器测点数量甚至超过 5000 万。企业期望的数据存储时间也变得更加长久,很多企业希望能保留数据一年,甚至十年。
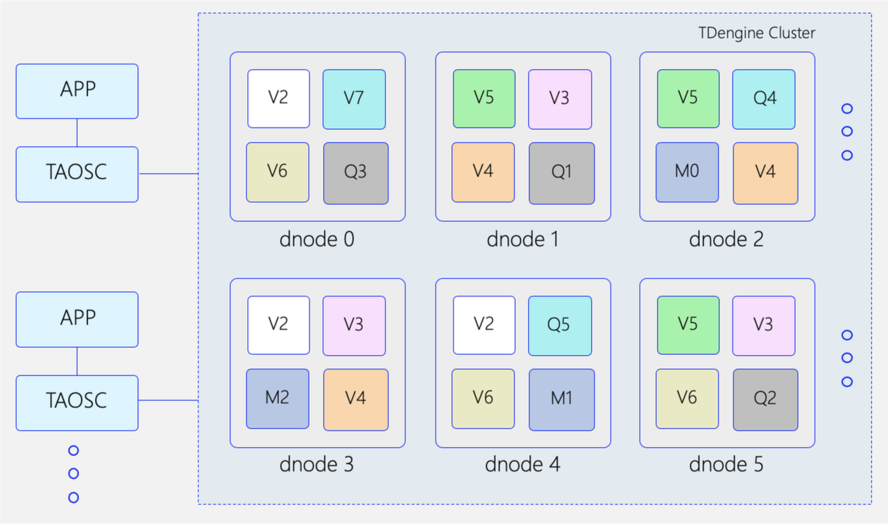
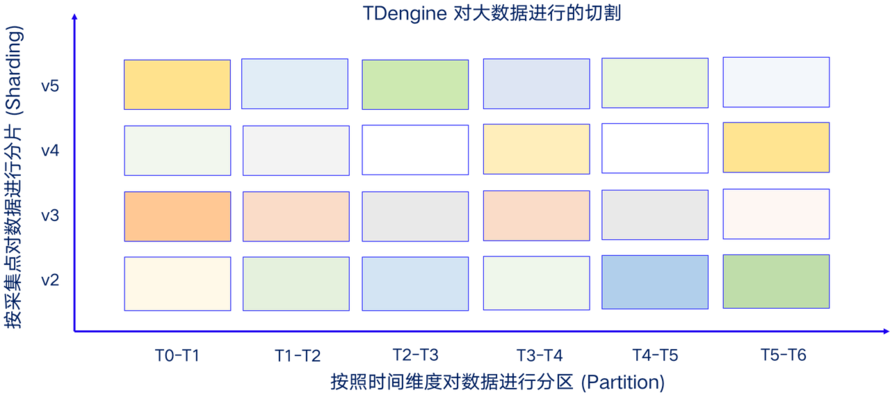
得益于这种分布式架构,TDengine 目前能够支持 10 亿张表,且性能几乎没有下降,启动速度可以保持在一分钟以内。TDengine 还完美解决了时序数据库中“高基数”问题,当时间线数量达到几百万、上千万甚至上亿时,传统数据库性能通常会急剧下降,而 TDengine 的水平扩展能力使其在面对高基数问题时依然保持卓越性能。

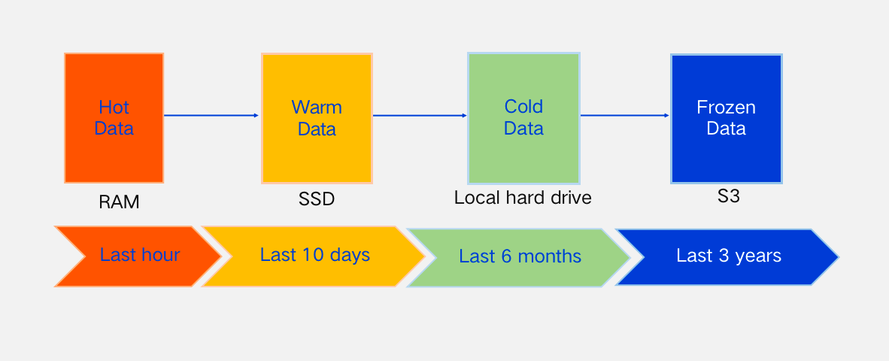
挑战五:开放系统
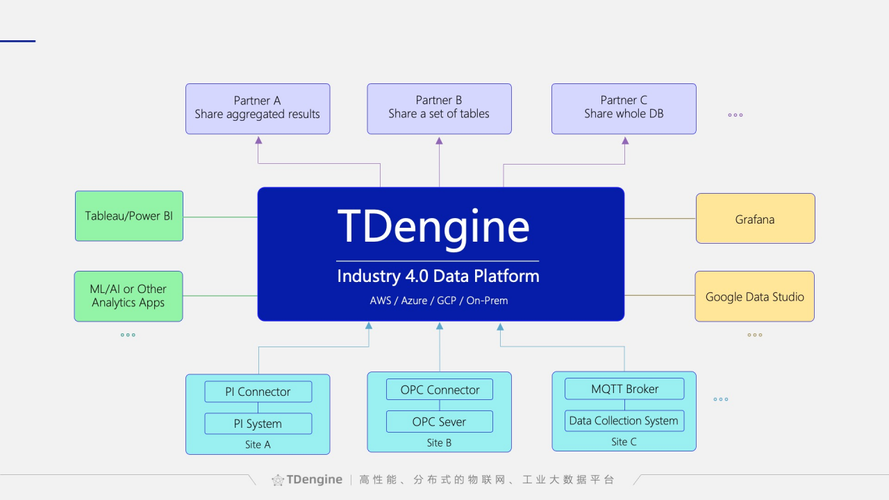
最后一个挑战是开放系统的问题,这是许多企业在选择数据库时所面临的共同困境。众所周知,一些知名数据库厂商往往通过技术壁垒将用户牢牢绑定,而在当前 IT 技术迅猛发展的时代,新的数据处理技术和应用层出不穷,用户显然不希望被某一厂商束缚。因此,TDengine 致力于为用户提供一个开放的系统,避免供应商锁定,让用户能够自由选择最适合的解决方案。
- 与 Power BI、Tableau、Seeq、帆软、永洪等 BI 工具对接,方便用户进行商业智能分析。
- 与 Grafana、Google Data Studio 等可视化软件对接,助力用户实现数据的可视化呈现。
- 与 DBeaver、qStudio 等数据库管理工具对接,方便用户管理和维护数据库。
- 与任何支持 JDBC、ODBC 接口的第三方系统对接,确保用户可以灵活选择各种数据处理工具。
结语:让人人都能用的上的时序数据库
在当前 AI 和大数据人才紧缺的背景下,TDengine 如何帮助企业应对这一挑战?我们的设计目标就是大幅降低对高端技术人才的需求。为此,我们设计了零代码的数据写入功能,并通过标准 SQL 实现数据分析、流计算、预测和异常检测功能,使用户能够在 60 秒内开箱即用。降低使用门槛的背后,是我们对人才要求的进一步简化和降低。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70014783/viewspace-3027378/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- TDengine IDMP 2.0.2 发布:元素关系可视化、数据建模与联邦查询三大升级
- 栖息地 AI 超恒气候系统用 TDengine 支撑全屋环境品质实时监测与历史追溯
- 腾讯WorkBuddy x 涛思数据:TDengine 连接器与4位专家使用指南
- TDengine 亮相 ICC 2026,在北美自动化大会展示 AI 原生工业数据平台
- 万家乐用 TDengine 构建 IoT 数据底座:让数十万台热水器实现"主动售后"
- 涛思数据亮相第十二届国际智能制造暨工业AI论坛
- TDengine入驻腾讯WorkBuddy:1个连接器+4位顾问,让工业数据流AI起来
- TDengine荣获第十一届"创客中国"工业智能体大赛企业组一等奖
- 从"极速算"到"知识沉淀":工业 AI 实战直播(十三、十四期)
- 存储成本降低80%,Zendure用TDengine支撑117万台设备的能源数据分析
