对于数据采集工程师而言,他们的主要需求是简单、高效地收集数据。为此,可以考虑创建一个贴源层,该层的数据模型建议与数据源完全一致。这种方式能够大大简化数据采集的过程,使得数据采集工作更加轻松和直观。参见上图贴源层。
另一方面,对于数据应用开发工程师来说,他们需要处理不同业务部门的需求。这些工程师希望数据能够按照业务主题分类,并能够按照预期的访问方式来建模。为了满足这一需求,需要在数据模型中考虑访问层的设计,使得数据应用更加便捷。参见上图访问层。
显然,在数据采集和数据应用之间存在着巨大的鸿沟,那我们 如何才能完成时序数据从采集到应用的转换?这就需要引入数据分层的思想。具体来说,可以在贴源层和访问层之间增加一个整合层,用于完成时序数据的时间戳对齐、关联整合、数据汇聚和数据转换等功能。这一整合层的引入,能够实现从数据采集到数据应用的无缝转换,满足不同阶段的需求。
本篇文章将从时序数据采集和应用面临的挑战及需求出发,为大家分析 TDengine 数据建模的原理与方法,并通过实际案例帮助读者更好地理解和应用这些概念。
时序数据的采集和应用开发
采集面临的挑战
对于时序数据采集工程师来说,面临的挑战主要是 数据源的格式、数据传输方式、 采集入库后的数据模型,在贴源层与采集源的模型按照 1:1 创建方式下,数据源的格式和入库后的数据模型的格式对齐了,也就不需要担心格式不同导致的问题了。
-
单表多列模型:对于数据源来说,如果一个数据采集设备的所有测点,在数据上传时都是一起上传,那么,可以建立单表多列模型的超级表。也就是说,创建一个超级表,该表中包含该采集设备的所有测点指标。
-
多表多列模型:对于数据源来说,如果一数据采集设备包含多个测点,但这些测点的采集频次并不相同,举例来说:该设备总共采集 120 个测量指标,其中前 40 个测点的采集周期是秒级、中间 40 个测点采集周期是 1 分钟级、最后 40 个测点的采集周期是 5 分钟级,那么,我们需要分别创建三个超级表,第一个超级表包含前 40 个测量值,第二个超级表包含中间 40 个测量值,第三个超级表包含最后的 40 个测量值。这就是多表多列模型,也就是说,创建多个超级表,每个超级表也包含多个列。
-
多表单列模型:如果数据源是每个测点单独上报,并且每个测点的采集时间戳并不相同,对于这种情况,需要按照数据类型分类,采用多表单列模型。也就是说,每个超级表中只包含一个数据类型,比如 double、int、varchar 等等,每种数据类型一个超级表。子表按照数据类型+设备类型来创建,让子表的数量保持在合理的规模,这样能够利用多个 Vnode来保障性能。
应用开发面临的挑战
对于时序数据应用开发的工程师来说,时序数据能否按照业务主题划分、能否支持实时查询和批量查询等业务场景,这些因素都十分关键。如下图所示:
-
按照主题划分:以卷烟厂为例,卷烟厂包括多个车间如制丝和卷包,对应的业务应用往往有制丝集控、卷包数采等等。如果我们将这些业务应用按照业务主题划分,分别进行数据建模就能够极大地方便应用开发。各个业务主题共享数据整合层的数据,整合层的数据来源于贴源层,是经过时间戳对齐、数据关联整合、数据汇聚的。
-
支持实时查询:对于时序数据来说,实时监控是非常典型的业务场景,TDengine 提供了缓存、流计算和数据订阅三种方式,供应用层实时访问。
- 缓存:对于实时监控场景,TDengine 提供了缓存功能,在创建数据库时,可以通过设置 CACHEMODEL 参数,让 TDengine 在内存中缓存各个子表的最新数据。对于业务应用来说,可以通过 last_row/last,从缓存中实时读取设备的最新状态。
- 流计算:TDengine 的流式计算引擎提供了实时处理写入数据流的能力, 使用 SQL 定义实时数据流的转换规则,当数据被写入流的源表后,数据会被以指定的方式自动处理,并根据指定的触发模式向目标表推送计算结果。它 提供了替代复杂流处理系统的轻量级解决方案,并且,能够在高吞吐的数据写入的情况下,将流计算的延迟控制在毫秒级。
-
数据订阅:除了上述的流计算,TDengine 还提供了类似 Kafka 的数据订阅功能,帮助应用实时获取写入 TDengine 的数据,或者以事件到达顺序处理数据。TDengine 的 topic 有三种,可以是数据库、超级表、或者一个 SELECT 语句。这种方式提供了更大的灵活性,数据的颗粒度可以随时调整,而且数据的过滤与预处理交给 TDengine,有效地减少传输的数据量,并且,降低了应用开发的复杂度。
-
支持批量查询:对于批量时序数据查询场景,TDengine 提供了 SQL 接口给上层应用查询批量数据使用。也提供了诸多时序数据窗口函数,包括计数窗口(count window)、时间窗口(time window)、状态窗口(status window)、会话窗口(session window)、事件窗口(event window)等多种窗口。
-
taosx:除了通过 SQL 查询之外,对于数据量比较大,需要通过文件或数据库接口同步数据的场景,还可以考虑使用 taosx 来同步数据。
-
数据建模原理和方法
数据建模原理
首先,我们来观察一下 TDengine 是如何将规模很大的数据切分成很多个数据块的。TDengine 分别从采集点维度和时间戳维度对大规模数据进行 分片(Sharding)和 分区(Partition),如下图所示 。
对于数据建模来说,我们要充分利用 分片(Sharding)和 分区(Partition)这两大维度对数据进行切分,确保在查询时,我们的过滤条件(Where 子句)能够直接定位某个、或者某几个数据块,数据块的个数越少越好。定位到的数据块越少,说明过滤的越高效,所需要的磁盘IO带宽越小,查询速度也越快。
数据建模基本概念
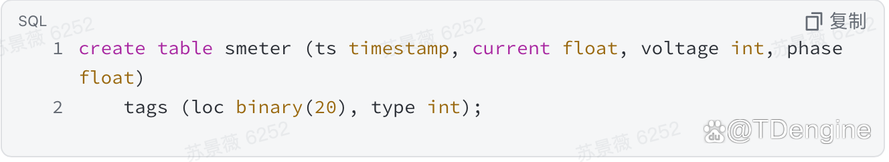
智能电表是典型的时序数据场景。假设每个智能电表采集电流、电压、相位三个量,有多个智能电表,每个电表有位置 Location 和 type 的静态属性。其采集的数据类似如下的表格:
每一条记录都有设备 ID、时间戳、采集的物理量(如上表中的
current、
voltage
和
phase)以及每个设备相关的静态标签(
location
和 type)。
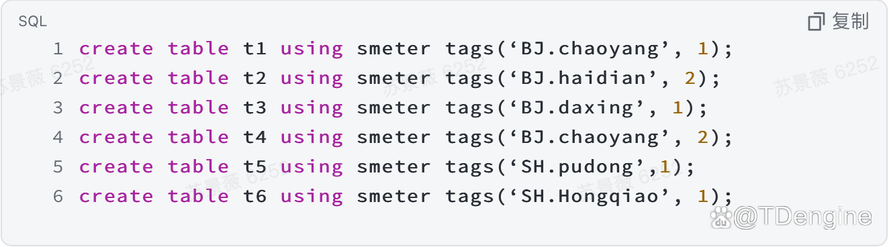
- 数据采集点(Data Collection Point):数据采集点是指按照预设时间周期或受事件触发采集物理量的硬件或软件。智能电表示例中的 d1001、d1002、d1003、d1004 等就是数据采集点。为充分利用其数据的时序性和其他数据特点,TDengine 采取 一个数据采集点一张表的策略,按照此策略,上述 d1001、d1002、d1003、d1004 分别建表。
- 标签(Label/Tag):标签是指传感器、设备或其他类型采集点的静态属性,不随时间变化。比如设备型号、颜色、设备的所在地等。
-
采集量(Metric):采集量是指传感器、设备或其他类型采集点采集的物理量。比如电流、电压、温度、压力、GPS 位置等,是随时间变化的。数据类型可以是整型、浮点型、布尔型,也可是字符串。
创建超级表
创建子表
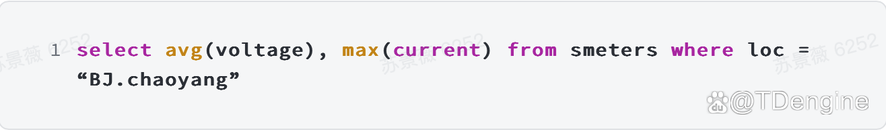
聚合查询
多维分析

TDengine 数据建模优势
- 超级表可以向普通表一样查询,但 可以指定标签的过滤条件
- 标签可以多至 128 个,每个标签代表一个维度
- 标签可以事后增加、删除、修改。这样数据建模时,可以先不确定标签或分析维度
-
每个标签,可以是一树状结构,比如“北京·朝阳·望京”,这样便于缩小搜索范围
数据建模案例
以新能源充电站建模场景为例。
背景信息
- 充电站管理的充电桩大约有几百个,每个充电桩每天可能多次进行充电
- 每次充电产生一个充电订单,充电订单 每年大约有 1000 万个,数据需要 保留 2 年
- 需要监控充电过程中电压、电流等信息,对于历史订单能够回放充电过程
-
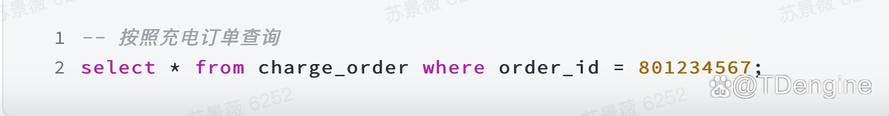
数据查询方式: 按照订单查询,期望能够实时监控正在充电的订单、以及能够查询历史订单充电过程
数据建模思考
正确的建模思路
让我们回顾 TDengine 数据建模原理: 让查询直接定位到数据块。
业务希望按照订单来查询,那么,我们直接按照订单来对数据进行 分片(Sharding),也就是说每个订单创建一张子表。这样,按照订单查询时,我们能够直接定位到该分片,这样的好处是查询的性能非常好,也非常方便,但也存在两个问题:
- 每年新建 1000 万张子表,订单数据保留 2 年,预计就有 2000 万张子表,规模会不会太大?
-
数据保留周期是 2 年,对于超过 2 年的子表,是否能够自动删除呢?
幸运的是,对于时序数据领域常见的“高基数”问题,TDengine 已经很好地解决了,2000 万张子表对于关系型数据库来说,可能是天文数字,但是,对于 TDengine 来说就是小菜一碟。
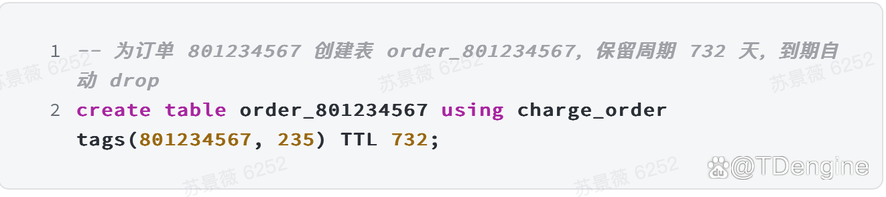
对于超过 2 年的子表,TDengine 提供了 TTL(Time to Live),是 用来指定表的生命周期(单位:天)。如果创建表时指定了这个参数,当该表的存在时间超过 TTL 指定的时间后,TDengine 将自动删除该表。
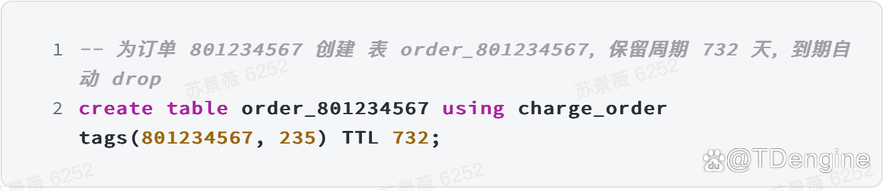
实际数据建模
- 创建超级表

- 为单个订单创建子表(假设订单号: 801234567),保留 2 年到期自动删除
- 按照充电订单查询
写在最后
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70014783/viewspace-3023018/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- TDengine IDMP 2.0.2 发布:元素关系可视化、数据建模与联邦查询三大升级
- 栖息地 AI 超恒气候系统用 TDengine 支撑全屋环境品质实时监测与历史追溯
- 腾讯WorkBuddy x 涛思数据:TDengine 连接器与4位专家使用指南
- TDengine 亮相 ICC 2026,在北美自动化大会展示 AI 原生工业数据平台
- 万家乐用 TDengine 构建 IoT 数据底座:让数十万台热水器实现"主动售后"
- 涛思数据亮相第十二届国际智能制造暨工业AI论坛
- TDengine入驻腾讯WorkBuddy:1个连接器+4位顾问,让工业数据流AI起来
- TDengine荣获第十一届"创客中国"工业智能体大赛企业组一等奖
- 从"极速算"到"知识沉淀":工业 AI 实战直播(十三、十四期)
- 存储成本降低80%,Zendure用TDengine支撑117万台设备的能源数据分析
