事件发生后,热心网友开始追根溯源,激烈讨论,其中有一股清流表示:
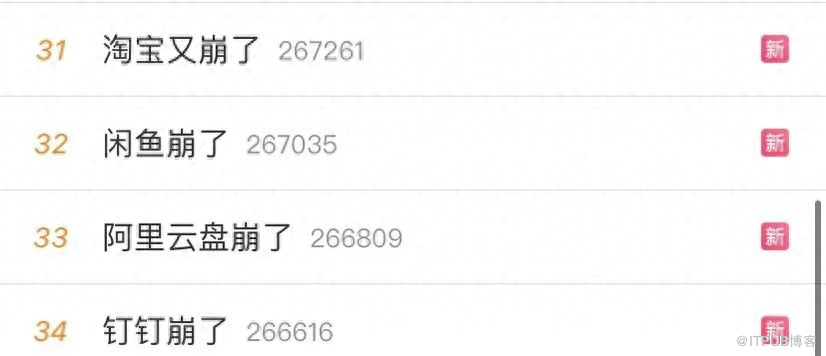
11月12日晚间阿里云发生故障。“阿里云盘崩了” “淘宝又崩了” “闲鱼崩了” “钉钉崩了” 等话题相继登上热搜,阿里系诸多产品受到影响。
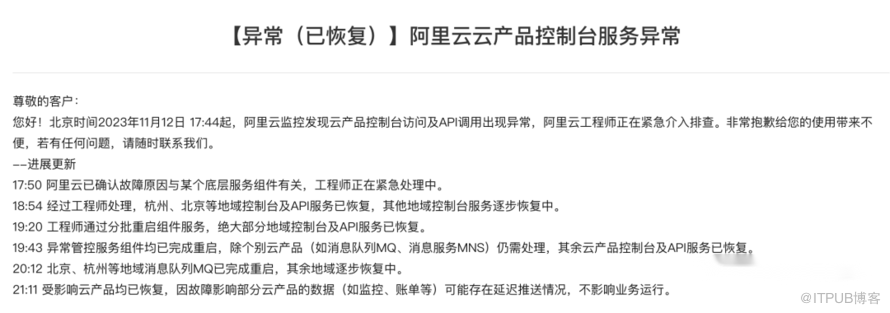
阿里云对此公告称,2023年11月12日17:44起,阿里云监控发现云产品控制台访问及API调用出现异常,阿里云工程师正在紧急介入排查。18:54阿里云再度公告,经过工程师处理,杭州、北京等地域控制台已恢复,其他地域控制台服务逐步恢复中。
这次故障使大部分阿里系产品受到影响,包括:淘宝、阿里云、钉钉、语雀、闲鱼、阿里云盘…… 从17:44分开始, 截至晚上21:11分才完全恢复。
据悉,此次受影响产品包括企业级分布式应用服务、消息队列MQ、微服务引擎、链路追踪、应用高可用服务、应用实时监控服务、Prometheus监控服务、消息服务、消息队列Kafka版、机器学习、图像搜索、智能推荐AlRec等。
受影响地域涵盖华北2 (北京)、华北6 (乌兰察布)、 华北1 (青岛)、华东2(上海)、华南2(河源)、华北3(张家口)、中国香港、印度(孟买)、美国(硅谷)、华南1(深圳)、英国(伦敦)、韩国(首尔)、日本(东京)、阿联酉(迪拜)、西南1 (成都)、华南3 (广州)、新加坡、澳大利亚 (悉尼)、马来西亚(吉隆坡)、 华北5 (呼和浩特)、 印度 尼西亚(雅加达)、美国 (弗吉尼亚)、菲律宾 (马尼拉)、泰国(曼谷)、华东1(杭州)、华南1金融云。
这一次故障,影响范围之大,可以说是史诗级的,已经不是“杀个程序员祭天” 所能平息的,至少也得是CEO吧...
尽管这次故障不能影响阿里云在云服务的领先地位,但它确实揭示大型云服务提供商也可能存在的潜在问题;用户需要更加重视运维管理,毕竟备份重于一切才是IT运维中真理。
上云后,风险被集中,故障影响更大。站在用户角度,如果单机部署,不管放在哪家云上,都存在一定的风险,相对于传统的分散计算,云计算把资源集中在一起,因而风险也被集中。云端成了单点故障,如果云端发生事故,则影响面非常巨大。用户对数据掌控灵活度降低,且系统运维的工作不会减少,传统运维手段不能满足云上业务需求,运维如何做到降本增效呢?
1、全面敏捷的监控系统
2、准确预测,实时掌握系统运行状态。
能预先发现漏洞,防患于未然;事后控制不如事中控制,事中控制不如事前控制;
3、服务闭环,成本大降
4、AI机器学习,精准预测及时响应
LinkSLA智能运维管家,开放生态广泛兼容,可延伸对接云服务,也可支持多厂商设备管理、异构资源池纳管。在全栈统一管理的基础上,结合业务高效发放以及 AI 技术赋予的智能故障定位、提前风险预知等能力,信息中心运维平台将快速从人工走向智能,实现高效率的运维管理。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70013542/viewspace-2995134/ ,如需转载,请注明出处,否则将追究法律责任。
下一篇:
mysql 主从延时问题

请登录后发表评论
登录
全部评论
