在 UXDB 的日常运维中,WAL 预写日志管理一直是个「如履薄冰」的活。一旦清理策略失误,要么因为过度清理导致流复制中断、数据库宕机,要么因为清理不及时引发磁盘写满,触发「日志风暴」(WAL 堆积),最终让整个集群陷入只读甚至宕机的窘境。DBA 在面对 WAL 清理时往往陷入两个极端:要么依赖简单的
archive_command 配合
cp 命令,寄希望于归档永远成功;要么采用激进的手工删除,仅凭经验来操作。这两种方式在面对归档目标盘满、权限抖动、复制槽停滞、备份窗口过长等复杂生产环境时,显著存在「灰色地带」。
本文基于生产环境中的典型故障复盘,尝试构建一套具备故障容错、空间自愈和可观测性的 WAL 自动化清理方案。我们将从现有方案的潜在风险入手,逐步演进到一套自动化治理架构。
一、 为何简单配置并不安全
在生产环境中,许多看似标准的配置实际上埋藏着隐患。如果不能理解这些参数背后的依赖关系,所谓的「自动清理」反而会成为破坏数据一致性的导火索。
1.
archive_command
的脆弱性:避免「假性归档」
当使用简单的
cp 命令作为归档指令时,实际上是将系统的稳定性绑定在了 NFS 或本地磁盘的瞬时状态上。若归档目标磁盘写满、NFS 抖动或权限 SELinux 策略突然生效,
cp 命令会返回非零状态码,UXDB 会判定归档失败,从而在
ux_wal 目录中无限期保留这些日志,直到磁盘彻底写满。
改进思路: 引入具有重试机制和状态标记的命令。
archive_command = 'test -f /wal_archive/%f || cp %p /wal_archive/%f && touch /wal_archive/%f.done'
依据: 先通过
test -f 检测文件是否已存在,避免重复归档造成的 IO 浪费。
.done 标记文件的引入,为后续的巡检脚本提供了「归档完成」的明确凭证,将「归档失败」与「文件缺失」这两种状态区分开来。
2.
archive_cleanup_command
的误判风险:
对
restart_lsn 的盲目依赖
archive_cleanup_command 中的
%r 参数代表的是「最旧的需要保留的 WAL」。如果系统中存在一个长期未推进的复制槽(Replication Slot),或者物理备份进度严重滞后,
%r 会指向一个很早的 LSN 位置。此时执行
ux_archivecleanup,不仅不会释放空间,甚至可能因为清理逻辑的误判,导致在极端情况下删除了备库或备份尚未应用的 WAL。 必须配合的前置检查: 在执行任何清理动作前,需确认复制槽的健康度:
-- 查看是否存在停滞的复制槽(尤其关注 active 为 f 且 restart_lsn 长期不变的)SELECT slot_name, slot_type, active, restart_lsn FROM ux_replication_slots;-- 对比当前LSN与最旧LSN的差值,判断是否存在较大延迟SELECT ux_current_wal_lsn(), ux_last_wal_receive_lsn();
3. 空间「爆仓」时的应急机制缺失
当 WAL 写入速度瞬间超过归档速度(例如大事务、批量导入)时,配置文件中缺乏自动降级或应急清理的机制。运维人员往往只能在磁盘使用率达到 100% 时,被迫通过
ux_archivecleanup 手动「盲删」,风险极高。
二、 构建具备容错与自愈能力的治理方案
为了解决上述问题,我们不能仅仅依赖数据库内核参数,需要引入「操作系统守护脚本 + 可靠传输工具 + 备份联动」的组合拳。
1. 基础配置:提升归档的「鲁棒性」
将脆弱的
cp 替换为支持断点续传和错误重试的
rsync,并增加必要的安全缓冲。
# uxdbql.confarchive_mode = onarchive_command = 'rsync -a %p /wal_archive/%f && sync' archive_cleanup_command = 'ux_archivecleanup -d /wal_archive %r 2>>/var/log/ux_cleanup.log'wal_keep_size = 1GB # 设定1GB的缓冲垫,防止因归档瞬时抖动导致的WAL被意外回收
依据:
rsync 在网络存储场景下比
cp 拥有更好的错误处理机制;
wal_keep_size 充当了「保险丝」,在主库归档命令完全失效时,提供一定的缓冲时间,避免因归档失败导致主库立即将 WAL 删除。
2. 引入守护脚本:解决磁盘空间「爆仓」
完全依赖
archive_cleanup_command 是被动的。我们需要一个主动的守护进程,在磁盘使用率达到阈值时,介入清理最旧的归档文件,避免数据库因磁盘写满而宕机。
#!/bin/bash# /usr/local/bin/ux_wal_cleaner.sh# 逻辑:当归档目录使用率超过90%时,触发紧急清理,但保留最近3天的文件以保底WAL_DIR="/wal_archive"THRESHOLD=90USAGE=$(df -h $WAL_DIR | awk 'NR==2 {print $5}' | tr -d '%')
if [ $USAGE -ge $THRESHOLD ]; then
    # 获取按时间排序最旧的文件(假设文件命名规范)
    OLDEST_WAL=$(ls -t $WAL_DIR/0000* | tail -n 1)
    ux_archivecleanup -d $WAL_DIR $(basename $OLDEST_WAL)
    logger "Emergency WAL cleanup triggered for $OLDEST_WAL due to disk usage ${USAGE}%"
fi
依据: 这是一种「保底」逻辑。当业务的归档策略(如保留 3 天)与磁盘物理容量发生冲突时,优先保证数据库的写入可用性,牺牲部分历史归档,从而避免因磁盘写满导致的数据库级故障。
3. 集成备份验证:让清理逻辑与备份生命周期绑定 最安全的 WAL 清理时机是在一次 完整且经过验证的备份完成之后。将清理逻辑写入备份脚本,确保「只有确认数据已落地,才清理日志」。
ux_basebackup -D /backups/ux -Ft -Xs -P
if [ $? -eq 0 ]; then
    # 从备份标签中提取起始WAL位置,清理此位置之前的所有WAL
    START_WAL=$(cat /backups/ux/backup_label | grep "START WAL" | awk '{print $3}')
    ux_archivecleanup /wal_archive $START_WAL
    echo "Backup succeeded, cleaned WAL before $START_WAL"
fi
依据: 备份脚本的成功返回码是 WAL 清理的唯一可靠依据。通过解析
backup_label 获取起始位点,确保了清理操作不会影响本次备份的一致性。
三、从「可用」到「可靠」
要让这套机制在无人值守的生产环境中稳定运行,还需要增加三道防线:
-
双重锁定机制:
使用flock防止并发清理。当archive_cleanup_command与守护脚本同时触发时,通过文件锁确保只有一个清理进程在运行,避免因并发操作导致的元数据混乱。archive_cleanup_command = 'flock -n /tmp/wal_cleanup.lock ux_archivecleanup /wal_archive %r'
-
实时监控告警:
依赖uxdb_exporter暴露 WAL 积压情况。重点关注两个指标:ux_wal_files(当前目录下 WAL 文件数,超过阈值告警)和ux_oldest_wal(最旧的 WAL 文件生成时间,用于判断归档是否卡死)。# uxdb_exporter 配置 - name: ux_wal_stats metrics: - ux_wal_files: 'SELECT COUNT(*) FROM ux_ls_waldir()' - ux_oldest_wal: 'SELECT SUBSTRING(name FROM 1 FOR 24)::text FROM ux_ls_waldir() ORDER BY name ASC LIMIT 1'
-
日志审计追踪:
所有的清理动作必须有据可查。将所有清理命令的输出重定向到独立日志文件,方便在发生数据恢复失败时回溯原因。archive_cleanup_command = 'ux_archivecleanup /wal_archive %r >> /var/log/ux_archivecleanup.log 2>&1'
四、WAL 清理自动化流程图
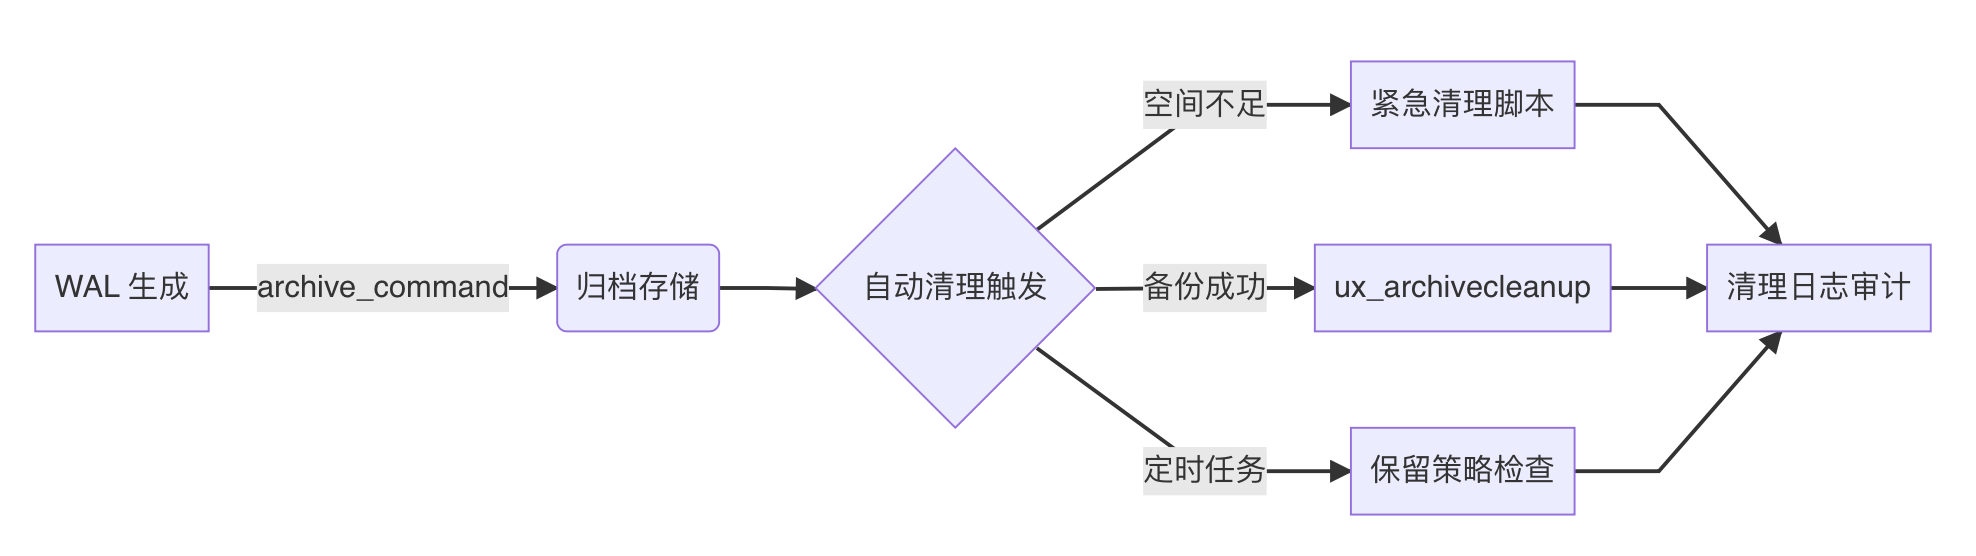
通过以上组合策略,即可实现安全、自动化的 UXDB WAL 日志管理。
总结
本方案旨在将 WAL 清理从一个「高风险手工操作」转化为「自动化常态运维」,其价值在于:
-
消除「人肉运维」的误判风险:通过将清理逻辑与备份成功状态、磁盘剩余空间、复制槽健康度绑定,避免了人工操作时因忽略上下文(如未检查复制槽)而引发的数据丢失事故。
-
构建系统级的「反脆弱性」:方案中设计的守护脚本和
wal_keep_size缓冲,本质上是一种「降级机制」。当归档系统出现性能瓶颈或配置偏差时,系统能够优先保障核心业务的写入连续性,而非生硬地崩溃。 -
实现 WAL 生命周期的可观测性:借助监控指标和审计日志,WAL 的积压不再是一个「黑盒」。运维人员可以清晰地知道 WAL 是因为「备份延迟」在等待,还是因为「归档目标端」在卡顿,从而快速定位问题根因。
只要确保备份验证通过率 100%(验证 ux_verifybackup)、复制槽无长期停滞(监控 ux_replication_slots)、归档存储保留 20% 冗余空间这三个前提,即可在生产环境中实现接近「零副作用」的 WAL 自动治理。在数据库内核的刚性逻辑与物理存储的有限资源之间,搭建一个兼顾安全与效率的动态平衡机制。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70009096/viewspace-3115686/ ,如需转载,请注明出处,否则将追究法律责任。

