在公共安全领域,需要在海量的人脸数据中找到与要识别目标一致或相近的人,降低人工识别的错误、提升海量人脸数据处理效率。通过基于UXDB的向量数据库与图像特征识别技术,在将一个目标图像特征向量化后,与通过图像特征识别技术已建立的人脸数据库中的数据进行余弦相似比较,找到特征相同或相近的人脸,从而确定目标。
一、环境准备
VirtualBox虚拟机,安装CentOS 7.9,使用桥接网络模式,SSH终端登录。
二、安装UXDB和uxvector
UXDB是一款与企业级数据库,支持丰富的扩展,包括向量检索插件uxvector。 参考 官方安装文档 .(略)
三 、验证
启动数据库
ux_ctl start
uxsql
创建扩展、表与数据
CREATE EXTENSION uxvector;CREATE TABLE items (id bigserial PRIMARY KEY, embedding vector(3));INSERT INTO items (embedding) VALUES ('[1,2,3]'), ('[4,5,6]');
查询
SELECT * FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 5;
 id | embedding----+-----------
  1 | [1,2,3]
  2 | [4,5,6]
(2 rows)
扩展安装成功,建向量库表、插入查询成功。
四、人脸识别
1、建立人脸向量库
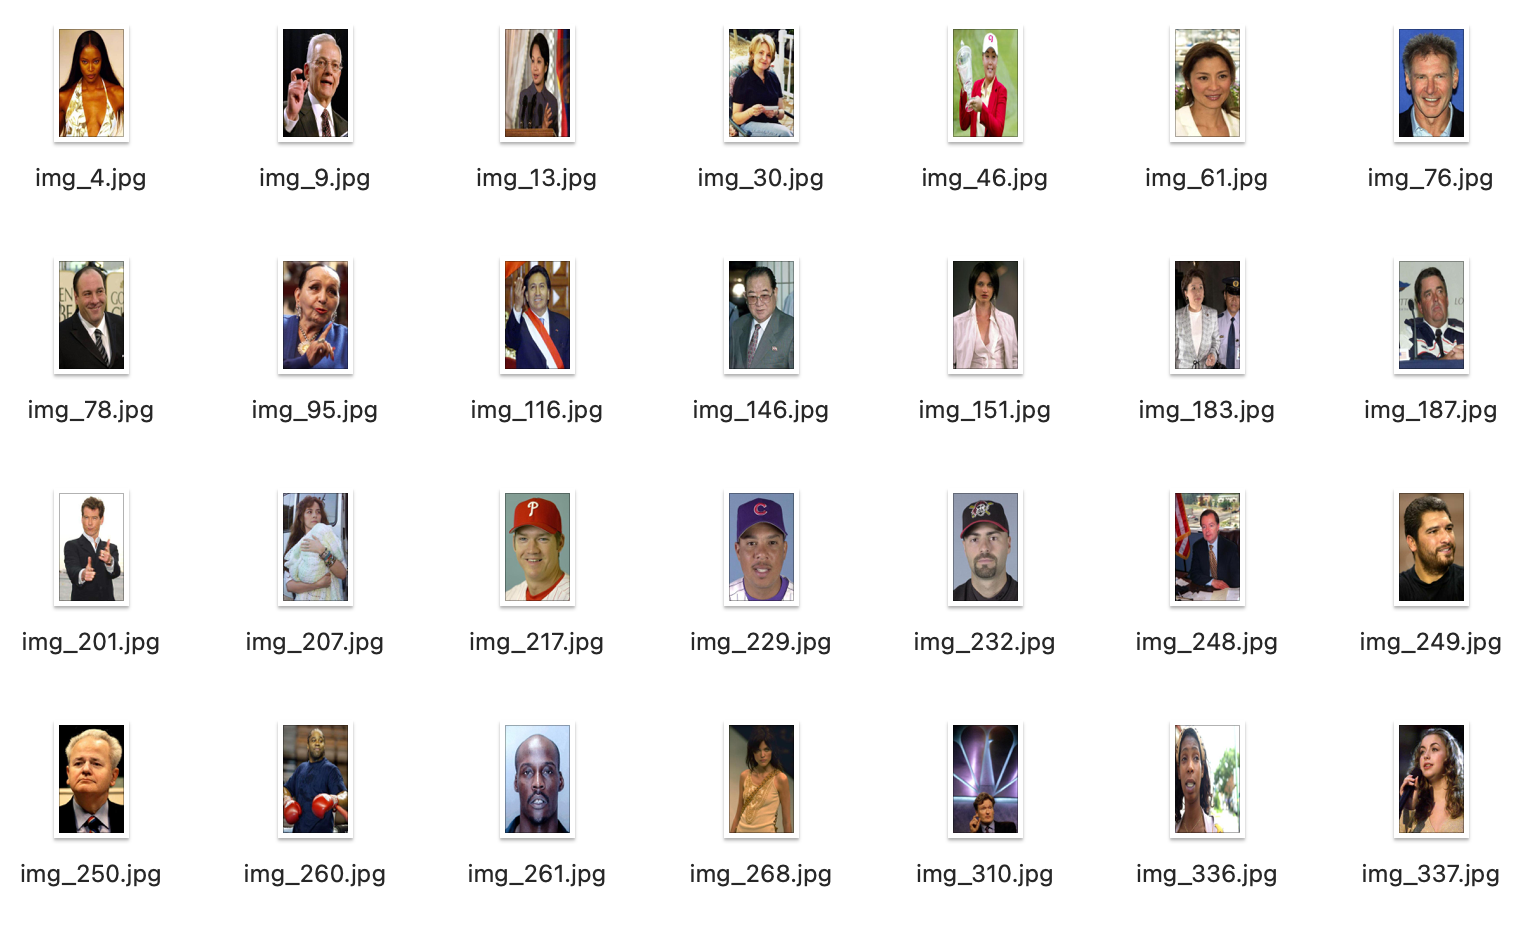
本例数据取自 https://vis-www.cs.umass.edu/fddb/originalPics.tar.gz,选取了100张。
2、批量提取图片特征值
开发环境为:PyCharm2023,安装tensorflow、pandas等框架。
建立Python文件
extract_features.py:
import osimport cv2import tensorflow as tffrom tensorflow.keras.applications import ResNet50from tensorflow.keras.applications.resnet50 import preprocess_inputimport numpy as npimport pandas as pd# 加载预训练的 ResNet50 模型model = ResNet50(weights='imagenet', include_top=False, pooling='avg')# 定义图像文件夹路径image_folder_path = '/Desktop/images'# 定义一个空列表来存储图像名称和特征向量image_data = []# 迭代遍历文件夹中的全部图像,注意不要有图片之外的其它目录或文件。for img_name in os.listdir(image_folder_path):
    img_path = os.path.join(image_folder_path, img_name)
    # 读取图像
    img = cv2.imread(img_path)
    # 检查图像是否成功加载
    if img is None:
        print(f"Error loading image: {img_path}")
        continue
    # 预处理图像以适应 ResNet50 模型
    img_array = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
    img_array = np.expand_dims(img_array, axis=0)
    img_array = preprocess_input(img_array)
    # 使用模型进行特征提取
    features = model.predict(img_array)
    # 将图像名称和特征向量附加到列表
    image_data.append({'ImageName': img_name, 'Features': features.flatten()})# 将列表转换为 Pandas DataFramedf = pd.DataFrame(image_data)# 将 DataFrame 保存为 CSV 文件以供参考df.to_csv('/Desktop/i/features.csv', index=False)
运行结果生成features.csv,内容例如:
ImageName Features
img_467.jpg [0.03609351 0.13187751 0.02881813 ... 0.02179628 0.01932809 0.09736819]img_249.jpg [0.04243292 0.30902326 0.         ... 0.11771917 0.00365803 0.00877083]...
3、特征数据整理入库
创建包含向量的表
CREATE TABLE image_features (
    image_id varchar PRIMARY KEY,
    feature_vector vector(6)  -- 6 维度的图像特征向量);
将特征数据格式化为SQL插入语句,例如:
INSERT INTO image_features (image_id, feature_vector) VALUES('img_467.jpg', '[0.03609351,0.13187751,0.02881813,0.02179628,0.01932809,0.09736819]'::vector),
('img_249.jpg', '[0.04243292,0.30902326,0,0.11771917,0.00365803,0.00877083]'::vector),
('img_261.jpg', '[0.11817403,0.9701328,0,0.14486586,0,0.06031943]'::vector),
...
;
4、查询相似图像
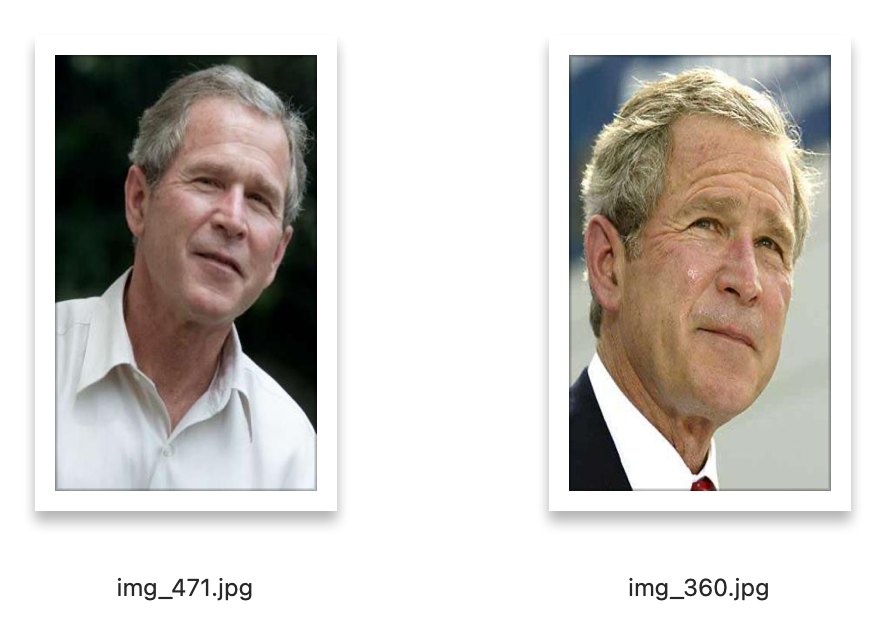
选取img_471.jpg的特征值作为目标,与库中其它图像特征进行余弦相似度比较。
SELECT image_id, feature_vector,
       feature_vector <=> '[0.04793356,0.3626258,0.00204526,0.09089294,0.09992124,0.22357485]' AS similarityFROM image_featuresORDER BY similarity DESCLIMIT 1;
  image_id   |                           feature_vector                           |     similarity
-------------+--------------------------------------------------------------------+--------------------
 img_360.jpg | [0.0058903,0.17758086,0.00366735,0.7125899,0.12386708,0.03569715]  | 0.5529994761318635
说明:
<=> 运算符计算两个向量之间的余弦相似度,范围在 -1 到 1 之间,1 表示完全相同,0 表示无关,-1 表示方向相反。
5、结果显示
查询结果表明img_360.jpg与目标图像img_471.jpg最为接近。
五、结论
操作过程中,可能遇到以下问题,应对建议如下:
-
安装uxvector时可能遇到ux_config路径问题,按照上述方法处理即可。
-
对于其他UXDB版本,避免使用2.1.1以下的版本,以免出现依赖错误。
-
在Python开发中,尤其是涉及tensorflow等组件时,建议使用pip3进行安装。
-
人物图片的选择最好保持格式和尺寸一致,这样可能获得更好的效果。
除应用于图像搜索识别的相似性搜索、对象检测,向量数据库还可应用于音视频内容搜索和相似性检索、自然语言处理中的语义搜索、文本分析、个性化推荐、异常检测和欺诈预防实时分析、基因组研究中的相似基因序列识别等。
作者:Steven.T
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70009096/viewspace-3111937/ ,如需转载,请注明出处,否则将追究法律责任。

