以往有篇文章介绍 [EFK(Kibana + ElasticSearch + Filebeat)](https://mp.weixin.qq.com/s/XCTja56IibLDlASQkdonMA)的插件日志收集。Filebeat 插件用于转发和集中日志数据,并将它们转发到 Elasticsearch 或 Logstash 以进行索引,但 Filebeat 作为 Elastic 的一员,只能在 Elastic 整个体系中使用。
## Fluentd
Fluentd是一个开源的,分布式日志采集系统,可以从不同的服务,数据源采集日志,对日志进行过滤加工,分发给多种存储和处理系统。支持各种插件,数据缓存机制,且本身所需的资源很少,内置可靠性,结合其他服务,可以形成高效直观的日志收集平台。
本文介绍在 Rainbond 中使用 Fluentd 插件,收集业务日志,输出到多个不同的服务。
## 一、整合架构
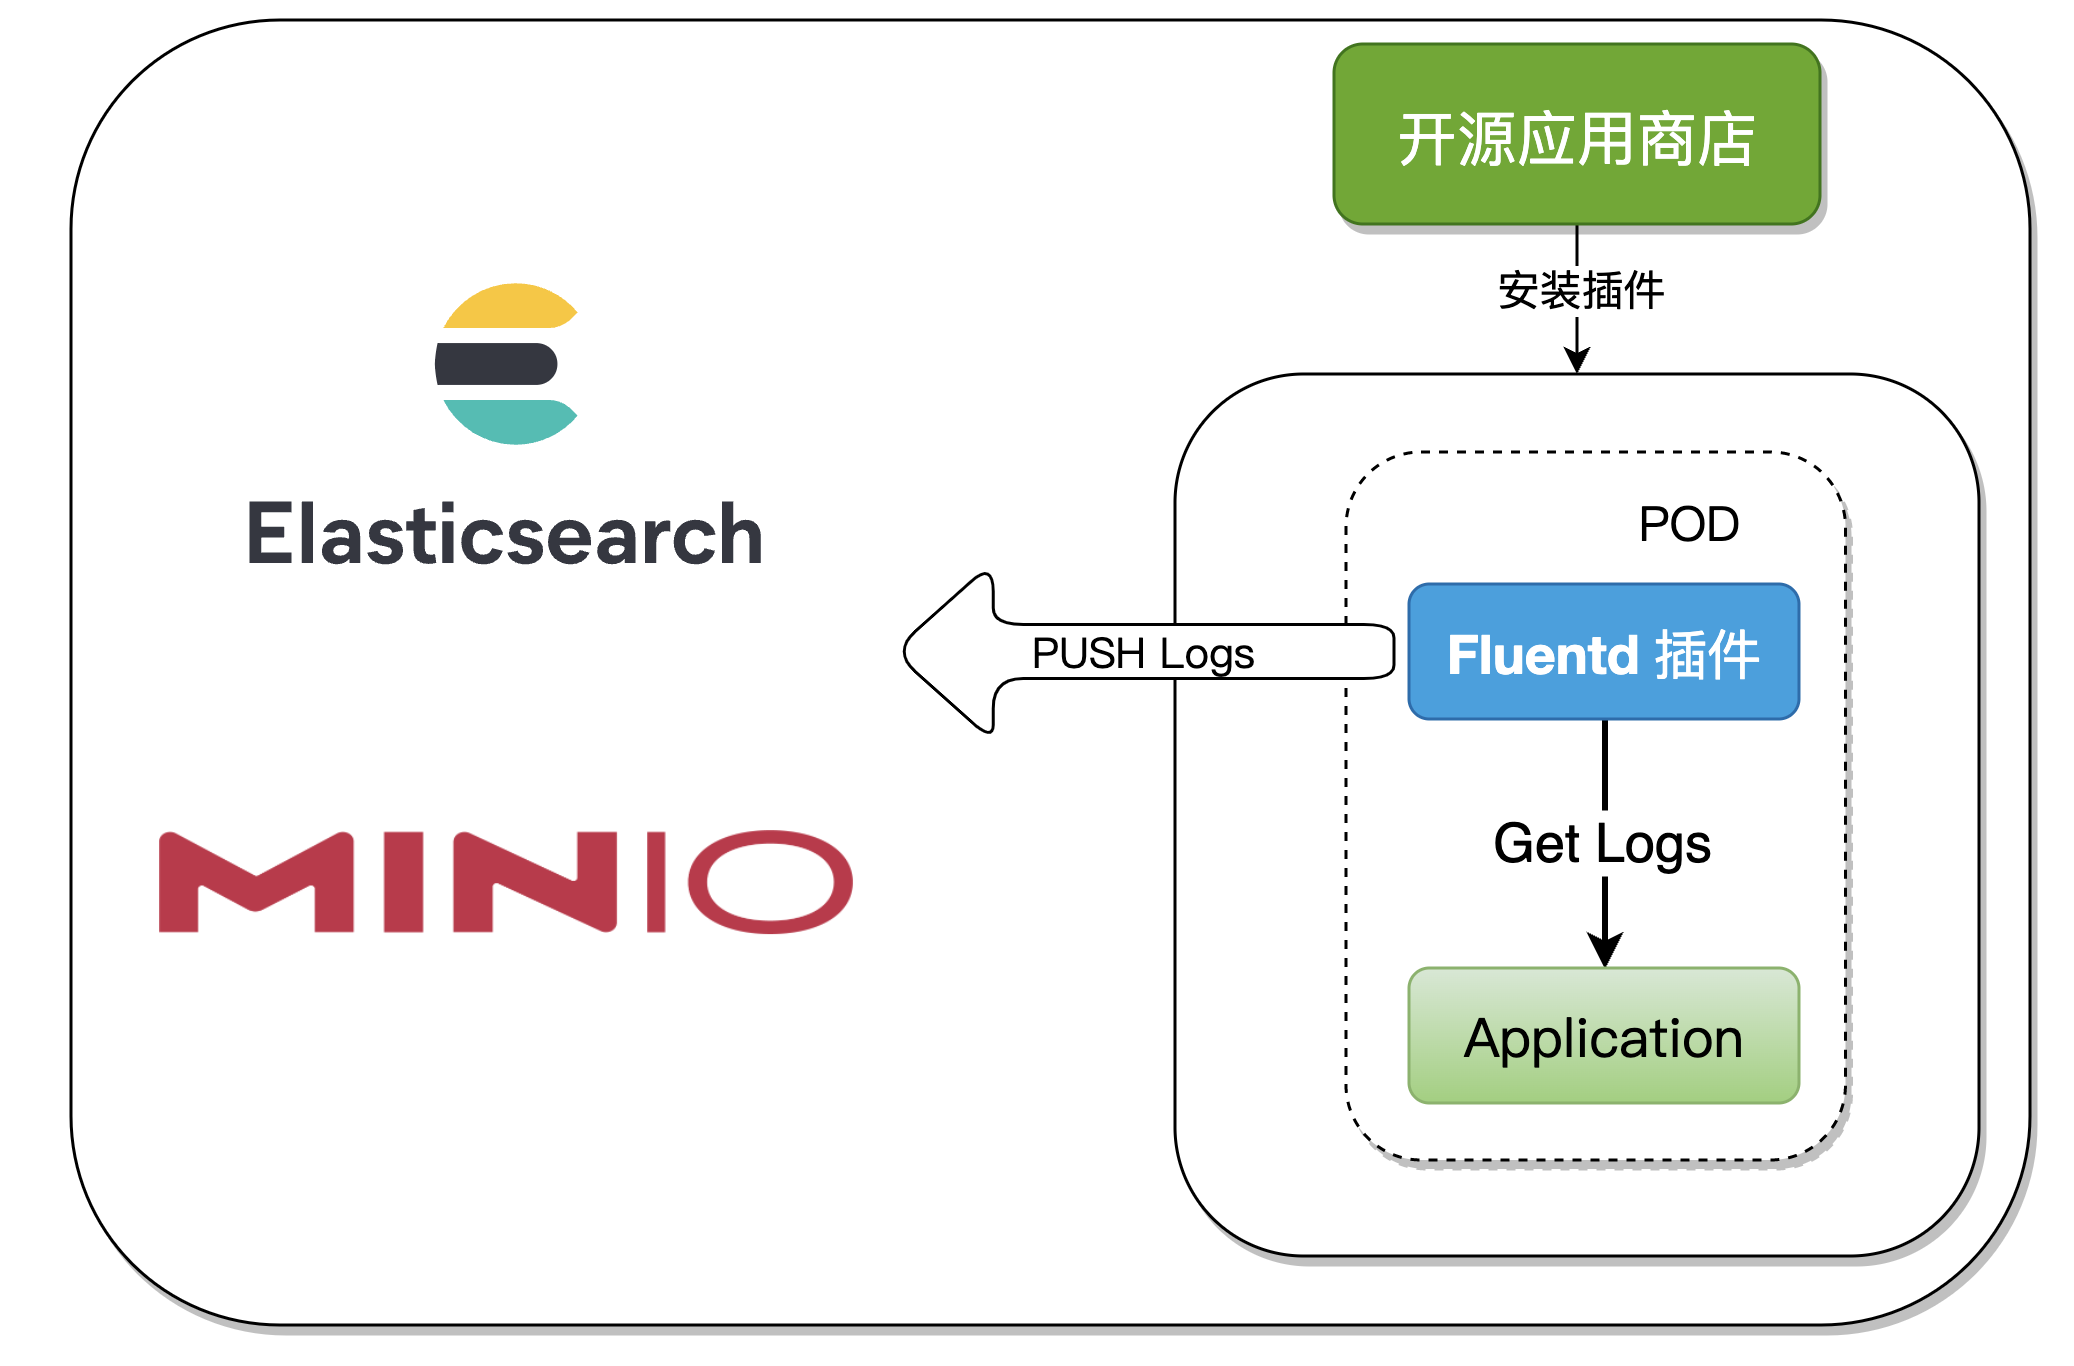
在收集组件日志时,只需在组件中开通 Fluentd 插件,本文将演示以下两种方式:
1. Kibana + ElasticSearch + Fluentd
2. Minio + Fluentd
我们将 Fluentd 制作成 Rainbond 的 `一般类型插件` ,在应用启动之后,插件也随之启动并自动收集日志输出到多个服务源,整个过程对应用容器无侵入,且拓展性强。
## 二、插件原理分析
Rainbond V5.7.0 版本中新增了:**从开源应用商店安装插件**,本文中的插件已发布到开源应用商店,当我们使用时一键安装即可,根据需求修改配置文件。
Rainbond 插件体系是相对于 Rainbond 应用模型的一部分,插件主要用来实现应用容器扩展运维能力。由于运维工具的实现有较大的共性,因此插件本身可以被复用。插件必须绑定到应用容器时才具有运行时状态,用以实现一种运维能力,比如性能分析插件、网络治理插件、初始化类型插件。
在制作 Fluentd 插件的过程中,使用到了 **一般类型插件**,可以理解为一个POD启动两个 Container,Kubernetes原生支持一个POD中启动多个 Container,但配置起来相对复杂,在 Rainbond 中通过插件实现使用户操作更加简单。
## 三、EFK 日志收集实践
Fluentd-ElasticSearch7 输出插件将日志记录写入 Elasticsearch。默认情况下,它使用批量 API创建记录,该 API 在单个 API 调用中执行多个索引操作。这减少了开销并可以大大提高索引速度。
### 3.1 操作步骤
应用 (Kibana + ElasticSearch)和插件(Fluentd)都可以通过开源应用商店一键部署。
1. 对接开源应用商店
2. 在应用商店中搜索 `elasticsearch` 并安装 `7.15.2` 版本。
3. 团队视图 -> 插件 -> 从应用商店安装 `Fluentd-ElasticSearch7` 插件
4. 基于镜像创建组件,镜像使用 `nginx:latest`,并且挂载存储`var/log/nginx`。这里使用 `Nginx:latest` 作为演示
* 在组件内挂载存储后,插件也会自定挂载该存储,并可访问 Nginx 产生的日志文件。
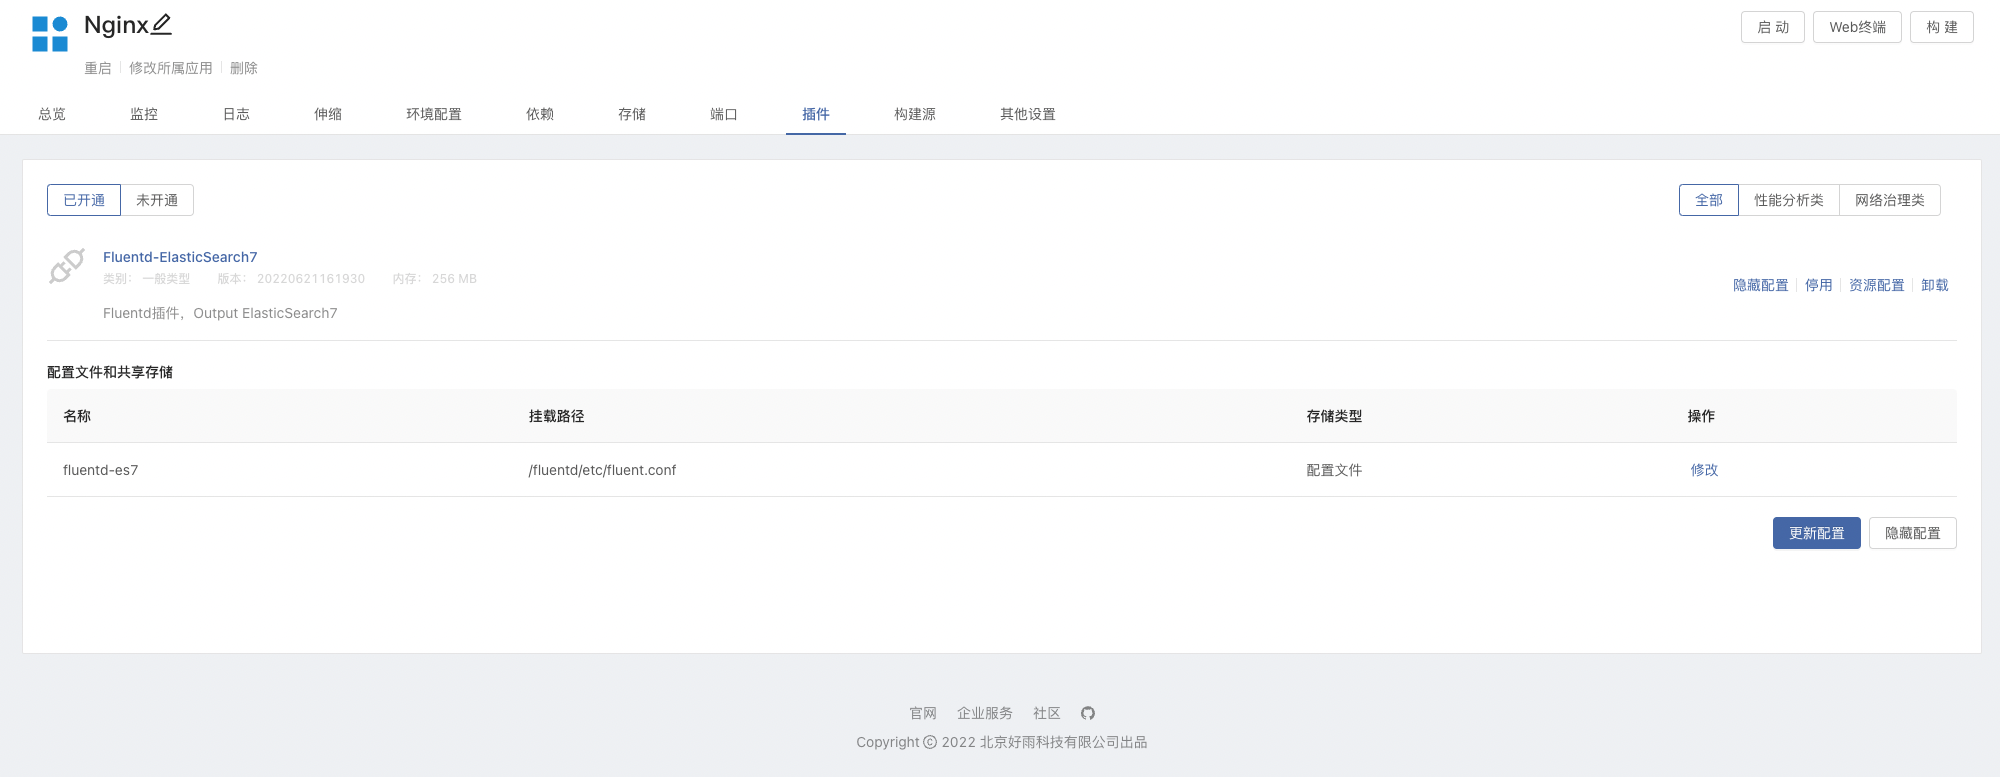
5. 在 Nginx 组件内开通插件,可以根据所需进行修改 `Fluentd` 配置文件,可参考下方配置文件简介部分。
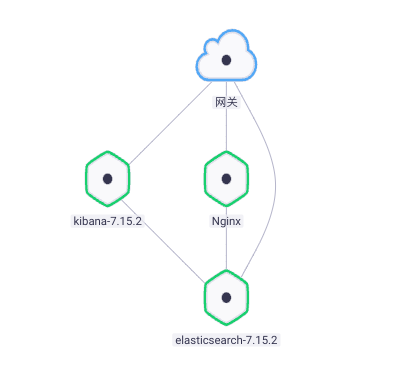
6. 添加 ElasticSearch 依赖,将 Nginx 连接到 ElasticSearch,如下图:
7. 访问 `Kibana` 面板,进入到 Stack Management -> 数据 -> 索引管理,可以看到已存在的索引名称为 `fluentd.es.nginx.log`,
8. 访问 `Kibana` 面板,进入到 Stack Management -> Kibana -> 索引模式,创建索引模式。
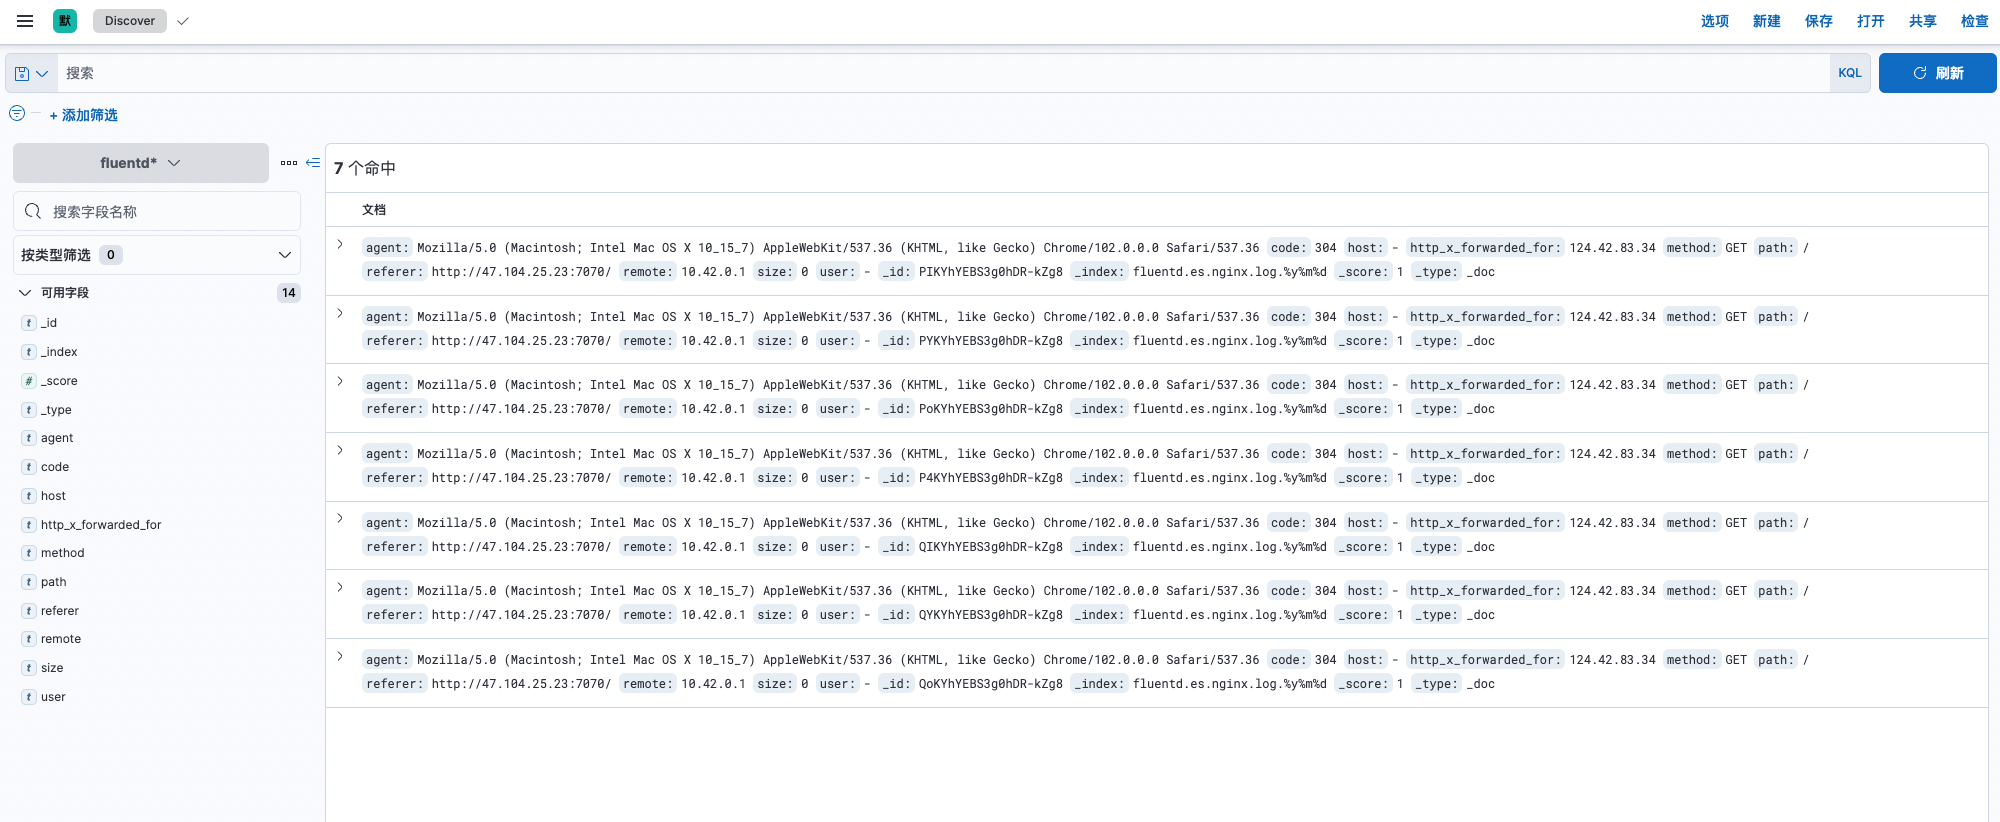
9. 进入到 Discover,日志正常展示。
### 3.2 配置文件介绍
配置文件参考 Fluentd 文档 [output_elasticsearch](https://docs.fluentd.org/output/elasticsearch "output_elasticsearch")。
```shell
<source>
@type tail
path /var/log/nginx/access.log,/var/log/nginx/error.log
pos_file /var/log/nginx/nginx.access.log.pos
<parse>
@type nginx
</parse>
tag es.nginx.log
</source>
<match es.nginx.**>
@type elasticsearch
log_level info
hosts 127.0.0.1
port 9200
user elastic
password elastic
index_name fluentd.${tag}
<buffer>
chunk_limit_size 2M
queue_limit_length 32
flush_interval 5s
retry_max_times 30
</buffer>
</match>
```
配置项解释:
\<source>\</source> 日志的输入源:
| 配置项 | 解释说明 |
| ----------------- | -------------------------------------------------------- |
| @type | 采集日志类型,tail表示增量读取日志内容 |
| path | 日志路径,多个路径可以使用逗号分隔 |
| pos_file | 用于标记已经读取到位置的文件(position file)所在的路径 |
| \<parse>\</parse> | 日志格式解析,根据你自己的日志格式,编写对应的解析规则。 |
\<match>\</match>日志的输出端:
| 配置项 | 解释说明 |
| ------------------- | ------------------------------------------------------------ |
| @type | 输出到的服务类型 |
| log_level | 设置输出日志的级别为info;支持的日志级别有:`fatal`, `error`, `warn`, `info`, `debug`, `trace`. |
| hosts | elasticsearch的地址 |
| port | elasticsearch的端口 |
| user/password | elasticsearch用到的用户名/密码 |
| index_name | index定义的名称 |
| \<buffer>\</buffer> | 日志的缓冲区,用于缓存日志事件,提高系统性能。默认使用内存,也可以使用file文件 |
| chunk_limit_size | 每个块的最大大小:事件将被写入块,直到块的大小变成这个大小,内存默认为8M,文件256M |
| queue_limit_length | 此缓冲插件实例的队列长度限制 |
| flush_interval | 缓冲区日志刷新事件,默认60s刷新输出一次 |
| retry_max_times | 重试失败块输出的最大次数 |
以上只是部分配置参数,其他配置可以跟官网文档自定义。
## 四、Fluentd + Minio 日志收集实践
Fluentd S3 输出插件将日志记录写入到标准的 S3 对象存储服务,例如 Amazon、Minio。
### 4.1 操作步骤
应用(Minio)和插件(Fluentd S3)都可以通过开源应用商店进行一键部署。
1. 对接开源应用商店。在开源应用商店中搜索 `minio`,并安装 `22.06.17` 版本。
2. 团队视图 -> 插件 -> 从应用商店安装 `Fluentd-S3` 插件。
3. 访问 Minio 9090 端口,用户密码在 Minio 组件 -> 依赖中获取。
* 创建 Bucket,自定义名称。
* 进入 Configurations -> Region,设置 Service Location
* Fluentd 插件的配置文件中 `s3_region` 默认为 `en-west-test2`。
4. 基于镜像创建组件,镜像使用 `nginx:latest`,并且挂载存储`var/log/nginx`。这里使用 `Nginx:latest` 作为演示
* 在组件内挂载存储后,插件也会自定挂载该存储,并可访问 Nginx 产生的日志文件。
5. 进入到 Nginx 组件内,开通 Fluentd S3 插件,修改配置文件中的 `s3_bucket` `s3_region`
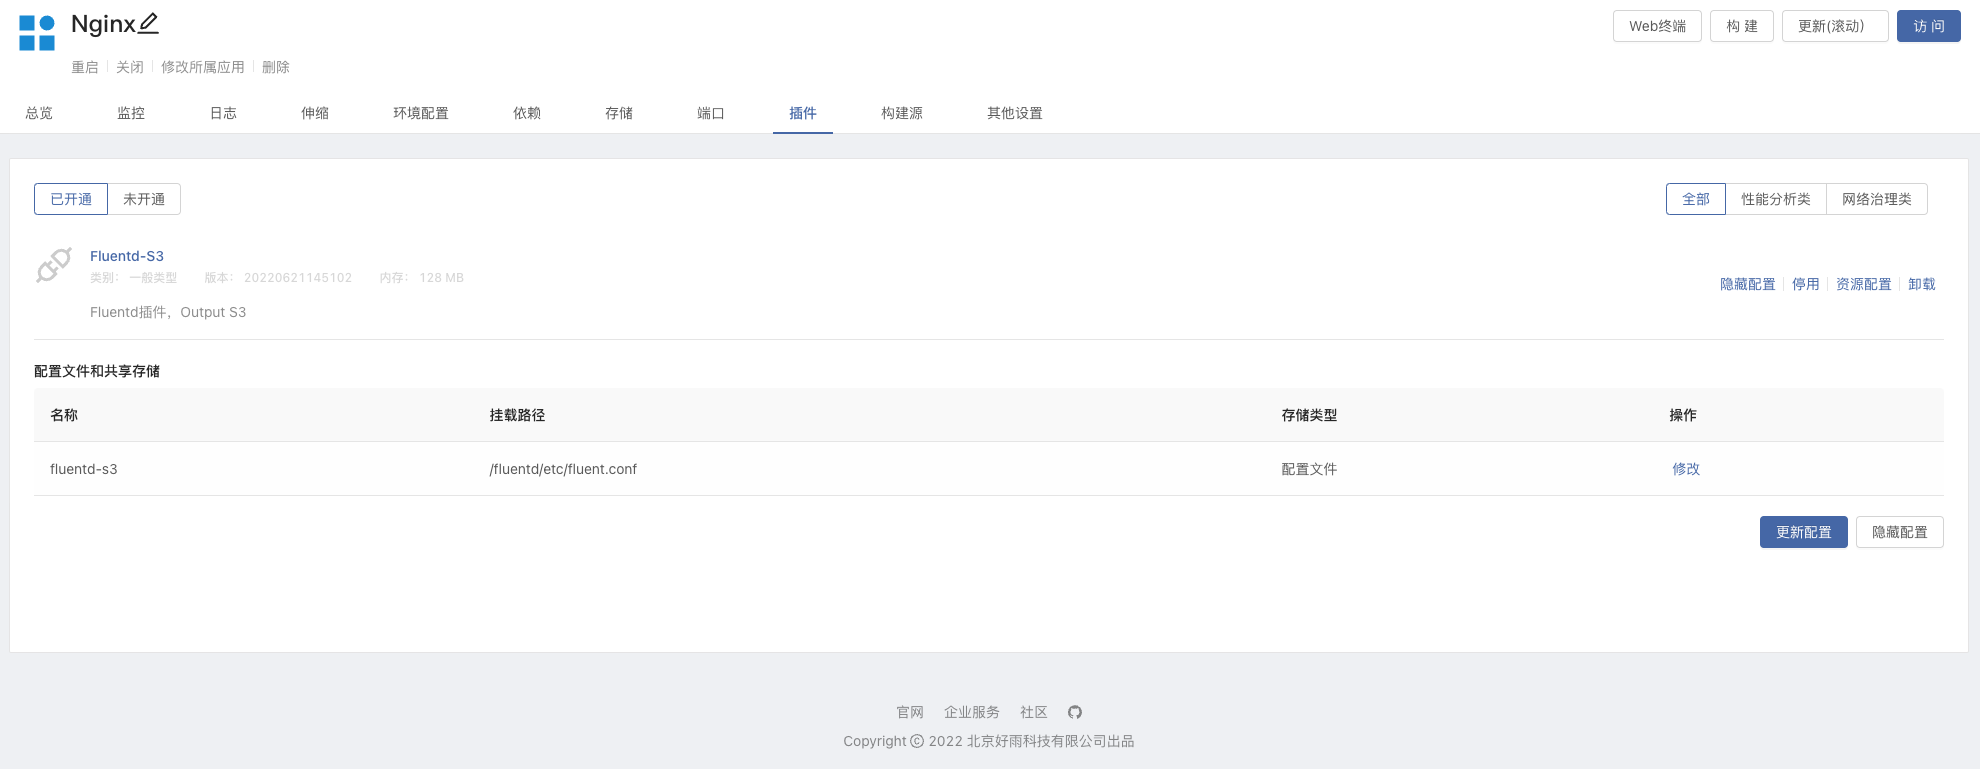
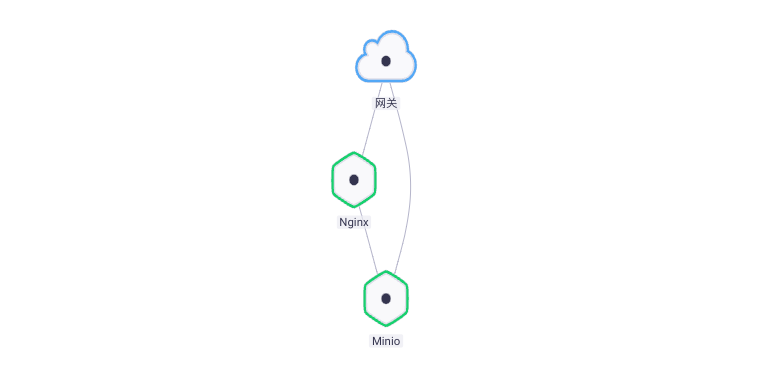
6. 建立依赖关系,Nginx 组件依赖 Minio,更新组件使其生效。
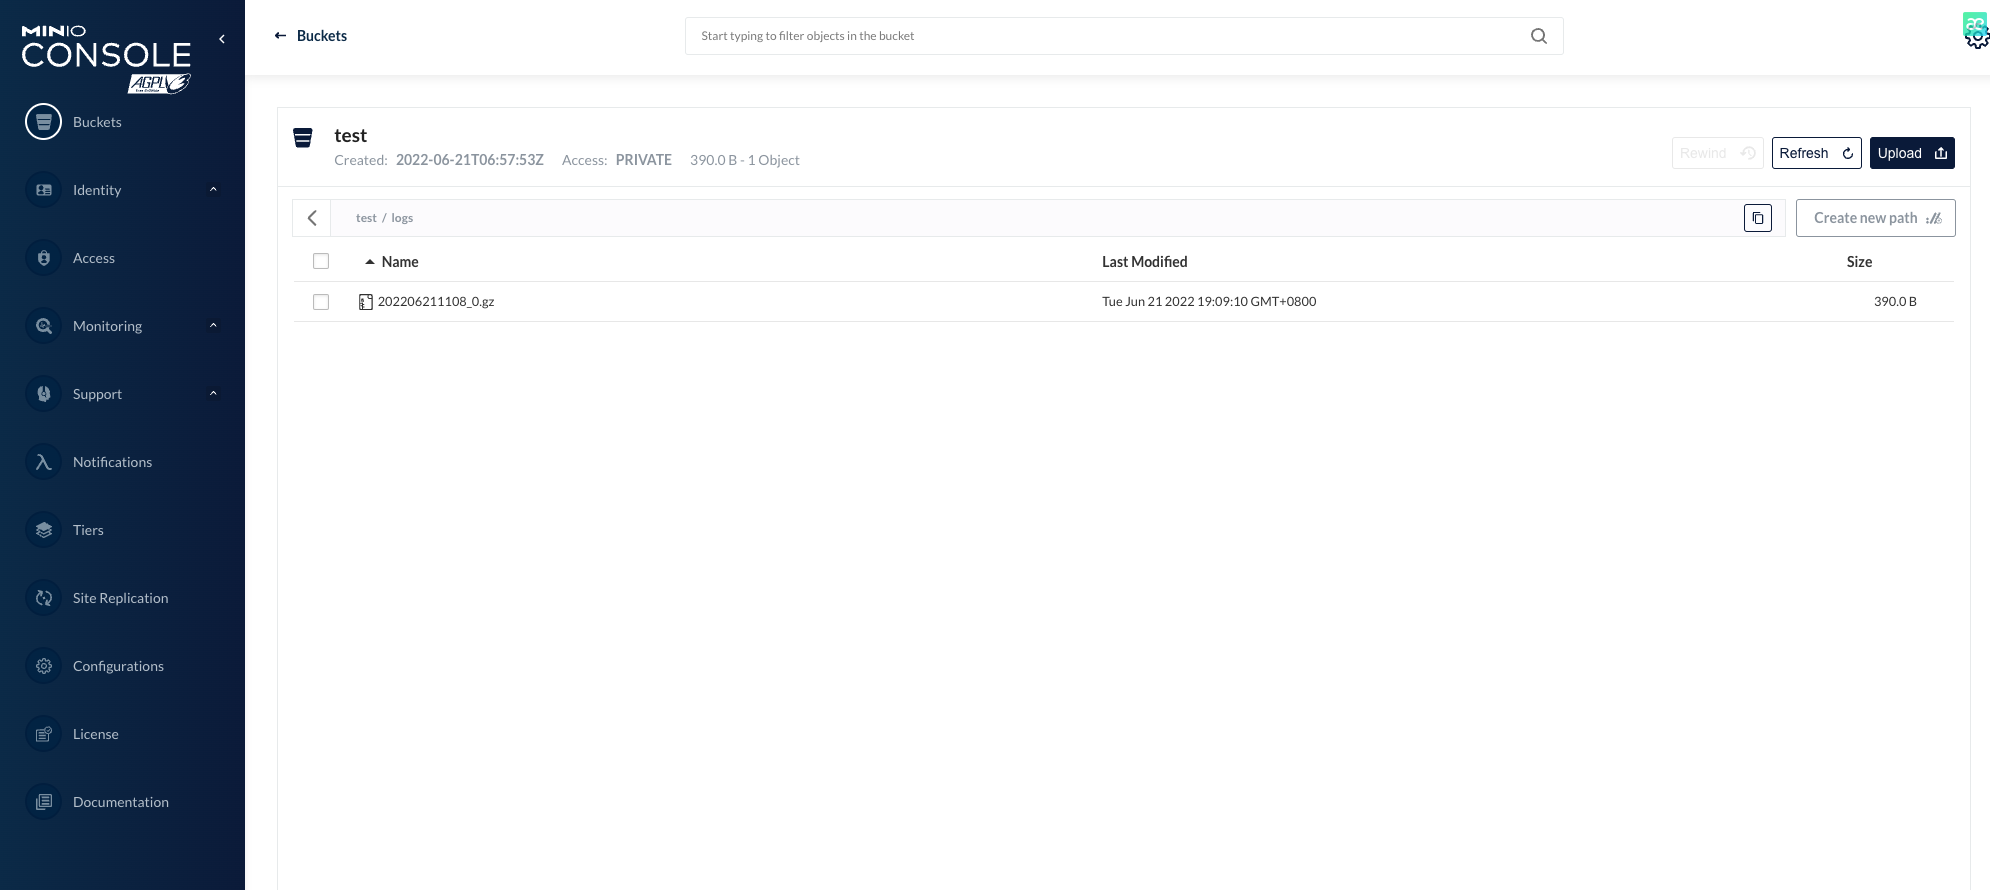
7. 访问 Nginx 服务,让其产生日志,片刻后就可以在 Minio 的 Bucket 中看到。
### 4.2 配置文件介绍
配置文件参考 Fluentd 文档 [Apache to Minio](https://docs.fluentd.org/how-to-guides/apache-to-minio "Apache to Minio")。
```shell
<source>
@type tail
path /var/log/nginx/access.log
pos_file /var/log/nginx/nginx.access.log.pos
tag minio.nginx.access
<parse>
@type nginx
</parse>
</source>
<match minio.nginx.**>
@type s3
aws_key_id "#{ENV['MINIO_ROOT_USER']}"
aws_sec_key "#{ENV['MINIO_ROOT_PASSWORD']}"
s3_endpoint http://127.0.0.1:9000/
s3_bucket test
s3_region en-west-test2
time_slice_format %Y%m%d%H%M
force_path_style true
path logs/
<buffer time>
@type file
path /var/log/nginx/s3
timekey 1m
timekey_wait 10s
chunk_limit_size 256m
</buffer>
</match>
```
配置项解释:
\<source>\</source> 日志的输入源:
| 配置项 | 解释说明 |
| ----------------- | -------------------------------------------------------- |
| @type | 采集日志类型,tail表示增量读取日志内容 |
| path | 日志路径,多个路径可以使用逗号分隔 |
| pos_file | 用于标记已经读取到位置的文件(position file)所在的路径 |
| \<parse>\</parse> | 日志格式解析,根据你自己的日志格式,编写对应的解析规则。 |
\<match>\</match>日志的输出端:
| 配置项 | 解释说明 |
| ------------------- | ------------------------------------------------------------ |
| @type | 输出到的服务类型 |
| aws_key_id | Minio 用户名 |
| aws_sec_key | Minio 密码 |
| s3_endpoint | Minio 访问地址 |
| s3_bucket | Minio 桶名称 |
| force_path_style | 防止 AWS SDK 破坏端点 URL |
| time_slice_format | 每个文件名都加上这个时间戳 |
| \<buffer>\</buffer> | 日志的缓冲区,用于缓存日志事件,提高系统性能。默认使用内存,也可以使用file文件 |
| timekey | 每 60 秒刷新一次累积的chunk |
| timekey_wait | 等待 10 秒再刷新 |
| chunk_limit_size | 每个块的最大大小 |
## 最后
Fluentd 插件可以很灵活的收集业务日志并输出至多个服务,并结合 Rainbond 插件市场的一键安装,让我们的使用变得更加简单、快捷。
目前 Rainbond 开源插件应用市场的 Flunetd 插件只有 `Flunetd-S3` `Flunetd-ElasticSearch7`,欢迎小伙伴们贡献插件哦!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70008902/viewspace-2902143/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Kubernetes 已成底座,为什么很多团队第一次上线还是这么难?
- 不会 Kubernetes 的团队,第一次把应用上线到底卡在哪?一次源码到部署实测给出答案
- 容器平台怎么选型?别先比功能,先看你卡在第一步,还是第十步
- Kubernetes 已成底座,为什么很多团队还是落不了地?
- 信创迁移必看!X86 迁 Arm 竟能全自动适配?
- 还在死磕虚拟机?应用为中心的IT管理新范式,可能被你忽略了!
- 是时候跟虚拟机说再见了?
- 鲲鹏Arm+麒麟V10,国产化信创 K8s 离线部署保姆级教程
- K8S 部署 Deepseek 要 3 天?别逗了!Ollama+GPU Operator 1 小时搞定
- 还不会 Cert Manager 自动签发证书?一文掌握
