我们都知道,在网络爬虫工作中,经常会遇到网站的反爬虫策略,
也就是根据IP来限制,所以我们需要用到HTTP代理。
袋里IP是为爬虫量身定制的一款代理IP软件,每日生产上百万动态优质IP,
安全、高匿、高速,让你在爬虫工作时如鱼得水。
爬虫IP池的实现
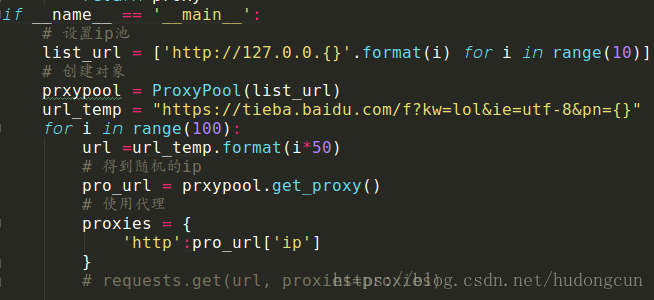
使用代理发送请求:
requests.get(url,proxies={协议:协议+ip+端口})
正向代理:客户端知道最终服务器的地址
反向代理:客户端不知道最终服务器的地址
怎样合理的使用代理:
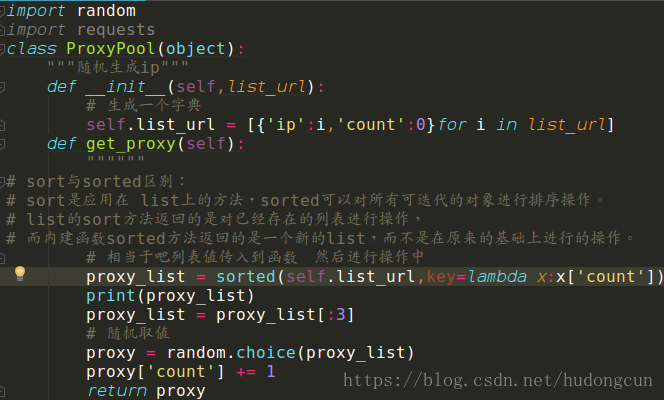
准备一堆的ip地址,组成ip池,随机选择一个ip来时用
如何随机选择代理ip,让使用次数较少的ip地址有更大的可能性被用到
{"ip":ip,"times":0}
[{},{},{},{},{}],对这个ip的列表进行排序,按照使用次数进行排序
选择使用次数较少的10个ip,从中随机选择一个
检查ip的可用性
可以使用requests添加超时参数,判断ip地址的质量
在线代理ip质量检测
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70007159/viewspace-2792923/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
静态IP和动态IP区别是什么?
下一篇:
没有了~

请登录后发表评论
登录
全部评论
