开年首场智算沙龙!龙蜥X SGLang邀你共探软硬件协同“最后一公里”,欢迎报名
在大模型从“参数竞赛”迈向“效能之战”的当下,如何榨干每一枚芯片的算力、打通软硬件协同的“最后一公里”?本次 MeetUp 由 SGLang、阿里云、龙蜥社区主办,邀请多位行业顶尖专家,带来一场硬核技术拆解。活动将深度解析 KVCache 优化、PD/EPD/RL 分离式部署、5D 并行策略等核心技术突破,系统呈现国产 GPU 算力适配 方案;通过 SGLang/Mooncake 团队的前沿技术分享、龙蜥社区智算联盟厂商的圆桌对话,构建覆盖算法架构演进、软硬协同优化、产业生态共建的全栈技术交流平台,为大模型效能提升与自主算力平台落地提供创新思路。
时间:2026.1.31 (周六)13:30-17:45
地点:北京阿里巴巴朝阳园区 · 访客中心B4-314会议室
本次 MeetUp 演讲亮点一览:
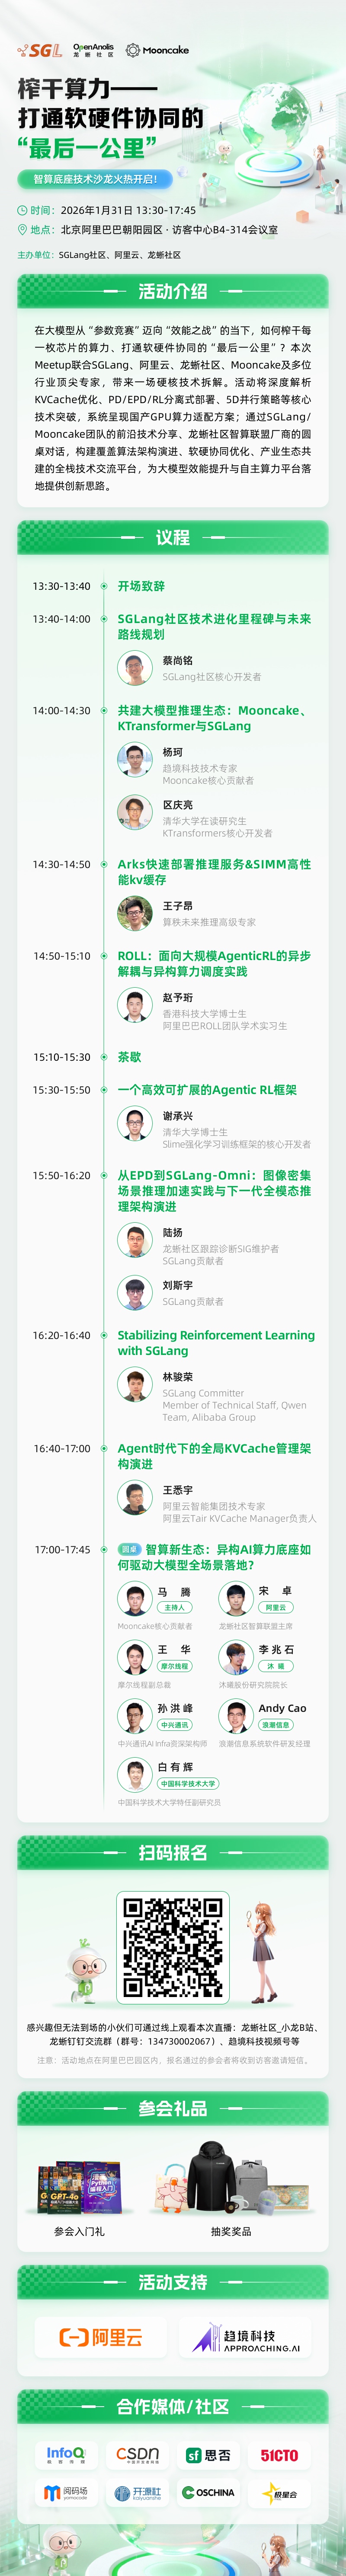
主题:SGLang 社区技术进化里程碑与未来路线规划
嘉宾:蔡尚铭,阿里云智能集团技术专家、SGLang 社区核心开发者
主题 :共建大模型推理生态:Mooncake、KTransformer 与 SGLang
嘉宾:杨珂, 趋境科技技术专家、Mooncake 核心 贡献者 区庆亮, 清华大学在读研究生 、KTransformers 核心开发者
简介 : Mooncake 是以 KVCache 为中心、面向解耦场景设计的分布式大模型推理架构,通过零拷贝传输、多网卡池化与链路优化、弹性扩展与高效内存利用等技术,助力 SGLang 实现了 KVCache 的高效跨节点传输与共享,显著提升了推理性能。KTransformers 是 CPU/GPU 混合的大模型异构推理框架,基于 AVX/AMX 指令集,实现了 NVFP4、FP8、BF16 等原生精度 MoE kernel,支持了高效的原生精度推理。本次分享将聚焦于 Mooncake 和 KTransformers 的架构设计、关键技术特性、最新进展,以及与 SGLang 的集成实践和应用效果。
主题:Arks 快速部署推理服务&SIMM 高性能 kv 缓存
嘉宾:王子昂,算秩未来推理高级专家
简介: Arks 是一个端到端的 Kubernetes 原生大语言模型应用管理框架,为云原生环境中的 LLM 推理工作负载提供健壮可扩展的基础设施,Arks底层使用 rbg 作为 workload 部署管理框架,让开发者专注于推理本身而无需关注底层细节。SiMM 是一款高性能分布式 KV 存储系统,兼具内存级访问速度与云盘级存储容量。它通过分布式架构实现高可用与高扩展,支持海量数据的低延迟读写,适用于缓存、状态存储与大规模在线服务等场景。同时,SiMM 提供开箱即用的部署与运维体验,无需复杂配置即可快速上线,帮助开发者在性能、成本与易用性之间取得最佳平衡。
主题: ROLL:面向大规模 AgenticRL 的异步解耦与异构算力调度实践
嘉宾:赵予珩,香港科技大学 博士生 、阿里巴巴 ROLL 团队学术实习生
简介: 本次分享将介绍阿里巴巴自研强化学习框架 ROLL 及其针对 AgenticRL 异构负载的深度优化方案。重点解读如何通过异构硬件亲和性调度、细粒度异步编排以及状态感知的按需弹性部署,攻克大规模场景下的通信与计算瓶颈。目前,ROLL 已在三千卡集群、千亿参数 MoE 模型上实现了生产级的极 致吞吐;此外,我们将探讨 ROLL 与 Mooncake 存算分离架构结合的未来演进,进一步释放大规模 RL 后训练的潜力。
主题:一个高效可扩展的 Agentic RL 框架
嘉宾: 谢承兴,清华大学 博士生 、Slime 强化学习训练框架的核心开发者
简介:近期,强化学习的任务形态正从以 reasoningtask 为主,逐步演进为更复杂的 Agentictask。这类任务引入了 agentframework,更加复杂的数据生成流程与稳定性挑战,对 RL 训练框架提出了全新要求。本次演讲将聚焦 slime 框架,系统介绍其针对 AgenticRL 场景所做的一系列关键优化设计,包括灵活的 rollout 机制、解耦的 agent 接入方式、高效的并行与同步策略等,全面展示 slime 如何显著提升 AgenticRL 训练的 scalability。
主题:从 EPD 到 SGLang-Omni:图像密集场景推理加速实践与下一代全模态推理架构演进
嘉宾:陆扬: 龙蜥社区跟踪诊断 SIG 维护者、SGLang 贡献者
刘斯宇: 阿里云智能集团开发工程师、SGLang 贡献者
简介: EPD 在图像密集型请求(如单次 4–8 张图)下的部署与优化实践,在 1 QPS 负载下相较非分离部署可将延迟降低约 6–8 倍,并在高 QPS 下实现约 2 倍吞吐提升;同时解析 EPD 解耦架构如何支持组件灵活扩展与异构部署,以更高性价比避免 Prefill 节点成倍扩容。随后讲师聚焦 SGLang 面向 Omni 多模态模型的系统演进,分享如何从现有 LLM 推理架构扩展到同时支持文本、图像、音频、视频等多模态输入输出,并讨论 Processor 拆分、数据流与调度设计、多阶段推理协同等关键问题与社区实践方向。
主题: Stabilizing Reinforcement Learning with SGLang
嘉宾:林骏荣,SGLang Committer,Member of Technical Staff, Qwen Team, Alibaba Group
主题:Agent 时代下的全局 KVCache 管理架构演进
嘉宾:王悉宇,阿里云智能集团技术专家、阿里云 Tair KVCache Manager 负责人
简介:本演讲聚焦 Agent 场景下 KVCache 的存储需求和带来的挑战,梳理了 KVCache 管理模式的演进路径。重点介绍了 SGLang 生态中的Hf3fsMetadataServer(MiniManager),以及阿里云即将开源的企业级全局 KVCache 管理系统—-TairKVCacheManager。该系统已实现对 Mooncake 的原生支持,为 Agent 时代的大模型推理提供稳定高效的 KVCache 存储支持。
圆桌讨论: 智算新生态:异构 AI 算力底座如何驱动大模型全场景落地?
嘉宾:
马腾(主持人),阿里云智能集团高级技术专家
宋卓,龙蜥社区智算联盟主 席、阿里云智能集团资深技术专家
王华,摩尔线程副总裁
李兆石,沐曦股份研究院院长
孙洪峰,中兴通讯 AI Infra 资深架构师
Andy Cao,浪潮信息系统软件研发经理
白有辉,中国科学技术大学特任副研究员
简介:大模型正从“参数竞赛”转向“应用落地”,算力的性能、成本与工程效率成为关键瓶颈。本圆桌邀请阿里云、中兴通讯、沐曦、浪潮信息等企业专家,探讨三大关键:如何通过软硬协同释放异构算力效能?SGLang 与开源社区如何降低部署门槛?在 AI 运维与垂直行业中如何构建稳定、弹性且低成本的推理方案?最终推动AI从技术突破走向产业落地。
更多详细议程见下方海报:
请注意:
1)本场活动线下参会限120人,报满即止。
2)活动地点在阿里巴巴园区内,请提早报名,便于申请访客权限。
3)活动报名请使用支付宝绑定的手机号。报名通过的参会者将收到访客邀请短信,请务必按照短信指引完成操作,否则无法入园。
4)活动当天,可凭二维码、身份证或人脸识别(三选一)入园。
—— 完 ——
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70004278/viewspace-3108157/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 报名倒计时3天!2026 RISC-V Summit 中国峰会龙蜥生态分论坛亮点抢先看
- 欢迎报名!2026 RISC-V Summit中国峰会龙蜥分论坛邀您共探Agentic CPU新命题
- 龙蜥社区 SkillHub 推荐系统正式发布,首批技能生态奖项揭晓
- 人气爆棚!2026 云栖大会“AI Agent 原生操作系统”分论坛精彩回顾来啦
- 8 大 Skill 实战集中亮相,龙蜥社区 SkillHub 首 场线下 Workshop 圆满举办
- 驱动装不上、透传总报错?三类芯片裸金属适配经验全收进这个 AI Skill
- 从“能启动”到“可验证” ,一条命令在Anolis OS拉起统一大模型网关
- 共同探讨训推融通新路径,龙蜥 x 壁仞 PyTorch 生态共建 MeetUp 圆满收官
- 恭喜这12支队伍!CCF 开源创新大赛 Mooncake 赛题获奖名单揭晓
- 从 3 天排查缩到 20 分钟,一个内核老兵的 AI Skill 诞生记 | 龙蜥 SkillHub 精选
