数据页结构的快速浏览
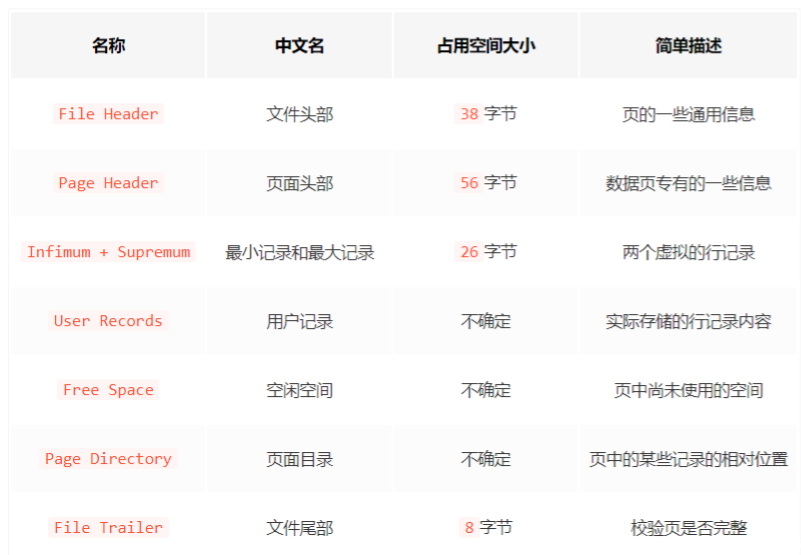
数据页代表的这块16KB大小的存储空间可以被划分为多个部分,不同部分有不同的功能,各个部分如图所示:
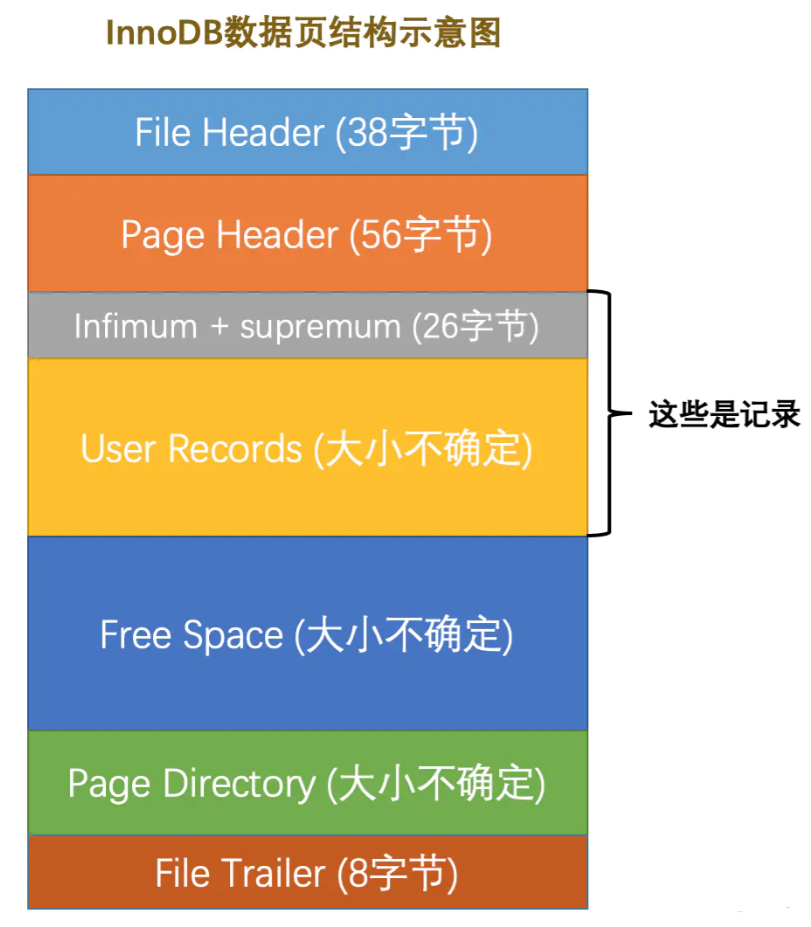

一个InnoDB数据页的存储空间大致被划分成了7个部分
一、记录在页中的存放
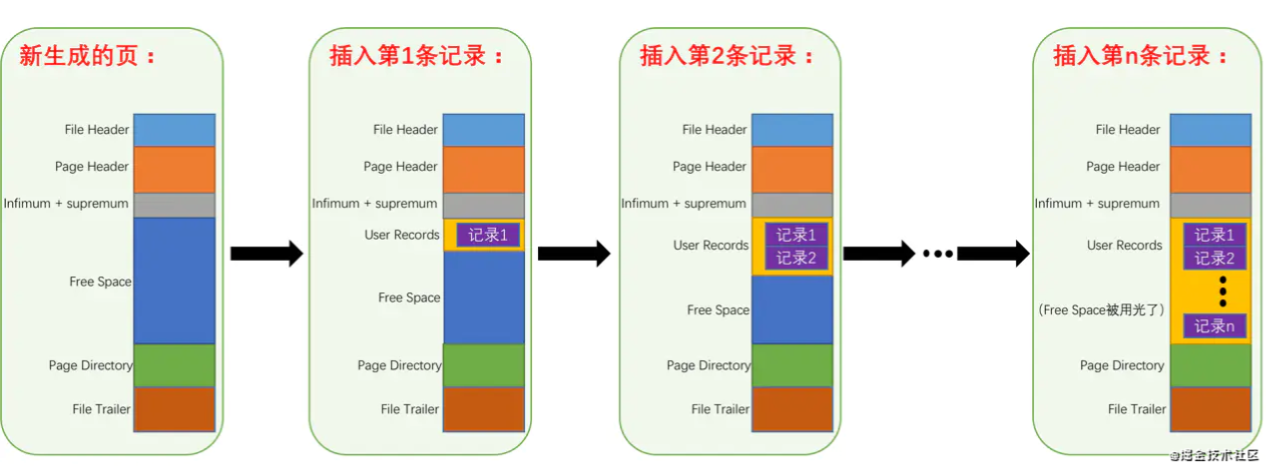
- 存储的记录会按照我们指定的行格式存储到User Records部分
- 一开始生成页的时候,其实并没有User Records这个部分,每当我们插入一条记录,都会从Free Space部分,也就是尚未使用的存储空间中申请一个记录大小的空间划分到User Records部分,
- 当Free Space部分的空间全部被User Records部分替代掉之后,也就意味着这个页使用完了,如果还有新的记录插入的话,就需要去申请新的页了
1、记录头信息的秘密
我们先创建一个表:
mysql> CREATE TABLE page_demo(
    ->     c1 INT,
    ->     c2 INT,
    ->     c3 VARCHAR(10000),
    ->     PRIMARY KEY (c1)
    -> ) CHARSET=ascii ROW_FORMAT=Compact;
Query OK, 0 rows affected (0.03 sec)
c1和c2列是用来存储整数的,c3列是用来存储字符串的
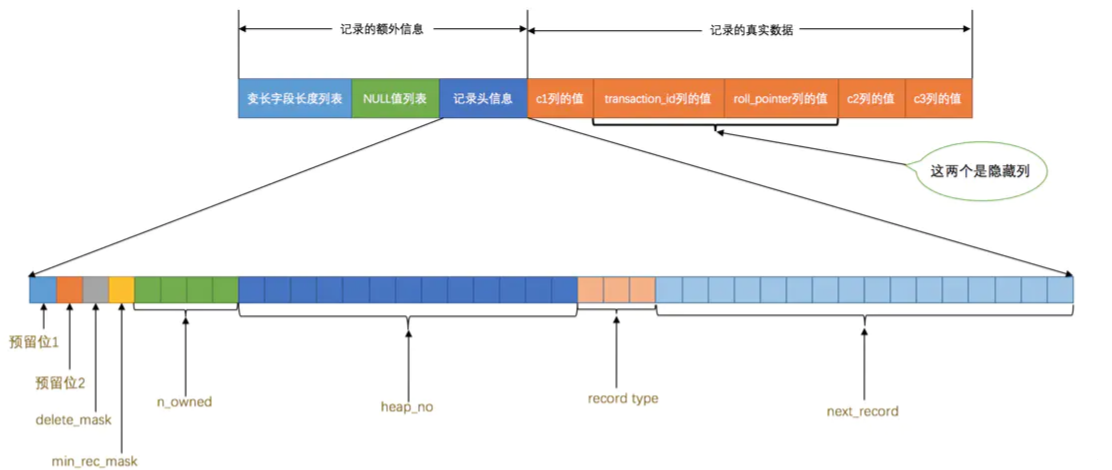
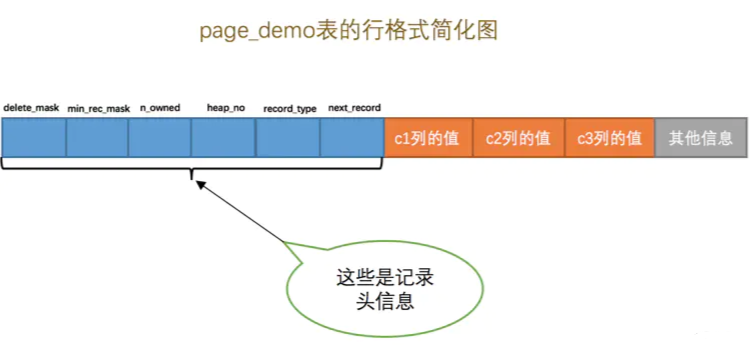
在page_demo表的行格式演示图中画出有关的头信息属性以及c1、c2、c3列的信息(其他信息没画不代表它们不存在啊,只是为了理解上的方便在图中省略了~),简化后的行格式示意图就是这样:
继续插入数据
mysql> INSERT INTO page_demo VALUES(1, 100, 'aaaa'), (2, 200, 'bbbb'), (3, 300, 'cccc'), (4, 400, 'dddd');
Query OK, 4 rows affected (0.00 sec)
Records: 4 Duplicates: 0 Warnings: 0
如图所示
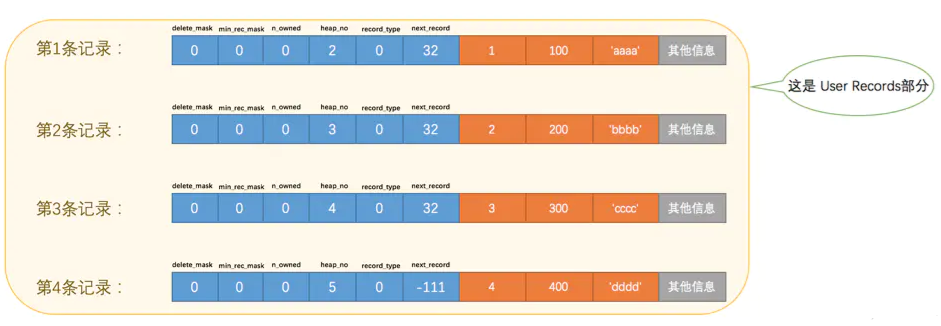
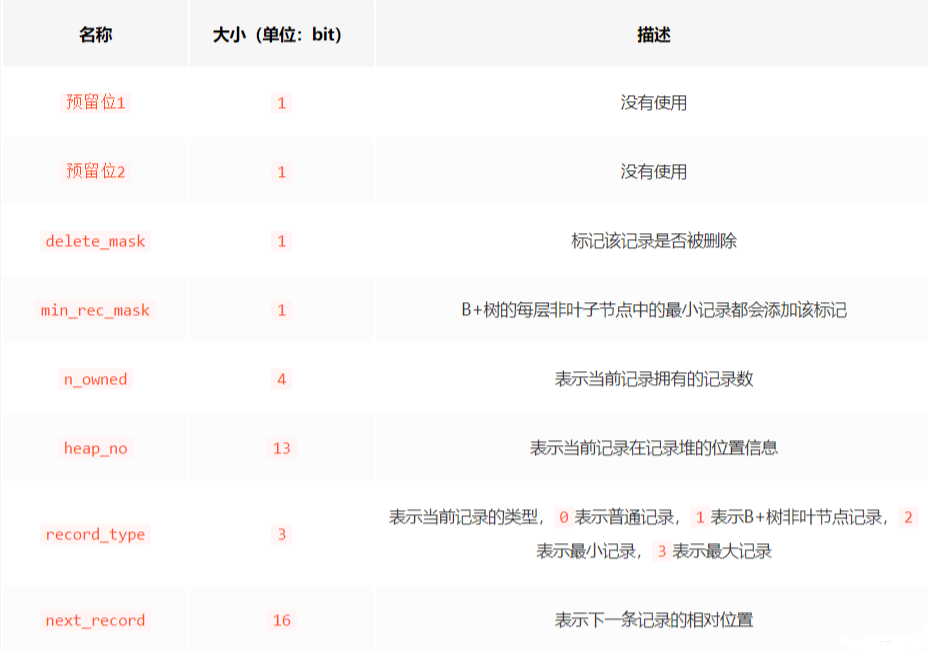
- delete_mask 这个属性标记着当前记录是否被删除,占用1个二进制位,值为0的时候代表记录并没有被删除,值为1的时候代表记录被删除掉了。 并不会立即删除,而是会将所有被删除掉的记录都会组成一个所谓的垃圾链表,在这个链表中的记录占用的空间称之为所谓的可重用空间,之后如果有新记录插入到表中的话,可能把这些被删除的记录占用的存储空间覆盖掉。
- min_rec_mask B+树的每层非叶子节点中的最小记录都会添加该标记
- n_owned 这个暂时保密,稍后它就是主角~
- heap_no 这个属性表示当前记录在本页中的位置,从图中可以看出来,我们插入的4条记录在本页中的位置分别是:2、3、4、5。少了 0 和 1 mysql会每个页里边儿加了两个记录,由于这两个记录并不是我们自己插入的,所以有时候也称为伪记录或者虚拟记录。这两个伪记录一个代表最小记录,一个代表最大记录 记录是可用比大小的,比较的是主键 不管我们向页中插入了多少自己的记录,Mysql都会自动生成两条伪记录分别为最小记录与最大记录。这两条记录的构造十分简单,都是由5字节大小的记录头信息和8字节大小的一个固定的部分组成的,如图所示
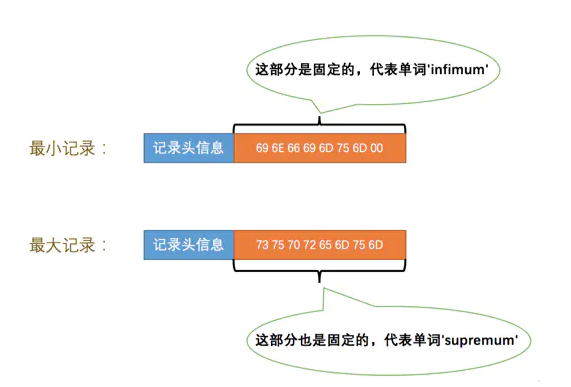
由于这两条记录不是我们自己定义的记录,所以它们并不存放在页的User Records部分,他们被单独放在一个称为Infimum + Supremum的部分,如图所示:
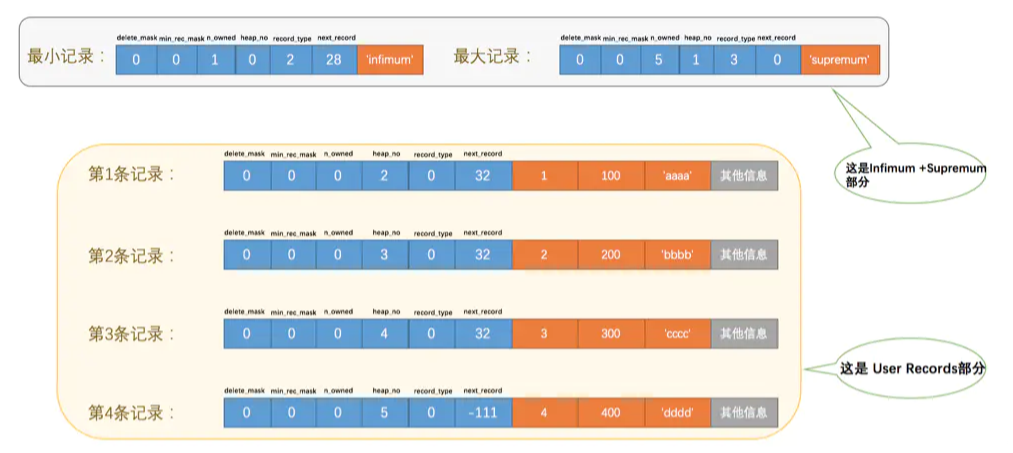
其代表的 heap_no 分别是 0 和 1
record_type 这个属性表示当前记录的类型,一共有4种类型的记录,0表示普通记录,1表示B+树叶节点记录,2表示最小记录,3表示最大记录。从图中我们也可以看出来,我们自己插入的记录就是普通记录,它们的record_type值都是0,而最小记录和最大记录的record_type值分别为2和3
next_record 它表示从当前记录的真实数据到下一条记录的真实数据的地址偏移量 最大记录的next_record的值为0
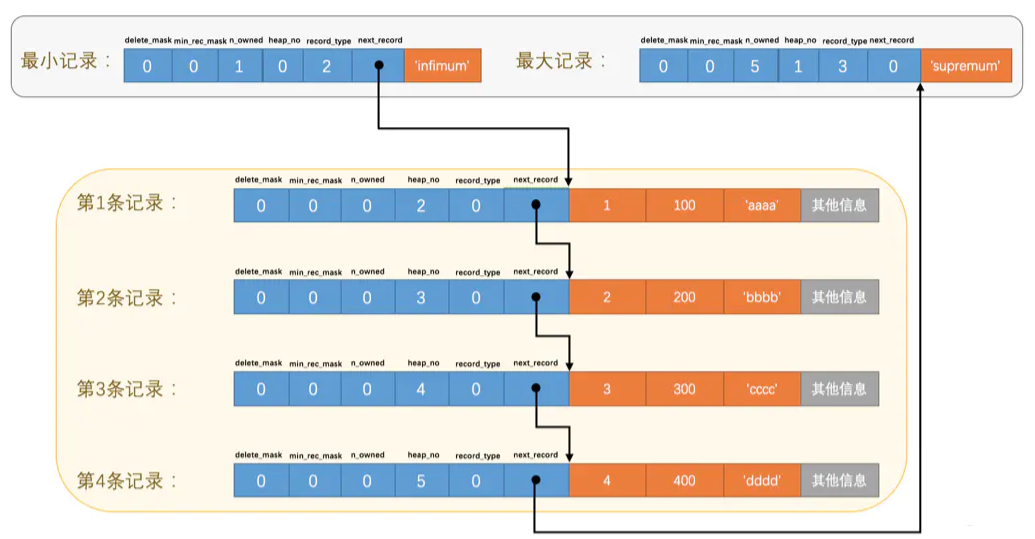
如果从中删除掉一条记录,这个链表也是会跟着变化的,比如我们把第2条记录删掉:
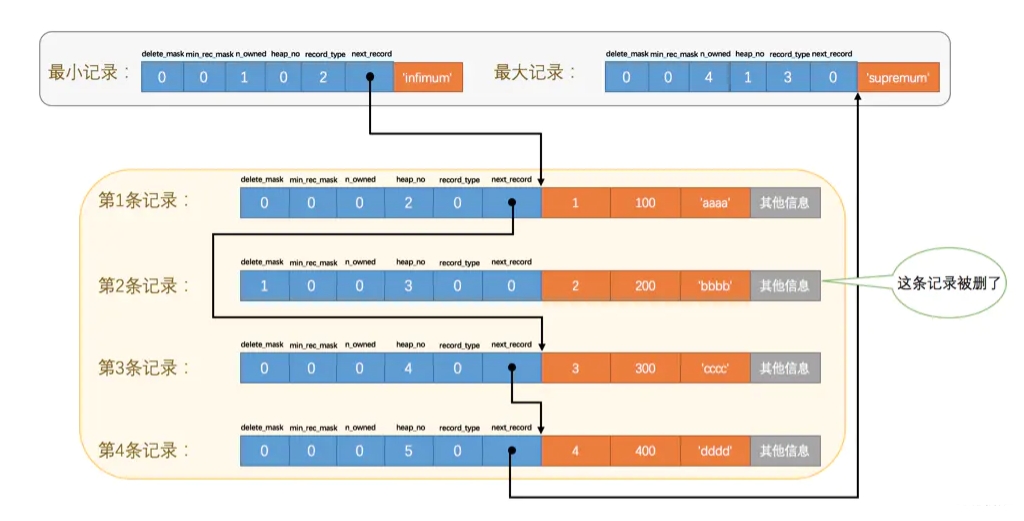
从图中可以看出来,删除第2条记录前后主要发生了这些变化: 第2条记录并没有从存储空间中移除,而是把该条记录的delete_mask值设置为1。 第2条记录的next_record值变为了0,意味着该记录没有下一条记录了。 第1条记录的next_record指向了第3条记录。 还有一点你可能忽略了,就是最大记录的n_owned值从5变成了4,关于这一点的变化我们稍后会详细说明的。
如果我们再次把这条记录插入到表中的话

从图中可以看到,InnoDB并没有因为新记录的插入而为它申请新的存储空间,而是直接复用了原来被删除记录的存储空间。
二、Page Directory(页目录)
现在我们了解了记录在页中按照主键值由小到大顺序串联成一个单链表,那如果我们想根据主键值查找页中的某条记录该咋办呢
SELECT * FROM page_demo WHERE c1 = 3;
MySQL 的查询流程 将所有正常的记录(包括最大和最小的记录,不包括标记为已删除的记录)划分为几个组。 每个组的最后一条记录(也就是组内最大的那条记录)的头信息中的n_owned属性表示该记录拥有多少条记录, 也就是该组内共有几条记录。 将每个组的 最后一条记录的地址偏移量单独提取出来按顺序存储到靠近页的尾部的地方,这个地方就是所谓的Page Directory,也就是页目录(此时应该返回头看看页面各个部分地图)。页面目录中的这些地址偏移量被称为槽(英文名:Slot),所以这个页面目录就是由槽组成的。
比方说现在的page_demo表中正常的记录共有6条,InnoDB会把它们分成两组,第一组中只有一个最小记录,第二组中是剩余的5条记录,看下边的示意图:
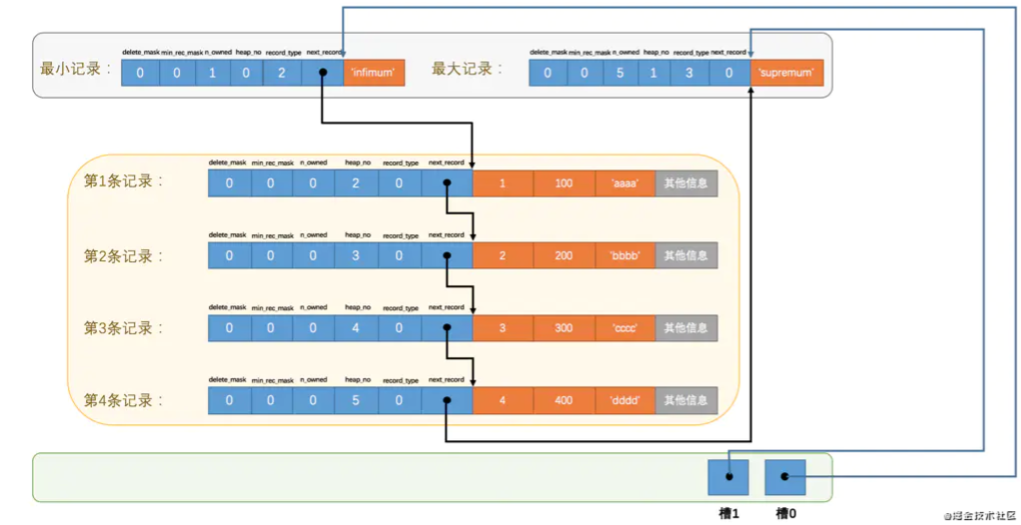
注意最小和最大记录的头信息中的n_owned属性 最小记录的n_owned值为1,这就代表着以最小记录结尾的这个分组中只有1条记录,也就是最小记录本身。 最大记录的n_owned值为5,这就代表着以最大记录结尾的这个分组中只有5条记录,包括最大记录本身还有我们自己插入的4条记录。
对于最小记录所在的分组只能有 1 条记录,最大记录所在的分组拥有的记录条数只能在 1~8 条件之间,剩下的分组中记录的条数范围只能在是 4~8 条之间。
所以 最小记录的 n_owned 是 1, 当前最大记录的 n_owned 是 5

之后每插入一条记录,都会从页目录中找到主键值比本记录的主键值大并且差值最小的槽,然后把该槽对应的记录的n_owned值加1,表示本组内又添加了一条记录,直到该组中的记录数等于8个。
在一个组中的记录数等于8个后再插入一条记录时,会将组中的记录拆分成两个组,一个组中4条记录,另一个5条记录。这个过程会在页目录中新增一个槽来记录这个新增分组中最大的那条记录的偏移量。
再次添加12条数据
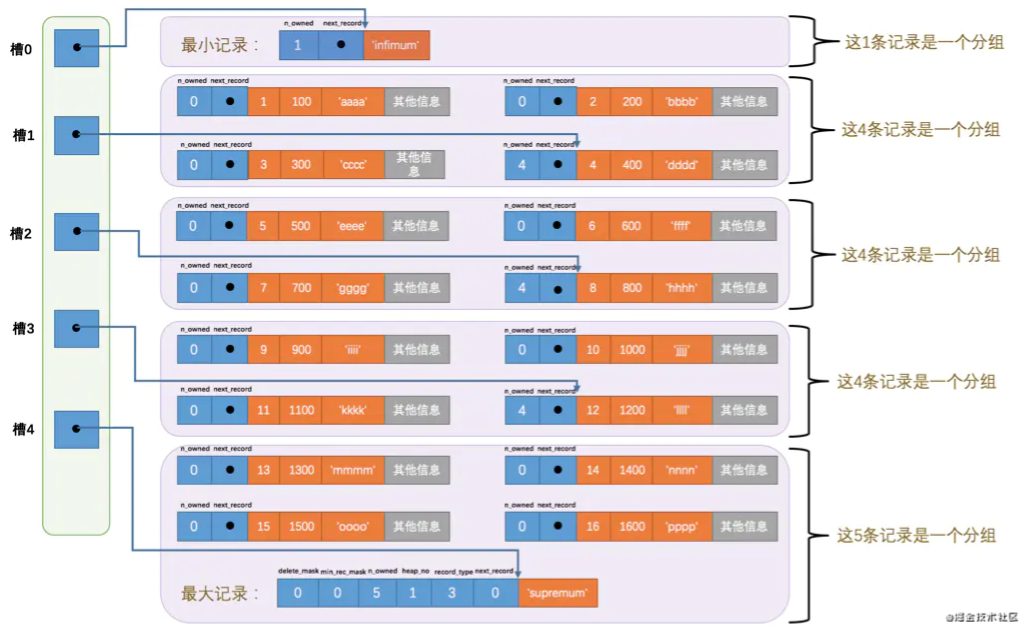
比方说我们想找主键值为6的记录
- 计算中间槽的位置:(0+4)/2=2,所以查看槽2对应记录的主键值为8,又因为8 > 6,所以设置high=2,low保持不变。
- 重新计算中间槽的位置:(0+2)/2=1,所以查看槽1对应的主键值为4,又因为4 < 6,所以设置low=1,high保持不变。
- 因为high - low的值为1,所以确定主键值为6的记录在槽2对应的组中。此刻我们需要找到槽2中主键值最小的那条记录,然后沿着单向链表遍历槽2中的记录。
- 我们可以拿到槽1对应的记录(主键值为4),该条记录的下一条记录就是槽2中主键值最小的记录,该记录的主键值为5。所以我们可以从这条主键值为5的记录出发,遍历槽2中的各条记录,直到找到主键值为6的那条记录即可。由于一个组中包含的记录条数只能是1~8条,所以遍历一个组中的记录的代价是很小的。
所以在一个数据页中查找指定主键值的记录的过程分为两步:
- 通过二分法确定该记录所在的槽,并找到该槽所在分组中主键值最小的那条记录。
- 通过记录的next_record属性遍历该槽所在的组中的各个记录。
三、Page Header(页面头部)
为了能得到一个 数据页中存储的记录的状态信息,比如本页中已经存储了多少条记录,第一条记录的地址是什么,页目录中存储了多少个槽等等,特意在页中定义了一个叫Page Header的部分,它是页结构的第二部分,这个部分占用固定的56个字节,专门存储各种状态信息,具体各个字节都是干嘛的看下表:
| 名称 | 占用空间大小 | 描述 |
|---|---|---|
| PAGE_N_DIR_SLOTS | 2字节 | 在页目录中的槽数量 |
| PAGE_HEAP_TOP | 2字节 | 还未使用的空间最小地址,也就是说从该地址之后就是Free Space |
| PAGE_N_HEAP | 2字节 | 本页中的记录的数量(包括最小和最大记录以及标记为删除的记录) |
| PAGE_FREE | 2字节 | 第一个已经标记为删除的记录地址(各个已删除的记录通过next_record也会组成一个单链表,这个单链表中的记录可以被重新利用) |
| PAGE_GARBAGE | 2字节 | 已删除记录占用的字节数 |
| PAGE_LAST_INSERT | 2字节 | 最后插入记录的位置 |
| PAGE_DIRECTION | 2字节 | 记录插入的方向 |
| PAGE_N_DIRECTION | 2字节 | 一个方向连续插入的记录数量 |
| PAGE_N_RECS | 2字节 | 该页中记录的数量(不包括最小和最大记录以及被标记为删除的记录) |
| PAGE_MAX_TRX_ID | 8字节 | 修改当前页的最大事务ID,该值仅在二级索引中定义 |
| PAGE_LEVEL | 2字节 | 当前页在B+树中所处的层级 |
| PAGE_INDEX_ID | 8字节 | 索引ID,表示当前页属于哪个索引 |
| PAGE_BTR_SEG_LEAF | 10字节 | B+树叶子段的头部信息,仅在B+树的Root页定义 |
| PAGE_BTR_SEG_TOP | 10字节 | B+树非叶子段的头部信息,仅在B+树的Root页定义 |
四、File Header(文件头部)
存储页的通用信息,比方说这个页的编号是多少,它的上一个页、下一个页是谁啦吧啦吧啦~ 这个部分占用固定的38个字节,是由下边这些内容组成的:
| 名称 | 占用空间大小 | 描述 |
|---|---|---|
| FIL_PAGE_SPACE_OR_CHKSUM | 4字节 | 页的校验和(checksum值) |
| FIL_PAGE_OFFSET | 4字节 | 页号 |
| FIL_PAGE_PREV | 4字节 | 上一个页的页号 |
| FIL_PAGE_NEXT | 4字节 | 下一个页的页号 |
| FIL_PAGE_LSN | 8字节 | 页面被最后修改时对应的日志序列位置(英文名是:Log Sequence Number) |
| FIL_PAGE_TYPE | 2字节 | 该页的类型 |
| FIL_PAGE_FILE_FLUSH_LSN | 8字节 | 仅在系统表空间的一个页中定义,代表文件至少被刷新到了对应的LSN值 |
| FIL_PAGE_ARCH_LOG_NO_OR_SPACE_ID | 4字节 | 页属于哪个表空间 |
对照着这个表格,我们看几个目前比较重要的部分:
- FIL_PAGE_SPACE_OR_CHKSUM 这个代表当前页面的校验和(checksum)。啥是个校验和?就是对于一个很长很长的字节串来说,我们会通过某种算法来计算一个比较短的值来代表这个很长的字节串,这个比较短的值就称为校验和。这样在比较两个很长的字节串之前先比较这两个长字节串的校验和,如果校验和都不一样两个长字节串肯定是不同的,所以省去了直接比较两个比较长的字节串的时间损耗。
- FIL_PAGE_OFFSET 每一个页都有一个单独的页号,就跟你的身份证号码一样,InnoDB通过页号来可以唯一定位一个页。
- FIL_PAGE_TYPE 这个代表当前页的类型,我们前边说过,InnoDB为了不同的目的而把页分为不同的类型,我们上边介绍的其实都是存储记录的数据页,其实还有很多别的类型的页,具体如下表: 类型名称十六进制描述FIL_PAGE_TYPE_ALLOCATED0x0000最新分配,还没使用FIL_PAGE_UNDO_LOG0x0002Undo日志页FIL_PAGE_INODE0x0003段信息节点FIL_PAGE_IBUF_FREE_LIST0x0004Insert Buffer空闲列表FIL_PAGE_IBUF_BITMAP0x0005Insert Buffer位图FIL_PAGE_TYPE_SYS0x0006系统页FIL_PAGE_TYPE_TRX_SYS0x0007事务系统数据FIL_PAGE_TYPE_FSP_HDR0x0008表空间头部信息FIL_PAGE_TYPE_XDES0x0009扩展描述页FIL_PAGE_TYPE_BLOB0x000A溢出页FIL_PAGE_INDEX0x45BF索引页,也就是我们所说的数据页 我们存放记录的数据页的类型其实是FIL_PAGE_INDEX,也就是所谓的索引页。至于啥是个索引,且听下回分解~
- FIL_PAGE_PREV和FIL_PAGE_NEXT

五、总结
一个数据页可以被大致划分为7个部分,分别是 File Header,表示页的一些通用信息,占固定的38字节。 Page Header,表示数据页专有的一些信息,占固定的56个字节。 Infimum + Supremum,两个虚拟的伪记录,分别表示页中的最小和最大记录,占固定的26个字节。 User Records:真实存储我们插入的记录的部分,大小不固定。 Free Space:页中尚未使用的部分,大小不确定。 Page Directory:页中的某些记录相对位置,也就是各个槽在页面中的地址偏移量,大小不固定,插入的记录越多,这个部分占用的空间越多。 File Trailer:用于检验页是否完整的部分,占用固定的8个字节。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70000438/viewspace-2783582/ ,如需转载,请注明出处,否则将追究法律责任。

