前言
在Zookeeper集群中,客户端会随机连接到Zookeeper集群中 的一个节点。
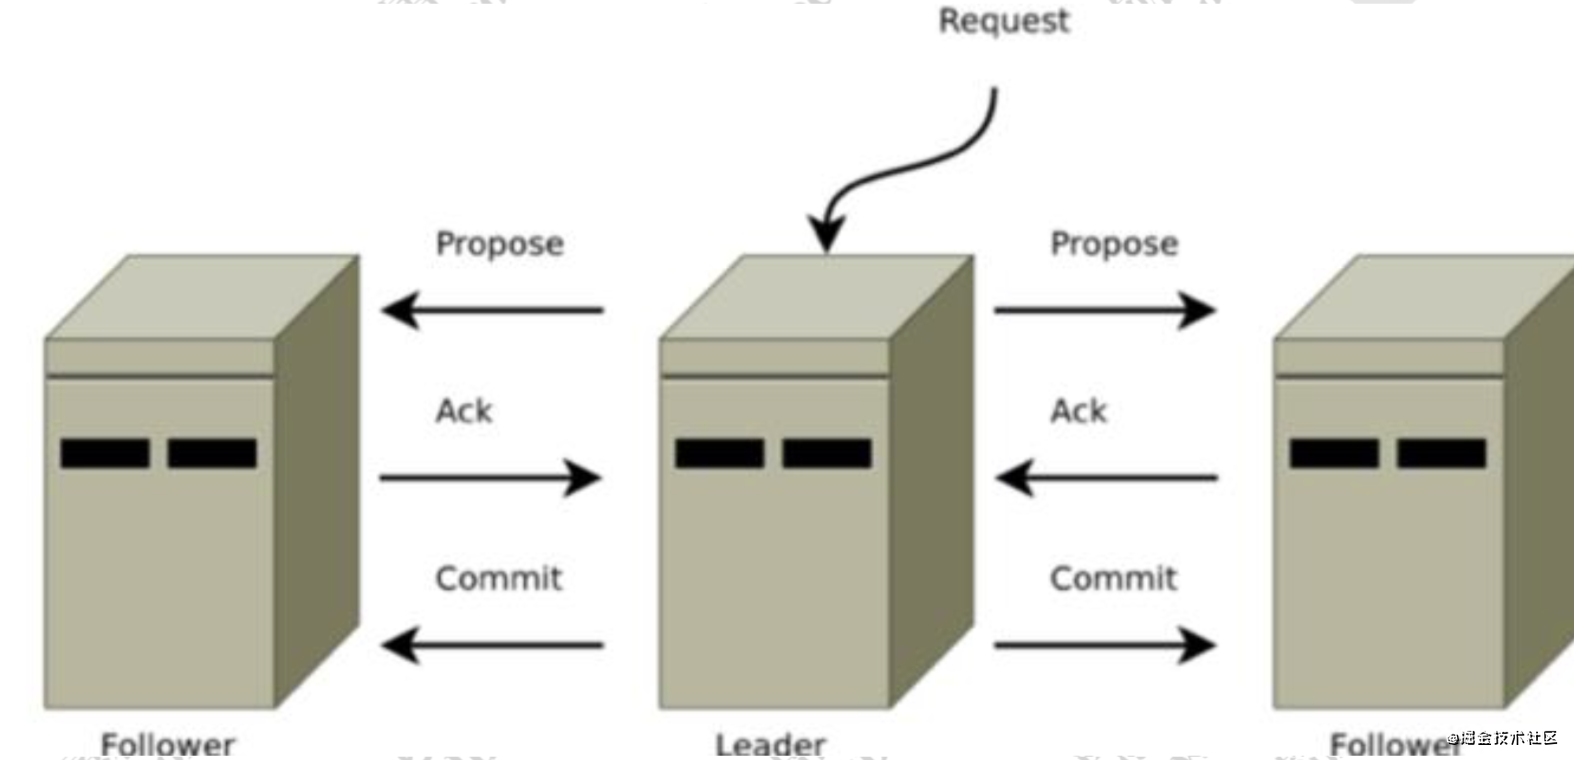
如果是读请求,就直接从当前节点中读取数据,如果是写请求,那么请求先会被转发给leader提交事务。然后leader再广播事务,只要有超过半数节点写入成功, 那么写请求就会被提交(类2PC事务)。整个过程如下图所示:


整套数据同步机制是通过
ZAB协议实现的,下面我们重点了解一下
ZAB协议的实现原理。
ZAB协议简介
ZAB(Zookeeper Atomic Broadcast) 协议是为Zookeeper专门设计的一种支持崩溃恢复的原子广播协议。在 ZooKeeper 中,主要依赖
ZAB协议来实现 分布式数据一致性。
ZAB协议包含两种基本模式,分别是崩溃恢复和消息广播。
当整个集群在启动时,或者当
leader节点出现网络中断、 崩溃等情况时,
ZAB协议就会进入恢复模式并选举产生新的
leader,当
leader服务器选举出来后,并且集群中有过半的机器和该
leader节点完成数据同步后(同步指的是数据同步,用来保证集群中过半的机器能够和
leader服务器的数据状态保持一致),
ZAB协议就会退出恢复模式。
当集群中已经有过半的
follower节点完成了和
leader状态同步以后,那么整个集群就进入了消息广播模式。这个时候,在
leader节点正常工作时,启动一台新的服务器加入到集群,那这个服务器会直接进入数据恢复模式,和
leader节点进行数据同步。同步完成后即可正常对外提供非事务请求的处理。
leader节点可以处理事务请求和非事务请求,
follower节点只能处理非事务请求,如果
follower节点接收到非事务请求,会把这个请求转发给
leader服务器。
消息广播实现原理
消息广播的过程实际上是一个 简化版本的二阶段提交过程,具体过程如下:
-
leader接收到消息请求后,将消息赋予一个全局唯一的64位自增id(zxid)。 -
leader为每个follower准备了一个FIFO队列(通过TCP协议来实现,以实现了全局有序这一个特点)将带有zxid的消息作为一个提案(proposal)分发给所有的follower。 -
当
follower接收到proposal,先把proposal写到磁盘,写入成功以后再向leader回复一个ack。 -
当
leader接收到合法数量(超过半数节点)的ACK后,leader就会向这些follower发送commit命令,同时会在本地执行该消息。 -
当
follower收到消息的commit命令以后,会提交该消息。
关于ZXID
zxid是Zookeeper的事务id,为了保证事务的顺序一致性,zookeeper采用了递增的事务id号(
zxid)来标识事务。所有的提案(proposal)都在被提出的时候加上了
zxid。
zxid是一个64 位数字,高32位是
epoch用来标识
leader关系是否改变,每次一个leader被选出来,新
leader都会将
epoch加1,标识当前
leader的统治时期。低32位用于递增计数。
epoch可以理解为当前集群所处的年代或者周期,每个
leader就像皇帝,都有自己的年号,所以每次改朝换代,
leader变更之后,都会在前一个年代的基础上加 1。这样就算旧的
leader崩溃恢复之后,也没有人听他的了,因为
follower只听从当前年代的
leader的命令。
崩溃恢复实现原理
前面我们已经讲过了
ZAB协议中的消息广播过程,在正常情况下,上述方式是没有任何问题的,但是一旦
leader 节点崩溃,或者由于网络问题导致
leader服务器失去了过半的
follower节点的联系,那么Zookeeper集群就会进入到崩溃恢复模式。崩溃恢复状态下 zab 协议需要做两件事,
选举出新的leader和
数据同步。
leader失去与过半follower节点联系,可能是leader节点和follower节点之间产生了网络分区,那么此时的leader不再是合法的leader了。
前面在讲解消息广播时,知道
ZAB协议的消息广播机制是简化版本的
2PC协议,这种协议只需要集群中过半的节点 响应提交即可。但是它无法处理
leader服务器崩溃带来的数据不一致问题。因此在 ZAB 协议中添加了一个
崩溃恢复模式来解决这个问题。
ZAB协议中的崩溃恢复需要保证,
如果一个事务 Proposal 在一台机器上被处理成功,那么这个事务应该在所有机器上都被处理成功,哪怕是出现故障。 为了达到这 个目的,我们先来设想一下,在
Zookeeper中会有哪些场 景导致数据不一致性,以及针对这些场景,
zab协议中的崩溃恢复应该怎么处理。
已经被处理的消息不能丢
当
leader收到合法数量
follower的
ACK后,就向各个
follower广播
COMMIT命令,同时也会在本地执行
COMMIT并向连接的客户端返回「成功」。但是如果在各个
follower在收到
COMMIT命令前
leader就挂了,导致剩下的服务器并没有执行都这条消息。

图中的
C2就是一个典型的例子,在集群正常运过程的某一个时刻,
Server1是
leader服务器,先后广播了消 息P1、P2、C1、P3和C2。其中当
leader服务器把消息
C2(Commit事务proposal2)发出后就立即崩溃退出了,那么针对这种情况,
ZAB协议就需要确保事务
Proposal2最终能够在所有的服务器上都能被提交成功,否则将会出现不一致。
被丢弃的消息不能再次出现
当
leader接收到消息请求生成
proposal后就挂了,其他
follower并没有到此
proposal,因此经过恢复模式重新选了
leader后,这条消息是被跳过的。 此时,之前挂了的
leader重新启动并注册成了 follower, 他保留了被跳过消息的proposal 状态,与整个系统的状态是不一致的,需要将其删除。
解决方案
ZAB协议需要满足上面两种情况,就必须要设计一个
leader选举算法。能够确保已经被
leader提交的事务
Proposal能够提交、同时丢弃已经被跳过的事务
Proposal。
-
如果
leader选举算法能够保证新选举出来的leader服务器拥有集群中所有机器最高编号(ZXID最大)的事务Proposal,那么就可以保证这个新选举出来的leader一定具有已经提交的提案。因为所有提案被COMMIT之前必须有超过半数的follower返回了ACK,即必须有超过半数节点的服务器的事务日志上有该提案的proposal,因此,只要有合法数量的节点正常工作,就必然有一个节点保存了所有被COMMIT消息的proposal状态。 -
另外一个,
zxid是64位,高32位是epoch编号,每经过一次leader选举产生一个新的leader,新的leader会将epoch号+1,低32位是消息计数器,每接收到一条消息这个值+1,新leader选举后这个值重置为 0.这样设计的好处在于老的leader挂了以后重启,它不会被选举为leader,因此此时它的zxid肯定小于当前新的leader。当老的leader作为follower接入新的leader后,新的leader会让它将所有的拥有旧的epoch号的未被COMMIT的proposal清除。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70000438/viewspace-2783337/ ,如需转载,请注明出处,否则将追究法律责任。

