DT 时代取代IT时代标志性的改变就是我们生活中所见的数据种类和数据量发生了日益万千的变化。各行各业都开始储备数据,积攒数据及使用数据,数据的表现形式,Excel 无非被各行各业广泛使用,欢迎度很高,数据展示也是一目了然。丰富的Excel函数更是提高了简易型和灵活性。
处身于数据行业,日常工作中录入Excel数据到各种数据库已经是很常见的事情了。但,很多时候会发现这些数据的使用价值就是一次性的。录入到数据库的目的就是为了更好使用sql 的复杂性来筛选我们想要的结果集。可不可以直接利用excel中的数据直接做伪SQL查询呢 ?做到不入库直接在excel中实现SQL查询。pandas 可以帮我实现,于是利用周日的时间尝试了下,直奔主题, 以下代码,包含了针对一个sheet页中增删改查,及其不同sheet页的连接查询。
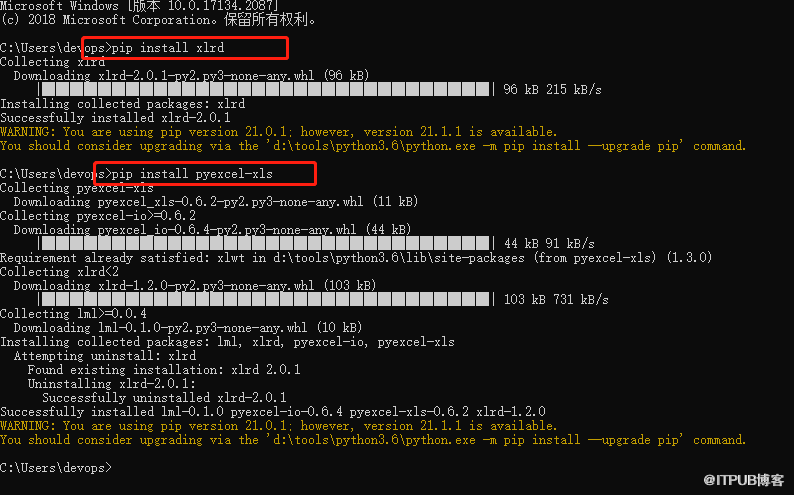
使用pandas 时除了安装pandas之外还要做如下俩步安装。
import pandas as pd
import numpy as np
#做正确的事,比正确的做事来说,会对你很不一样。
#mybk—Sy—yzy
#2021-05-16 周日
ptah="D:\\data\\ExcelSql\\testData.xlsx"
Sheet="Sheet1"
Sheet2="Sheet2"
#1. 读取 excel指定sheet页签中指定标题头所有数据
read = pd.read_excel(io="D:\\data\\ExcelSql\\testData.xlsx",sheet_name='Sheet1')
search = read[["sl", "sw", "pl", "pw"]]#title
print("select s1,sw,pl,pw from testData;")
print(search)
#2.多条件的与或过滤查询 WHERE ANDIOR 逻辑与
read2 = pd.read_excel(io=ptah,sheet_name=Sheet)
search = read2[
    (read2["classes"] == 1) &
     (read2["pl"] >= 5)
    ]
print("SELECT * FROM testData WHERE classes = 1 AND pl >= 5 LIMIT 2;");
print(search)
#3.或关系 |
read3 = pd.read_excel(io=ptah,sheet_name=Sheet)
read3['grade'] = read3.sl.apply(lambda x : 'good' if x > 0 else 'bad')#判断数据grade列,比较数值大小,赋值标签
print("================================这里用到了pandas中的apply函数================================================")
print(read3)
search = read3[
               (read3["sl"] >= 5)
               |(read3["pl"] >= 5)
              ]
print("SELECT * FROM testData WHERE sl >= 5 OR pl >=5 LIMIT 2;")
print(search)
#4.判断是否为空 is null
read4 = pd.read_excel(io=ptah,sheet_name=Sheet)
search = read4[read4["sl"].isna()]
print("SELECT * FROM testData WHERE sl IS NULL;");
print(search)
#5.非空 判断 is  not  null
read5 = pd.read_excel(io=ptah,sheet_name=Sheet)
search = read5[read5["sl"].notna()]
print("SELECT * FROM testData  WHERE sl IS NOT NULL;")
print(search)
#6.排序 ORDER BY ASC|DESC
read6 = pd.read_excel(io=ptah,sheet_name=Sheet)
search = read6[(read6["sl"] >= 6)].sort_values( by="classes", ascending=False)
print("SELECT * FROM testData WHERE sl >= 6 ORDER BY DESC classes;")
print(search)
#7.更新 UPDATE
read7 = pd.read_excel(io=ptah,sheet_name=Sheet)
read7.loc[(read7["pw"] == 1.7) & (read7["pl"] >= 5), "classes"] = 2
print("UPDATE testData SET classes = 2 WHERE pw = 1.7 AND pl >= 5;");
print(read7[read7["pw"] == 1.7]) #并不是把excel 数据中的calsses 更新成2 是 把读取到代码里的伪数据更新成了2
#8.分组统计 GROUP BY
read8 = pd.read_excel(io=ptah,sheet_name=Sheet)
count = read8.groupby("classes").size()
print("SELECT classes, COUNT(*) FROM testData GROUP BY classes;")
print(count)
#9.分组统计 聚合输出
read9 = pd.read_excel(io=ptah,sheet_name=Sheet)
search = read9.groupby("classes").agg(
          {"sl":np.max, "pl":np.mean}) #sl 最大值  pl 平均值
print("SELECT classes, avg(pl), max(sl) FROM testData GROUP BY classes;")
print(search)
#10.删除
read10 = pd.read_excel(io=ptah,sheet_name=Sheet)
drop = read10.drop(read10[(read10["pw"] == 1.7) &
                       (read10["pl"] >= 5)].index)
print("DELETE FROM iris WHERE pw = 1.7 AND pl >=5;")
print(drop[drop["pw"] > 1.6])
#11.UNION & JOIN  关联不同sheet页查询
Sheet1 = pd.read_excel(io=ptah,sheet_name=Sheet)
Sheet2 = pd.read_excel(io=ptah,sheet_name=Sheet2)
inner = pd.merge(Sheet1, Sheet2, on="classes")
print("SELECT * FROM Sheet1 INNER JOIN Sheet2 ON iris_a.classes = iris_b.classes;")
print(inner)
#12.左连接 LEFT OUTER JOIN   关联不同sheet页查询
#
#
# Sheet1 = pd.read_excel(io=ptah,sheet_name=Sheet)
#
# Sheet2 = pd.read_excel(io=ptah,sheet_name=Sheet2)
#
# inner = pd.merge(Sheet1, Sheet2, on="classes", how="left")
# print("SELECT * FROM Sheet1 LEFT JOIN Sheet2 ON iris_a.classes = iris_b.classes;")
# print(inner)
#13 右连接
#
# Sheet1 = pd.read_excel(io=ptah,sheet_name=Sheet)
#
# Sheet2 = pd.read_excel(io=ptah,sheet_name=Sheet2)
#
# inner = pd.merge(Sheet1, Sheet2, on="classes", how="right")
# # print("SELECT * FROM Sheet1 RIGHT JOIN Sheet2 ON iris_a.classes = iris_b.classes;")
# print(inner)
#
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69999437/viewspace-2772497/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
MongoDB Replica Set
下一篇:
没有了~

请登录后发表评论
登录
全部评论
