决策模型Jev发布之后,海外大厂跟进迅速。
OpenAI在2周之内就发布了Decisions API,紧接着AWS发布了Strands Decider 2B,此后微软发布Microsoft-Decision-1。
而国产模型大厂中,只有阿里云上架了 decision-model-preview,尚处于限时免费阶段。
单看这个对比,结论是国产模型又慢了一步。但爱分析认为, 国产模型大厂暂时不选择跟进是理性的决策。
01 Jev创新了什么?
首先,来看下 Jev代表的决策模型是什么。
比如,一条客户投诉工单进来,需要判断三件事。工单该转给哪个部门?工单紧急度如何?客户要不要退款?专门做这三次微小判断的模型,就是决策模型。这三个判断,共享一个输入的上下文,且只需要输出明确的判定结果,无需完整的推理过程和自然语言形式的回答。
由于判断的输出特点,导致用目前的大语言模型作答,会存在以下三个问题。
第一是,输出速度慢。 大语言 模型输出时的答案必须一个 token一个token往外吐,每个token依赖前一个,这导致输出速度缓慢。
第二是,决策成本高。 大语言 模型每次输出都生成一段带解释的文本,但实际决策结果并不需要这些解释文本,导致决策过程中产生很多冗余成本。特别是 大语言 模型生成每个 token,都需要重新调用一次上下文,所以输出价格普遍比输入价格贵很多,这进一步推高了决策成本。
第三是,决策结果不可靠。 从大语言 模型 输出的文本转换到决策所需要的判定结果过程中,可能发生结构违规,也就是格式跑偏。根据公开实测,在 无约束的情况下,大参数模型发生违规的概率约 6%、小参数模型18%。
在 Agent执行长程任务过程中,这种微小的判断,可能要发生成百上千次。上述三个问题,经过成百上千次放大,会在速度、成本、结果三个层面都发生重大偏差。
因此,专门有一类模型为解决这些问题而生。以 Jev为例,输入侧模型接收一段上下文和一组问题,每个问题带若干固定选项,输出侧模型只需一次计算,对每个问题返回落在选项上的概率分布和置信度,不返回任何文字。
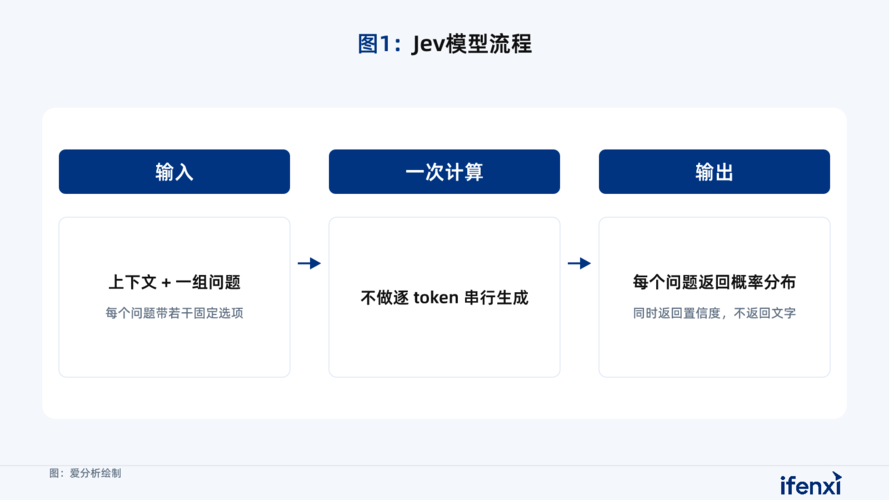
图 1:Jev模型流程
实测中, Jev大幅提升了性能表现,官方口径比大语言模型速度快了193.6x,成本低了444.6x,而且从架构层面杜绝了结构违规的问题。
业界将这类模型,定义为类型化决策模型( Typed Decision Model,以下简称 TDM)。TDM并非Jev创造的新模型品类,其历史可以追溯至早年的Bert分类器。
基于爱分析与行业专家交流, Jev的技术创新不算复杂,但通过工程化,在速度与成本层面做到了很好。在海外模型大厂追求AGI、追求能力突破的叙事中,Jev不争能力曲线、争成本曲线的做法属于异类。
02 海外厂商跟进动作很快
由于技术复杂度不高,跟进成本低,海外厂商跟进动作也很快。
开篇提及的微软、
AWS以及Cloudflare,都基于Qwen的小尺寸模型进行了后训练,在1个月的时间内先后推出自家的TDM。也有部分海外小厂,基于上一代Bert模型构造了新的TDM。
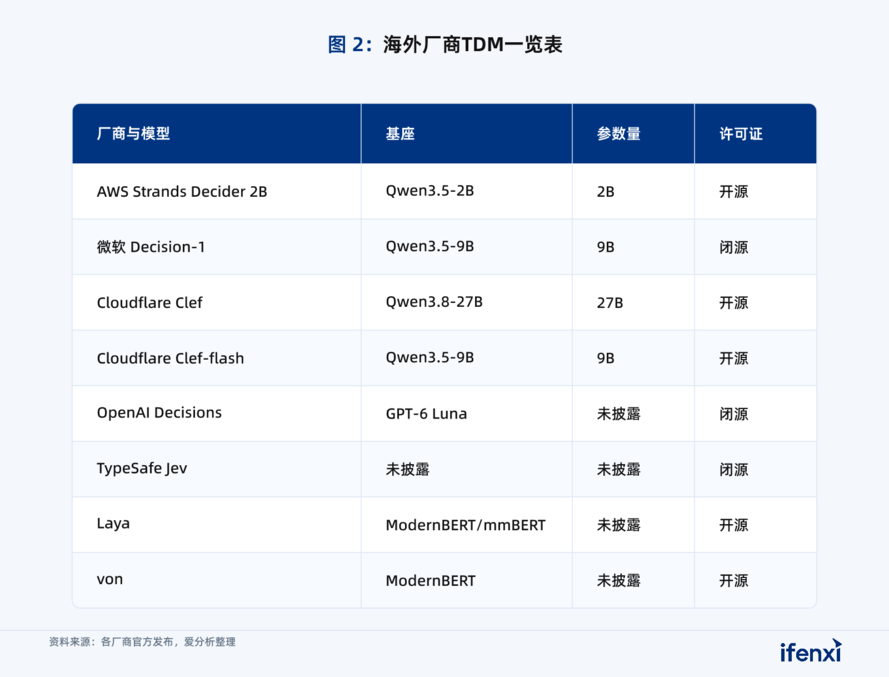
图 2:海外厂商TDM一览表
OpenAI 则完全没有做后训练,直接在小模型Luna上新增了Decisions接口,对于输出进行了约束,并针对结果返回的速度做了专门优化。OpenAI官方披露的响应速度是150毫秒,与Jev官方的114毫秒接近。
价格层面, OpenAI的定价是每百万Token输入0.1美元,输出不计费。虽然比Jev的0.042美元略高, 但 OpenAI额外支持图像输入,比Jev的纯文本输入支持模态更多。
海外厂商跟进
TDM的动机,可以归为两类。
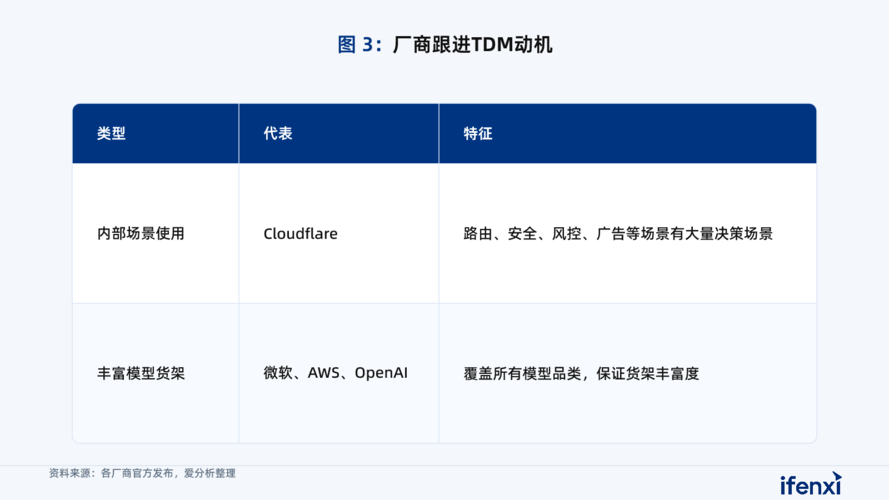
图 3:厂商跟进TDM动机
第一种动机,是内部有大量决策场景需要使用 TDM,在广告、风控等诸多场景已有大量需求与实践。
比如, Cloudflare是做CDN出身的公司,在边缘侧有大量调度、安全、内容审核等决策场景,TDM是内部使用的刚需。在过往业务中,Cloudflare也积累了大量历史决策数据。因此,Cloudflare在后训练过程中,先是使用了自身积累的真实数据,其后才使用合成数据。而Jev并没有历史场景中的决策数据积累,完全是使用合成数据进行的后训练。
第二种动机,是对外销售模型 API,货架丰富度越高越好。 为此, OpenAI等均是第一时间就在货架上补充了TDM品类。
03 国产模型跟进情况
国产模型大厂中,唯一下场的只有阿里,腾讯、字节等都没有基于内部场景使用或者丰富模型货架的动机跟进
TDM。其他跟进的,都并非头部厂商。
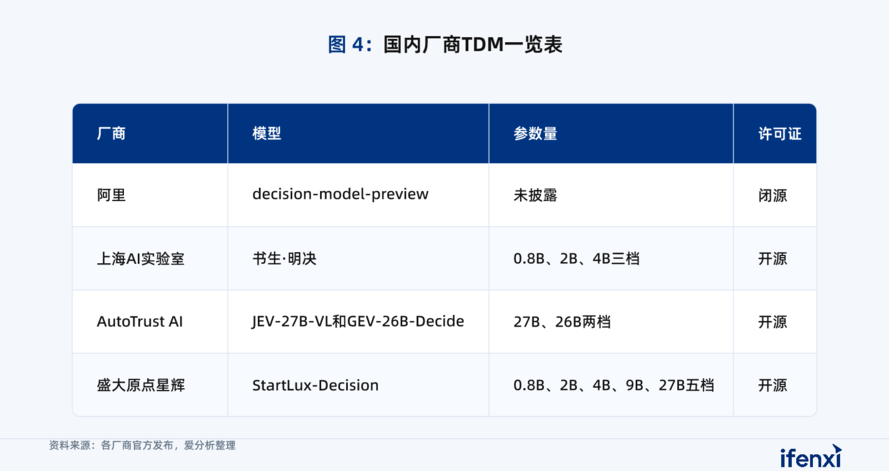 图
4:国内厂商TDM一览表
爱分析认为,国产模型大厂选择暂时不跟进并非判断失误,而是正确的抉择。
首先, TDM 撑不起一个独立品类叙事。 基于前文讨论,可以看到 TDM的技术架构复杂度并不高,因此TDM所处的层级与 embedding、reranker等模型类似,而非 与世界模型、 AI4S模型等处于同一层级。
其次, TDM不体现模型的能力上限,和AGI叙事无关。 模型 主流叙事依然在追求能力上限的突破,而非单点功能上的速度与成本。 TDM在能力突破上,并没有变化。独立复现显示,TDM与前沿模型在同一任务上的准确率是67.8% vs. 67.9%,差异可忽略不计。
第三,国内大厂已有的决策模型够用,换新没有增量。 腾讯、字节等大厂内部场景中,广告、风控、网关路由等场景非常多,已经构造出表现优异的决策系统,也就是不止一个 TDM,而是多个TDM串联,保证决策误判率在1‰甚至更低。因此,这些大厂换新动力不强。
基于上述原因,国产模型对于跟进 TDM没有很强意愿,也就容易理解了。
但是,如果 TDM只是很小的模型品类,Jev背后的TypeSafe为何A轮投后估值达到75亿美元?
根据创始人 Diogo Almeida的公开发言,TypeSafe计划打造一套for机器、软件、Agent的模型家族,让软件直接可以消费模型输出,而不是让人去读。也就是说, TypeSafe的愿景是构建一套与OpenAI、Anthropic平行的机器原生模型。
Jev把模型输出从自然语言换成类型化决策,但Jev仅仅是模型家族的第一环而已,上面还有很多层模型要构建。Almeida甚至并不接受决策模型或者TDM这个分类。他的说法是,机器原生模型里未来还会有不解决决策问题的类型。
TypeSafe真正要做的事比TDM大得多。TypeSafe 的官方表述是让智能可组合,让软件直接消费模型输出,而不是让人去读。公司那份 manifesto 标题就叫《造产品,不是造神》。被问是否要做前沿实验室时,Almeida 的回答是,前沿实验室的主要产品是恐惧和炒作,他希望 TypeSafe 的产品是智能。
从这个角度来看,模型大厂并不知道 Jev之后是什么,在一个终点还没被描述的赛道,跟进者不知道该跟到什么位置,也就很难下注。
因此,模型大厂并不是不想跟进,只是还看不清楚、尚未下手。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69993021/viewspace-3185712/ ,如需转载,请注明出处,否则将追究法律责任。

