作为第一步,从一个不包含协变量的空模型开始。

每所学校的截距,β 0J,然后设置为平均,γ 00,和随机误差ü 0J。

将(2)代入(1)产生

要在SPSS中进行估算,请转至
分析→混合模型→线性...

出现“
指定主题”和“重复”菜单。在此示例中,分组变量是id,因此应将其放在“
主题”框中。
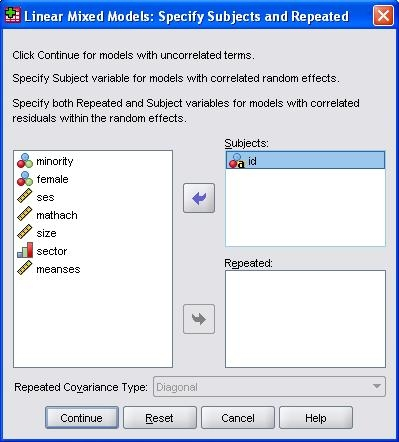
在
反复框保持为空。它仅在分析人员想要为重复测量指定协方差模式时使用 。单击
继续。
弹出一个新菜单,用于指定模型中的变量。空模型没有自变量,因此将因变量mathach放在适当的框中。
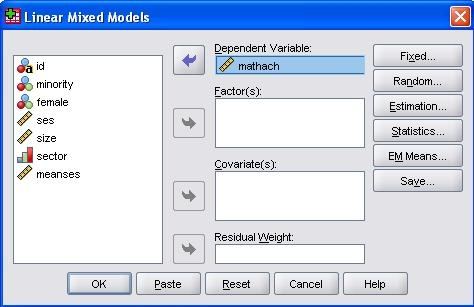
空模型中的截距被视为随机变化。这不是默认设置,因此单击“
随机”以获取以下菜单:
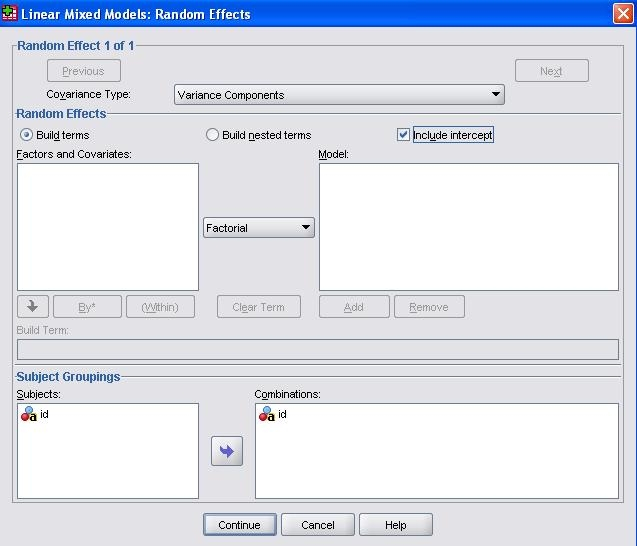
检查“
包含截距”选项。另外,将id变量带到
组合框中。的
协方差类型无关时,只有一个随机效应,在这种情况下,随机截距。单击
继续。
接下来,单击
Statistics以选择其他菜单以选择在输出中报告哪些结果。
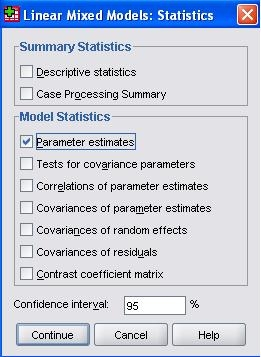
选择
参数估计值以报告固定效应的估计值。单击
继续,然后
单击确定。部分结果如下:
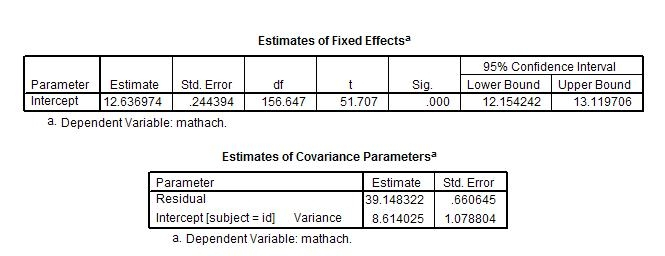
这些结果对应于R&B中的表4.2。
下一步是估计一种平均数- 结果模型。
平均数之结果变项的回归模型
在估计空模型之后,R&B开发了一种“平均数结果变项的回归”模型,其中将学校级变量meanses添加到截距模型中。该变量反映了每所学校的学生SES平均水平。方程式(1):

截距可以模拟成一个大平均γ 00,再加上平均得分SES的效应γ 01,加上随机误差ü 0J。
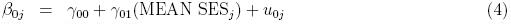
将(4)代入(1)得到
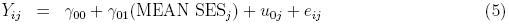
要在SPSS估计这个,再去
分析→混合模型→直线...。再次出现“
指定主题”和“重复菜单 ”。将id放在“
主题”框中,并将“
重复”框保留为空。
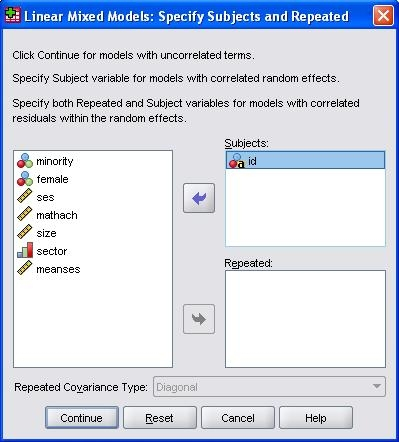
单击
继续。在下一个菜单中,指定依赖变量和独立变量。因变量将是mathach,单个协变量将是均值。
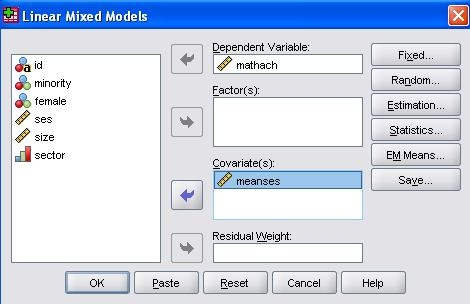
该meanses变量输入作为固定效应,所以点击
固定按钮拉起
固定效应菜单。将meanses变量带入
Model框并确保选中
Include Intercept。
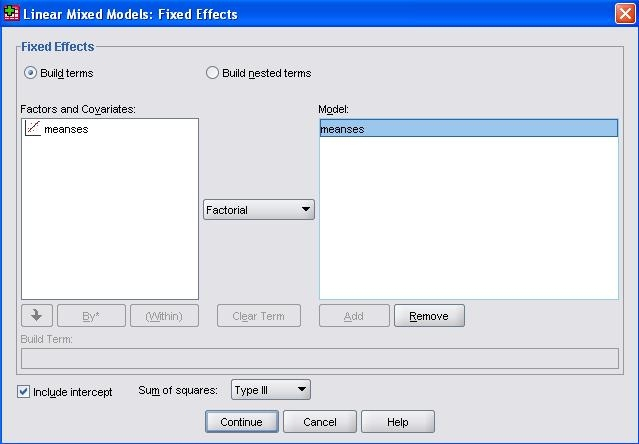
单击
继续。接下来,单击“
随机”以打开“
随机效应
”菜单。选中“
包括截距”以将截距指定为随机,并将分组变量id放在“
组合”框中。它仅被视为固定效应。该
协方差类型又是无关紧要,因为只有一个随机效应,随机截距。
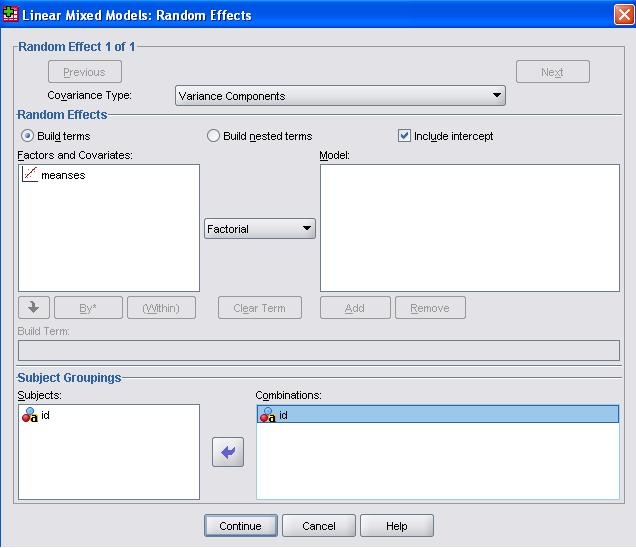
最后,单击
Statistics以选择在输出中报告的内容。选中
参数估计值旁边的复选框。
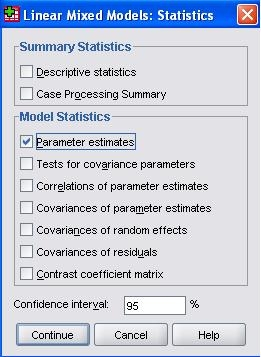
单击
继续,然后
单击确定。输出的一部分如下:
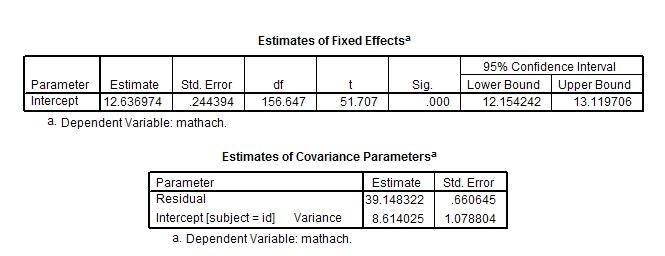
这与R&B中的表4.3相对应。
下一步是估计随机系数模型。
随机系数模型
接下来,R&B提供了一个模型,其中包括学生级别的SES而不是平均SES,并且他们将学生SES的斜率视为随机的。一个复杂因素是R&B以小组平均为中心的学生SES后呈现结果。群体平均中心意味着从每个学生的个人SES中减去每个学生的学校的平均SES。不幸的是,meanses变量编码为-1,0,1,因此只是每个学校平均值的粗略指标。为了更好地估计学校平均值,可以利用SPSS 中的
Aggregate命令。
分组中心变量的第一步是找到每个群集的平均值。转到
数据→聚合
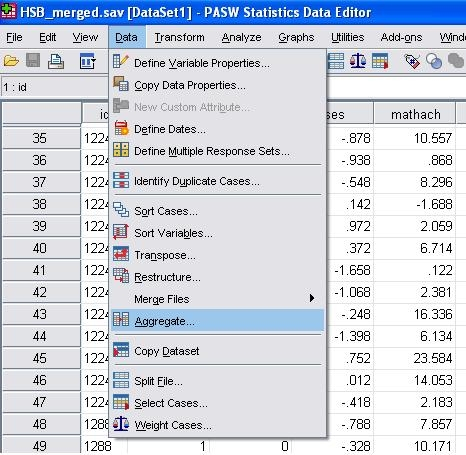
出现“
聚合数据”菜单。表示每个组的变量称为“中断”变量; 将id放入
Break Variable(s)框中。目标是从每所学校获得学生的平均SES分数,因此将ses变量带到“ 变量
摘要”框中。默认情况下,SPSS假定用户有兴趣获取每个组的均值,因此无需更改功能。最后,确保选中“
将聚合变量添加到活动数据集”单选按钮。
现在,数据中添加了一个新变量ses_mean(不要与三分法混淆)。要完成组平均居中,请从每个ses变量中减去ses_mean。转到
变换→计算变量。
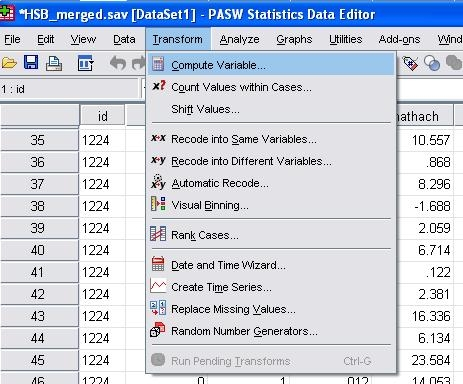
在出现的菜单中,创建一个名为grp_ses的
目标变量,该
变量等于ses减去ses_mean。
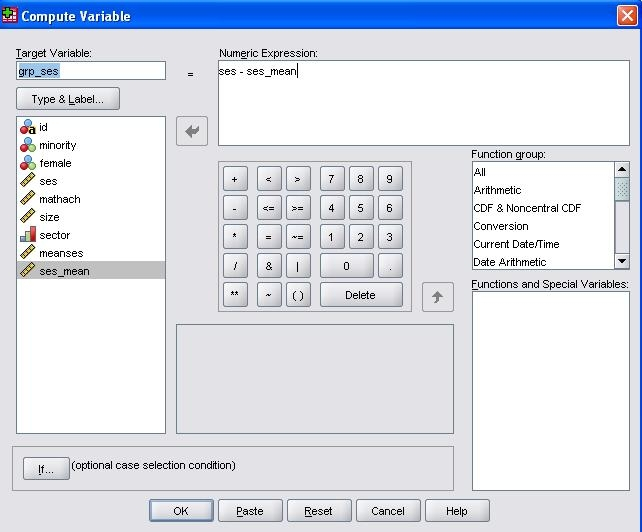
单击
确定。现在可以使用以组为中心的SES变量。
1级方程式如下:

截距β 0J可以模拟成一个大平均γ 00加上随机误差,ü 0J。类似地,倾斜β 1J可以被建模为具有总平均值γ 10加上随机误差Ú 1J。

将(7)和(8)组合成(6)产生:
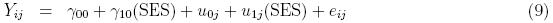
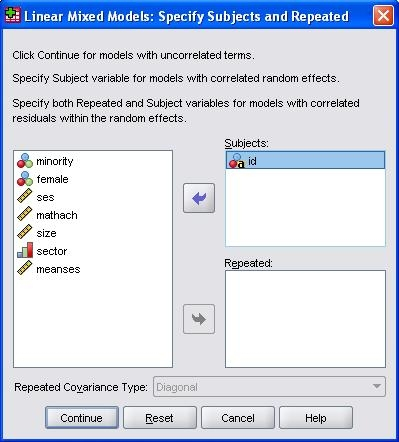
要在SPSS中估算(9),请转到
分析→混合模型→线性。再次出现“
指定主题”和“重复”菜单。和以前一样,将id放在“
主题”框中,并将“
重复”留空。
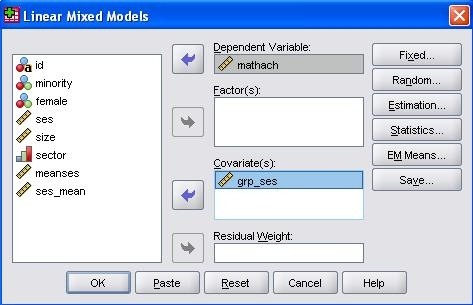
单击
继续。在下一个菜单中,指定依赖变量和独立变量。因变量是mathach,单个协变量将是grp_ses。
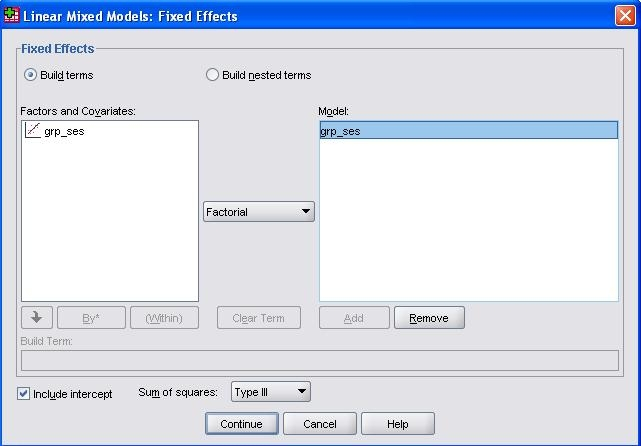
要指定模型的固定效应,请单击“
固定”。在“
固定效应
”菜单中,将grp_ses变量置于“
模型”框中,并确保选中“
包括截距”。
单击
继续,然后单击
随机。
在“
随机效应
”菜单中,将分组变量id放在“
组合”框中。此外,因为grp_ses将具有随机斜率,所以必须将其放置在“
模型”框中。接下来,确保选中
Include Intercept,以便允许截距随机变化。最后,存在两个随机效应意味着协方差矩阵
G的维数现在是2×2。SPSS中的默认值是假设一个方差分量结构,这意味着随机截距和随机斜率之间没有协方差(参见随机效应ANOVA模型综述中的协方差结构表))。可以放宽该假设,使得协方差是从数据估计的自由参数。为
协方差类型指定
Unstructured。
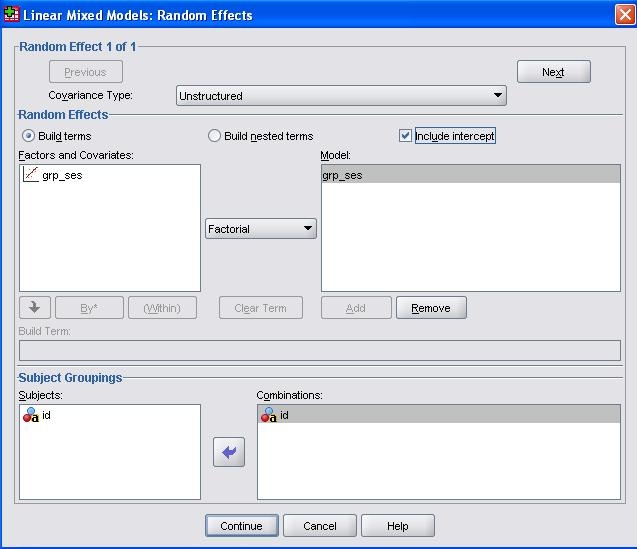
单击
继续。然后单击“
统计”以指定输出中显示的内容。检查
参数估计值以获得固定效应的结果。
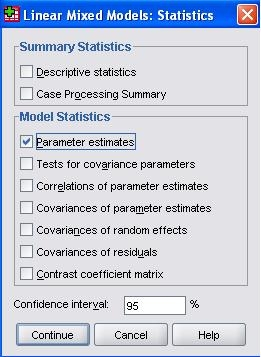
单击
继续,然后
单击确定。部分结果如下:
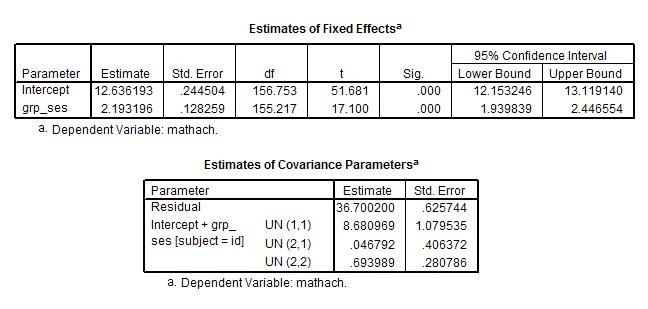
这些结果对应于R&B中的表4.4。
最终的模型R&B呈现的是截距和斜率外部模型。
非常感谢您阅读本文,有任何问题请在下方留言!
参考文献
1.
用SPSS估计HLM层次线性模型模型
2.
R语言线性判别分析(LDA),二次判别分析(QDA)和正则判别分析(RDA)
3.
基于R语言的lmer混合线性回归模型
4.
R语言Gibbs抽样的贝叶斯简单线性回归仿真分析
5.
在r语言中使用GAM(广义相加模型)进行电力负荷时间序列分析
6.
使用SAS,Stata,HLM,R,SPSS和Mplus的分层线性模型HLM
7.
R语言中的岭回归、套索回归、主成分回归:线性模型选择和正则化
8.
R语言用线性回归模型预测空气质量臭氧数据
9.
R语言分层线性模型案例
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69982319/viewspace-2728988/
,如需转载,请注明出处,否则将追究法律责任。

