oracle执行计划访问路径详解,优化小白必看
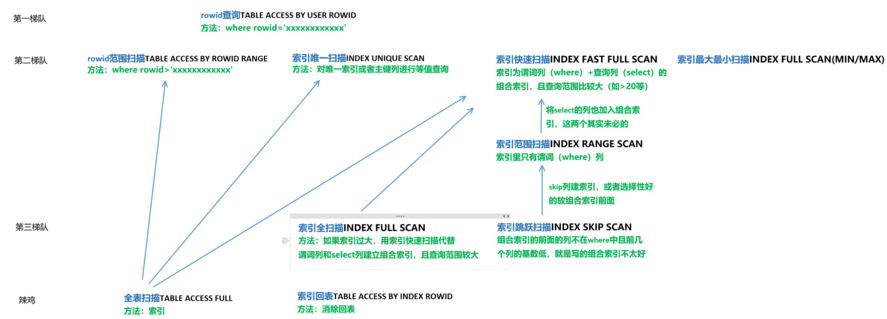
1.全表扫描
TABLE ACCESS FULL
多块读
优化方式:
前面带*,有谓词。访问的列少的话,存在多个谓词过滤条件(where),创建组合索引,选择性高的放前面,顺序排放
2.rowid查询
使用rowid获取数据,单块读,性能最好
TABLE ACCESS BY USER ROWID

产生原因:
对rowid进行等值查询
where rowid='xxxxxxxxxxxx'
优化方式:
无需优化,已经无敌
3.rowid范围扫描
rowid范围扫描,多块读
TABLE ACCESS BY ROWID RANGE

产生原因:
对rowid进行范围选择(= > < 等等)
where rowid>'xxxxxxxxxxxxx';
优化方式:
应该也是无解的
4.索引回表
索引回表,单块读
TABLE ACCESS BY INDEX ROWID
产生原因:
索引不包含全部的要查询的列,导致部分值可索引中快速查找到,部分列要根据rowid查找到。
索引(a,b) c需要根据rowid查找
select a,b,c from table;
优化方式:
列都在索引里,不会产生回表,也是去除回表的方法
往往建立合适的组合索引来消除回表,或者尽量减少回表次数
如果回表行数少,可不创建索引
5.索引 unique扫描
索引unique扫描,单块读
INDEX UNIQUE SCAN

性能仅次于 TABLE ACCESS BY USER ROWID
产生原因:
对unique index或者主键列进行等值查询
优化方式:
无解,很快了
6.索引范围扫描
单块读,返回数据是有序的,默认升序
INDEX RANGE SCAN
索引降序范围扫描
INDEX RANGE SCAN DECENDING
等待事件为db file sequential read
产生原因:
对索引,主键进行范围查找
优化方式:
不错了,如果有伴随着回表,就将查询的列也加入索引,建立组合索引,如果查询范围是大的就会消除掉回表并从
INDEX RANGE SCAN 变为 INDEX FAST FULL SCAN,如果范围小的就会只消除掉回
例子:
索引为id
Select name from test where id<100;
改为
索引为id,name
Select name from test where id<100;
Select name from test where id>100;(因为一般情况下>100的范围很大)
7.索引跳跃扫描
单块读
INDEX SKIP SCAN
产生原因:
组合索引的前面的列不在where中且前几个列的基数低
个人理解:
就是组合索引写的不好,where谓词的列没写在前头,选择性高的没写在前头,要么是写个好点的
组合索引(我的想法),要么直接skip的列直接建一个索引(书上说法,让 INDEX RANGE SCAN[索引范围扫描]
代替 INDEX SKIP SCAN[索引跳跃扫描])
等待事件为db file sequential read
优化方式:
从 INDEX SKIP SCAN改为 INDEX RANGE SCAN
优化之前的组合索引或者直接skip的列创建一个索引

8.索引全扫描
单块读,返回数据有序,默认升序。索引如果大,可能产生性能问题,因为单块读。
INDEX FULL SCAN
等待事件为db file sequential read
产生原因:
1.分页语句(??后续)
2.ordey by的列全包含在索引中,并且order by的顺序要和组合索引里的顺序一致,order by的第一列不能有
过滤条件(where),如果有就会走 INDEX RANGE SCAN[索引范围扫描],同时表的数据量不能太大,太大会
走TABLE ACCESS FULL[全表扫描]+SORT ORDER BY[为知]
优化方式:
看到 INDEX FULL SCAN[索引全扫描]先看是否有回表:
如果没有回表,看索引大小,如果过大(GB级别),用 INDEX FAST FULL SCAN[索引快速全扫描]代替
INDEX FULL SCAN [索引全扫描],因为 INDEX FULL SCAN是单块读, INDEX FAST FULL SCAN是多块
读,即使 INDEX FAST FULL SCAN会产生额外的排序也要用
如果有回表,大多数情况,执行计划是错误的,因为回表是单块读,索引全扫描也是单块读。这时候应该会
走 TABLE ACCESS FULL[全表扫描]
查看表所在的表空间
select OWNER,TABLE_NAME,TABLESPACE_NAME from dba_tables where TABLE_NAME='EMPLOYEE';
查看索引大小
SELECT t.owner, t.segment_name,SEGMENT_TYPE,SUM(bytes)/1024/1024 M From dba_segments t
WHERE SEGMENT_TYPE='INDEX' and t.tablespace_name = 'USERS' and t.owner='DEF'
GROUP BY t.owner,t.segment_name,SEGMENT_TYPE
ORDER BY M desc;

9.索引快速全扫描
多块读,并且可以并行扫描,索引快速全扫描
INDEX FAST FULL SCAN
当表中出现查询大量数据,只需要获取部分列
等待事件为db file scattered read,若并行扫描,等待为direct path read
产生原因:
索引为谓词列(where)+查询列(select)的组合索引,且查询范围比较大(如>20等),用来代替
TABLE ACCESS FULL [全表扫描]或者 INDEX RANGE SCAN[索引范围扫描]
优化方式:
用来代替 TABLE ACCESS FULL[全表扫描]
挺好的。索引为谓词列(where)+查询列(select)的组合索引,且查询范围比较大(如>20等)
10.索引最小值最大值扫描
单块读,性能与 index unique scan相同,仅次于 TABLE ACCESS BY USER ROWID
INDEX FULL SCAN(MIN/MAX)
产生原因:
select max(column) from table 或者 select min(column) from table
优化方式:
已经很好了
如果同时要最大和最小
select max(name_id),min(name_id) from abc;
可以改为(性能大大提升)
select (select max(name_id) from abc),(select min(name_id) from abc) from dual;
11.MAT_VIEW REWRITE ACCESS FULL
创建物化视图后,查询
产生原因:
创建物化视图

select object_id,object_name from test;
因为此查询的列和表已经建了物化视图,所以会直接去物化视图里查询,

优化方式:
不错了
本文从Oracle内核技术揭秘_吕海波中理解
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69980685/viewspace-3005222/ ,如需转载,请注明出处,否则将追究法律责任。

