oracle一次卡顿案例(四)
图片水印为本人在csdn账号
故障描述
2023年09月14号 9:33左右,客户反馈his数据库可能存在问题,当时数据库可以使用,应用比较缓慢。让检查数据库是否存在问题。
排查过程中,业务那边反馈问题从8点左右就开始,应用页面报错如下图所示:
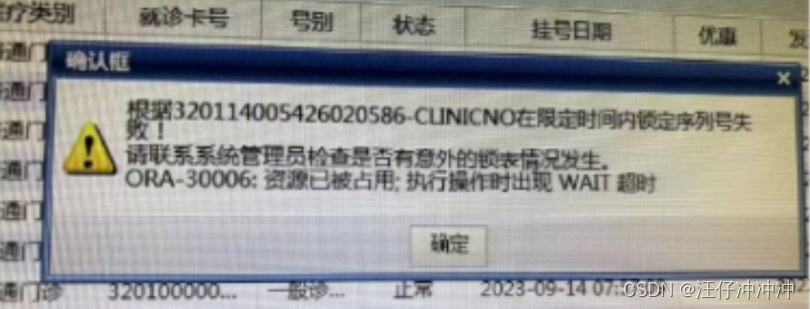
原因分析-ORA-30006
应用页面报ORA-30006错误,检查早上8:00左右会话情况,会话执行下面的语句被阻塞的比较多。
SELECT * FROM COM_SEQUENCE t WHERE T.ID = :1 FOR UPDATE WAIT 5
只要持有这条WHERE T.ID = :1 记录的会话事务没有结束,那么其他会话执行上面的语句,等待5秒,就会报这个错。
这个很明显是业务里面的事务没有及时提交导致的。
原因分析-row cache lock
检查8点左右的业务会话,发现会话不多,同一个时间点只有1,2个活动的业务会话。
检查当时的等待事件结果如下:

检查row cache lock等待事件:
Select a.*
from ash_temp2 a
where a.sample_time > to_date('2023-09-14 08:00:00', 'yyyy-mm-dd hh24:mi:ss')
and a.sample_time < to_date('2023-09-14 09:30:00', 'yyyy-mm-dd hh24:mi:ss')
and SESSION_TYPE<>'BACKGROUND' and a.WAIT_CLASS<>'Idle'
and event='row cache lock'
order by a.sample_time;
检查发现,row cache lock等待事件的P1参数为13。
检查争用的类型,发现都是序列的争用:
SQL> select parameter from v$rowcache where cache#=13;
PARAMETER
--------------------------------
dc_sequences;
检查sql发现,主要集中在下面的sql:
9zydhubnyc1v0:
SELECT SEQ_LSH.NEXTVAL FROM DUAL WHERE :1 = :2
8mzhcp786symv:
SELECT B32011400642602056X.Nextval FROM DUAL
dayjkkmjpuvww:
SELECT B320114001426020535.Nextval FROM DUAL
……
检查序列情况:

发现cache_size为0,这个数值过小,在高并发的环境下,很容易造成性能问题,建议调整这些序列尤其是SEQ_LSH 序列的cache size。
应用人员在10点左右发现数据库不可用,无法连接。在服务器上面通过sqlplus也无法登录数据库。
临时的解决方法,杀掉所有的业务会话解决。
事后检查当时的等待事件:

关于latch: shared pool等待事件:oracle为了分配共享池,多个会话执行sql解析需要分配到chunk时,为了获得的shared pool latch发生争用,常见于并发会话比较高或者硬解析比较多的场景,也就是说在获得shared poollatch过程中发生争用,则等待latch: shared pool事件。
检查会话发现,这些会话执行的sql同row cache lock等待事件会话的sql基本一样,也就是说,一个会话交替出现,所以这个2个等待事件可以看成是一个问题。
关于library cache: mutex X:在 library cache 中有许多内存结构需要 library cache: mutex X 的保护,每当 library cache mutex由会话以独占模式保持并且其他会话需要等待它被释放时,就会出现此等待事件。
检查会话发现,这些会话执行的sql并没有高版本的情况而且数据库整体硬解析不高,所以可以判断这些会话没有问题。而且这个等待事件相关的bug也比较多,可以作为后面的分析方向。
解决办法和建议
1. COM_SEQUENCE表相关的业务,建议及时进行提交,可以解决应用页面ORA-30006的问题。
2. 要彻底解决row cache lock异常等待的问题,建议调整这些序列的cache size,建议从0调整到1000-5000,如果数据库重启或者遇到异常,cache可能会丢失,建议业务进行评估。
3. 检查过程中发现,发现shared pool 设置不太合理,建议调大共享池大小,在现有的基础上增加至少10G。
4. 服务器剩余的内存比较小,集群上面还有一个实例mdm,这个实例占用的内存比较多,如果不需要可以考虑关闭。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69980685/viewspace-3003371/ ,如需转载,请注明出处,否则将追究法律责任。

